云计算 Twitter 语料分析 5 ETL 导入数据
本页目录
这一次我们需要利用 Map Reduce 处理大约 1T 的 Twitter 数据,并导入到对应的数据库中,这一部分因为奇奇怪怪的情况很多,所以一定要注意。
数据处理
这一部分主要是写一个 mapper 和 reducer,把原始数据的 json 格式处理成我们需要的格式(也就是下一步中我们需要返回的内容)。
在决定具体需要获取什么内容之前,我们先来看看原始数据的结构。老师提供的数据地址是 s3://cmucc-datasets/twitter/s16/part-00XXX,我们可以直接用浏览器下载一个试试看,下载地址是 http://s3.amazonaws.com/cmucc-datasets/twitter/s16/part-00000(具体的转换过程可见参考资料)
下载完成之后发现有差不多 2G,我们在本地只是做一下测试当然用不着这么多数据,所以用下面的命令拆出来几个子集:
head -n 100 part-00000 > data100
head -n 1000 part-00000 > data1K
head -n 10000 part-00000 > data10K
然后我们输出一行来看一下,很长,如下
{"created_at":"Thu May 15 09:02:20 +0000 2014","id":466866157933182977,"id_str":"466866157933182977","text":"RT @Xxxshota7xxx: \u3010\u885d\u6483\u6620\u50cf\u3011\n\u30d0\u30e9\u30a8\u30c6\u30a3\u756a\u7d44\u3067\u30d0\u30a4\u30ad\u30f3\u30b0\u30fb\u5c0f\u5ce0\u306b\n\u4ed5\u639b\u3051\u305f\u30c9\u30c3\u30ad\u30ea\u304c\u9177\u3059\u304e\u3066\u5927\u708e\u4e0awww\n\n\u52d5\u753b\u306f\u3053\u3061\u3089\u21d2http:\/\/t.co\/DFtzc8nOcN\n\n\u4e2d\u5c45\u304f\u3093\u6016\u3059\u304e\u30ef\u30ed\u30bfww http:\/\/t.co\/Zph8jC6QzY","source":"\u003ca href=\"http:\/\/yahoo.co.jp\" rel=\"nofollow\"\u003e\u3010\u7f8e\u4eba\u3011 \u60a9\u6bba\u7387100\uff05\u3067\u4eba\u6c17\u8870\u3048\u305a\uff01\u003c\/a\u003e","truncated":false,"in_reply_to_status_id":null,"in_reply_to_status_id_str":null,"in_reply_to_user_id":null,"in_reply_to_user_id_str":null,"in_reply_to_screen_name":null,"user":{"id":1391544108,"id_str":"1391544108","name":"v.i.p ryokun","screen_name":"ryoryoryoryo10","location":"\u26612013.06.29\u301c m.love\u2026\u2661","url":null,"description":"Osaka Nishiyodogawa 17age Follow me Utajima 65th\u261eKitayodo51th","protected":false,"followers_count":814,"friends_count":689,"listed_count":1,"created_at":"Tue Apr 30 08:53:33 +0000 2013","favourites_count":838,"utc_offset":null,"time_zone":null,"geo_enabled":true,"verified":false,"statuses_count":9828,"lang":"ja","contributors_enabled":false,"is_translator":false,"is_translation_enabled":false,"profile_background_color":"C0DEED","profile_background_image_url":"http:\/\/abs.twimg.com\/images\/themes\/theme1\/bg.png","profile_background_image_url_https":"https:\/\/abs.twimg.com\/images\/themes\/theme1\/bg.png","profile_background_tile":false,"profile_image_url":"http:\/\/pbs.twimg.com\/profile_images\/464402846293573632\/iDbrYwVz_normal.jpeg","profile_image_url_https":"https:\/\/pbs.twimg.com\/profile_images\/464402846293573632\/iDbrYwVz_normal.jpeg","profile_banner_url":"https:\/\/pbs.twimg.com\/profile_banners\/1391544108\/1398871213","profile_link_color":"0084B4","profile_sidebar_border_color":"C0DEED","profile_sidebar_fill_color":"DDEEF6","profile_text_color":"333333","profile_use_background_image":true,"default_profile":true,"default_profile_image":false,"following":null,"follow_request_sent":null,"notifications":null},"geo":null,"coordinates":null,"place":null,"contributors":null,"retweeted_status":{"created_at":"Thu May 15 07:43:29 +0000 2014","id":466846313691115520,"id_str":"466846313691115520","text":"\u3010\u885d\u6483\u6620\u50cf\u3011\n\u30d0\u30e9\u30a8\u30c6\u30a3\u756a\u7d44\u3067\u30d0\u30a4\u30ad\u30f3\u30b0\u30fb\u5c0f\u5ce0\u306b\n\u4ed5\u639b\u3051\u305f\u30c9\u30c3\u30ad\u30ea\u304c\u9177\u3059\u304e\u3066\u5927\u708e\u4e0awww\n\n\u52d5\u753b\u306f\u3053\u3061\u3089\u21d2http:\/\/t.co\/DFtzc8nOcN\n\n\u4e2d\u5c45\u304f\u3093\u6016\u3059\u304e\u30ef\u30ed\u30bfww http:\/\/t.co\/Zph8jC6QzY","source":"\u003ca href=\"http:\/\/yahoo.co.jp\" rel=\"nofollow\"\u003e\u30d0\u30a4\u30ad\u30f3\u30b0\u30fb\u5c0f\u5ce0\u306b \u4ed5\u639b\u3051\u305f\u30c9\u30c3\u30ad\u30ea\u003c\/a\u003e","truncated":false,"in_reply_to_status_id":null,"in_reply_to_status_id_str":null,"in_reply_to_user_id":null,"in_reply_to_user_id_str":null,"in_reply_to_screen_name":null,"user":{"id":962038489,"id_str":"962038489","name":"\u3057\u3087\u30fc\u305f","screen_name":"Xxxshota7xxx","location":"\u5bcc\u7530\u6797","url":null,"description":null,"protected":false,"followers_count":194,"friends_count":156,"listed_count":0,"created_at":"Wed Nov 21 08:46:53 +0000 2012","favourites_count":347,"utc_offset":null,"time_zone":null,"geo_enabled":false,"verified":false,"statuses_count":2913,"lang":"ja","contributors_enabled":false,"is_translator":false,"is_translation_enabled":false,"profile_background_color":"C0DEED","profile_background_image_url":"http:\/\/abs.twimg.com\/images\/themes\/theme1\/bg.png","profile_background_image_url_https":"https:\/\/abs.twimg.com\/images\/themes\/theme1\/bg.png","profile_background_tile":false,"profile_image_url":"http:\/\/pbs.twimg.com\/profile_images\/378800000718547747\/89daed934729b4744480381a59081425_normal.jpeg","profile_image_url_https":"https:\/\/pbs.twimg.com\/profile_images\/378800000718547747\/89daed934729b4744480381a59081425_normal.jpeg","profile_banner_url":"https:\/\/pbs.twimg.com\/profile_banners\/962038489\/1387966350","profile_link_color":"0084B4","profile_sidebar_border_color":"C0DEED","profile_sidebar_fill_color":"DDEEF6","profile_text_color":"333333","profile_use_background_image":true,"default_profile":true,"default_profile_image":false,"following":null,"follow_request_sent":null,"notifications":null},"geo":null,"coordinates":null,"place":null,"contributors":null,"retweet_count":402,"favorite_count":0,"entities":{"hashtags":[],"symbols":[],"urls":[{"url":"http:\/\/t.co\/DFtzc8nOcN","expanded_url":"http:\/\/tinyurl.com\/lnpfgjb","display_url":"tinyurl.com\/lnpfgjb","indices":[53,75]}],"user_mentions":[],"media":[{"id":466846313540116480,"id_str":"466846313540116480","indices":[90,112],"media_url":"http:\/\/pbs.twimg.com\/media\/BnqSP6tCYAAt8C2.jpg","media_url_https":"https:\/\/pbs.twimg.com\/media\/BnqSP6tCYAAt8C2.jpg","url":"http:\/\/t.co\/Zph8jC6QzY","display_url":"pic.twitter.com\/Zph8jC6QzY","expanded_url":"http:\/\/twitter.com\/Xxxshota7xxx\/status\/466846313691115520\/photo\/1","type":"photo","sizes":{"large":{"w":610,"h":343,"resize":"fit"},"thumb":{"w":150,"h":150,"resize":"crop"},"small":{"w":339,"h":191,"resize":"fit"},"medium":{"w":599,"h":337,"resize":"fit"}}}]},"favorited":false,"retweeted":false,"possibly_sensitive":false,"lang":"ja"},"retweet_count":0,"favorite_count":0,"entities":{"hashtags":[],"symbols":[],"urls":[{"url":"http:\/\/t.co\/DFtzc8nOcN","expanded_url":"http:\/\/tinyurl.com\/lnpfgjb","display_url":"tinyurl.com\/lnpfgjb","indices":[71,93]}],"user_mentions":[{"screen_name":"Xxxshota7xxx","name":"\u3057\u3087\u30fc\u305f","id":962038489,"id_str":"962038489","indices":[3,16]}],"media":[{"id":466846313540116480,"id_str":"466846313540116480","indices":[108,130],"media_url":"http:\/\/pbs.twimg.com\/media\/BnqSP6tCYAAt8C2.jpg","media_url_https":"https:\/\/pbs.twimg.com\/media\/BnqSP6tCYAAt8C2.jpg","url":"http:\/\/t.co\/Zph8jC6QzY","display_url":"pic.twitter.com\/Zph8jC6QzY","expanded_url":"http:\/\/twitter.com\/Xxxshota7xxx\/status\/466846313691115520\/photo\/1","type":"photo","sizes":{"large":{"w":610,"h":343,"resize":"fit"},"thumb":{"w":150,"h":150,"resize":"crop"},"small":{"w":339,"h":191,"resize":"fit"},"medium":{"w":599,"h":337,"resize":"fit"}},"source_status_id":466846313691115520,"source_status_id_str":"466846313691115520"}]},"favorited":false,"retweeted":false,"possibly_sensitive":false,"lang":"ja"}
至于为什么这么长,我也不知道,具体要去问 Twitter,我们要做的就是从中挑出我们想要的信息。那么问题就来了,我们需要什么信息呢?这就要涉及到返回的数据是什么了。
我们需要做的很简单,就是返回某个用户用指定的 hashtag 发的 tweet,具体请求和响应的格式为:
请求格式
GET /q2?userid=uid&hashtag=hashtag

响应格式(如果有对应的推文)
TEAMID,TEAM_AWS_ACCOUNT_ID\n
Sentiment_density1:Tweet_time1:Tweet_id1:Cencored_text1\n
Sentiment_density2:Tweet_time2:Tweet_id2:Cencored_text2\n
Sentiment_density3:Tweet_time3:Tweet_id3:Cencored_text3\n

响应格式(如果没有对应的推文)

TEAMID,TEAM_AWS_ACCOUNT_ID\n
\n
所以从这里我们可以知道,需要从前面那一大堆数据中提取出来的数据有:
- tweet ID: 从
id或id_str中获取 - user ID: 从
user下的id或id_str中获取 - tweet Time: 从
created_at中获取 - tweet Text: 从
text中获取 - tweet Hashtag(if have): 从
entities里获取
有一些例外的情况需要过滤掉:
- tweet id 相同的行
- 无法被解析为 JSON 对象的行
id和id_str为空或者没有这两个域的行created_at、text或entities为空或者直接没有这几个域的行
还有一些需要注意的格式问题:
Tweet_time的时间格式是 format:yyyy-MM-dd HH-mm-ss (UTC time, 24-hour clock)- 在 ELT 阶段,换行符 '\n' 应该被替换成两个符号 '' + 'n',而在返回请求时需要换回来
- Tab 需要替换成空格
了解了这些,就可以开始写代码了,这里我们暂时不考虑计算情感值和过滤敏感词的问题(具体可以考虑在 Reducer 里完成,这样不给 Mapper 太大负担)。这里多说两句,因为要考虑去重,可能直觉反应(刷题刷出来的)就是用 HashSet 之类的,小数据量没问题,但是数据量一大,内存轻轻松松不够用,注意考虑下用 O(1) 的方法来去重(利用 Reducer 已经排好序的特性)
写完代码之后可以本地测试一下,这里我的代码结构是这样的:
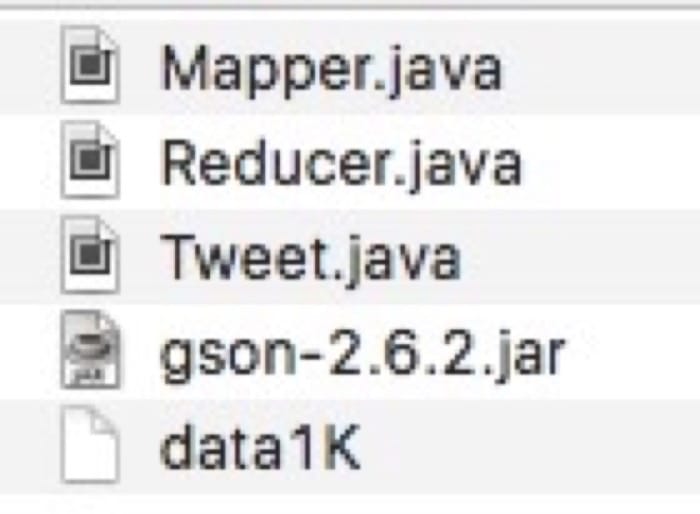
其中 gson 和 data1K 分别是解析 json 和一个一千条的小数据集。因为代码中有引用其他类与依赖,所以编译和执行的命令如下:
# 编译
$ javac Tweet.java Mapper.java -cp gson-2.6.2.jar

# 执行
$ java -cp gson-2.6.2.jar:./ Mapper
这里的 -cp 就是 classpath 的意思,这样就可以正常引用了。结果如下:
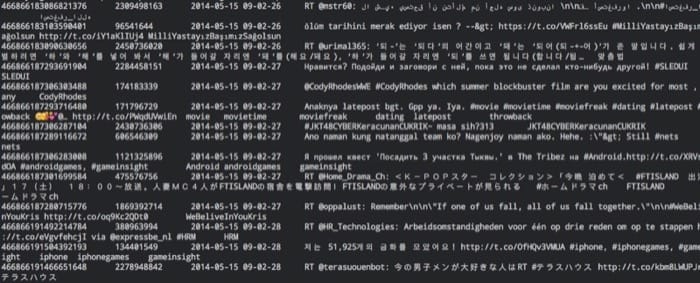
(题外话,Twitter 上的各种小黄图小黄视频多不胜数,刚上车的同学可以按图索骥)
我们可以看到,因为设置了 utf-8 编码,基本上各种乱七八糟的字符都可以正常显示。其他就是具体代码编写的细节了,这里不再赘述。
不过具体到 EMR 上跑的时候还是有些需要注意的地方:
- 用 java 1.7 编译
- 注意先用小数据集测试
- 小数据集通过测试也不代表大数据集没问题
- 具体如何使用 EMR,步骤可以参考云计算 第 10 课 Parallel Programming using EMR,这里不再赘述
处理完成数据之后记得大概查看一下有没有问题,本文暂时不涉及如何导入数据库(因为如何导入需要结合数据库的设计来弄)。
这一部分的内容有很多小的细节需要注意,大家在做的时候一定要细心(其实做任何特别耗时的工作之前都需要仔细检查)。
最后比较一下原始数据和 Mapper 之后数据的大小:
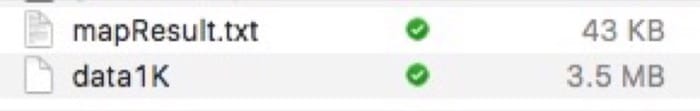
少了非常多!但是这并不意味着写代码的时候可以太任性,一定要仔细思考在大数据量时候可能出现的问题!
参考资料
相关文章
- 云计算 Twitter 语料分析 10 搭建数据分析网络应用2016-04-01
- 云计算 Twitter 语料分析 9 用 CDH 5 搭建基于 Hadoop 2.0 的 HBase2016-03-22
- 云计算 Twitter 语料分析 8 处理复杂读请求2016-03-17
- 云计算 Twitter 语料分析 7 探索 HBase2016-03-13