云计算 Twitter 语料分析 10 搭建数据分析网络应用
本页目录
这是 Twitter 语料分析的最后一个阶段,我们需要搭建一个完整的数据分析网络应用
学习目标
- 探索和使用不同的方法和工具来提高 web 服务的性能
- 拓展服务器使其可以处理不同的请求
- 开发后端服务器处理范围请求
- 开发支持写入请求的 web 服务
- 开发容错可拓展的服务
- 评估主流数据库的写入性能,并探索不同的优化技术
- 实现强一致性
- 比较不同数据库的写入性能和特点
- 分析写入操作对系统中每个组件的影响
任务目标
Q1 中我们学会了如何处理简单的并发请求。Q2 中我们结合后端(MySQL 和 HBase) 完成了简单的键值对存储和查询工作。Q3 中我们利用 MySQL 和 HBase 的特性处理更加复杂的请求。
但是之前我们处理的都是读请求,这次我们会处理大量写请求
- 只能使用 M 系列不大于 large 型号的机器
- 打标签
15619project:phase3 - 预算是 $0.85/h,按照标注计费
- 队伍的预算是
$50(包括 Live Test)
这次我们可以从 MySQL 和 HBase 中选择一个来实现(或者混合也可以)
具体的测试计划为:
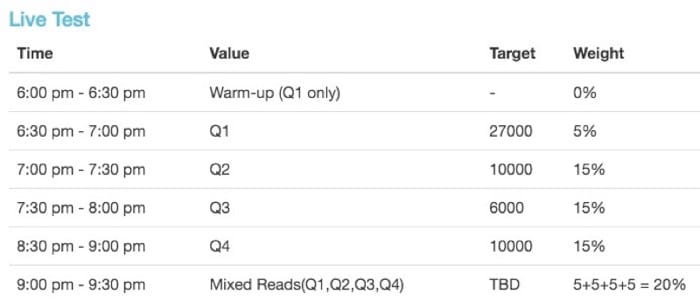
Query 4 (Tweet Server)
目标 10000 rps
给定 tweet id,我们需要处理针对一个或多个部分的 set 和 get 请求。
set 请求的格式
q4?tweetid=<tweetid>&op=set&seq=<sequence number>&fields=<comma separated list of fields>&payload=<comma separated list of base64 * encoded fields>
tweetid- 每条 tweet 的独立标识符op- 一定为 setseq- 对于某个 tweetid 的操作编号,从 1 开始,假设一个操作的编号是s,那么只有在前面s-1个操作都完成了之后,才能继续执行fields- 需要写入的部分payload- 需要写入的数据,以逗号分隔
例如:
GET /q4?tweetid=15213&op=set&seq=1&fields=repliedby,reply_count&payload=MzM2NDE5MzE2NjUsMTc0Mjg5OTA1OTksOTQ5MDczNzc5NjQsMzkzMjIxMzU4NjQsMTg0NDA4MDg5NTUsNTE2MjU1MzMxOTgsOTI4MzA3NTgwNzQ=,Nw==
响应格式
TEAMID,TEAM_AWS_ACCOUNT_ID\n
success\n
get 请求的格式
q4?tweetid=<tweetid>&op=get&seq=<sequence number>&fields=<comma separated list of fields>&payload=<empty>
tweetid- 每条 tweet 的独立标识符op- 一定为 getseq- 对于某个 tweetid 的操作编号,从 1 开始,假设一个操作的编号是s,那么只有在前面s-1个操作都完成了之后,才能继续执行fields-需要读入的部分,只会有一个部分payload- 为空
例如
GET /q4?tweetid=15213&op=get&seq=2&fields=repliedby&payload=
如果有对应的数据,响应为
TEAMID,TEAM_AWS_ACCOUNT_ID\n
MzM2NDE5MzE2NjUsMTc0Mjg5OTA1OTksOTQ5MDczNzc5NjQsMzkzMjIxMzU4NjQsMTg0NDA4MDg5NTUsNTE2MjU1MzMxOTgsOTI4MzA3NTgwNzQ=\n
如果对应 field 未空,响应为
TEAMID,TEAM_AWS_ACCOUNT_ID\n不同 field 的规格
| field | type | example |
|---|---|---|
| tweetid | long int | 15213 |
| userid | long int | 156190000001 |
| username | string | CloudComputing |
| timestamp | string | Mon Feb 15 19:19:57 2016 |
| text | string | Welcome to P4!#CC15619#P3 |
| hashtag | comma separated string | CC15619,P3 |
| ip | string | 128.2.217.13 |
| coordinates | string | -75.14310264,40.05701649 |
| repliedby | comma separated userid | 156190000001,156190000002,156190000003 |
| reply_count | long int | 3 |
| mentioned | comma separated userid | 156190000004,156190000005,156190000006 |
| mentioned_count | long int | 3 |
| favoritedby | comma separated userid | 156190000007,156190000008,156190000009 |
| favorite_count | long int | 3 |
| useragent | string | Mozilla/5.0 (iPhone; CPU iPhone OS ...) |
| filter_level | string | PG-13 |
| lang | string | American |
一些提示
- RFC 3548 定义的 Base64 在大多数编程语言中都有内置支持
- 处理请求的时候要按照 sequence number
- 数据的一致性很重要,正确率很重要
- 想想最影响性能的因素是什么,然后解决
- 最好对不同的 tweetid 进行 sharding,这样更容易维持一致性
项目日志
架构
- 前端
- ELB + 4 台 m4.large(用 slaves 同时做前端)
- 后端
- HBase(1 master + 4 slaves)
- 使用 Cloudera
具体的步骤需要参考
第一次测试
ELB + 2 m4.large + 1 master + 3 slaves
# hbase 配置
ec2-52-91-15-30.compute-1.amazonaws.com
ec2-52-91-229-223.compute-1.amazonaws.com

master ec2-52-207-240-75.compute-1.amazonaws.com

ec2-52-23-207-148.compute-1.amazonaws.com

ip-172-31-58-2.ec2.internal
ip-172-31-63-205.ec2.internal
ip-172-31-55-86.ec2.internal
ip-172-31-63-90.ec2.internal

ssh -i group.pem ubuntu@ec2-52-91-15-30.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-52-91-229-223.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-52-207-240-75.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-52-23-207-148.compute-1.amazonaws.com

# 数据导入参考 Cloudera 配置

# 测试地址
address/q1?key=40845969093821&message=URYEXYBJB
address/q2?userid=1000001233&hashtag=BabyyO
address/q3?start_date=2014-04-01&end_date=2014-05-28&start_userid=51538630&end_userid=51539182&words=u,petition,loving

scan 'q2db'
scan 'q3db',  {STARTROW => '00952122372', STOPROW => '00952124492' }

# 前端配置
ec2-54-173-74-154.compute-1.amazonaws.com
ec2-52-90-195-221.compute-1.amazonaws.com

# 更新前端
# 注意做好镜像
scp -i ../group.pem -r ./* ubuntu@ec2-54-173-74-154.compute-1.amazonaws.com:~/undertow-server/
scp -i ../group.pem -r ./* ubuntu@ec2-52-90-195-221.compute-1.amazonaws.com:~/undertow-server/

ssh -i group.pem ubuntu@ec2-54-173-74-154.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-52-90-195-221.compute-1.amazonaws.com

# 启动前端
mvn clean; mvn compile; sudo mvn exec:java
第一次测试收获:
- Q1 部分基本代码没有太大改动,单机 9000 基本没问题(运气好甚至可以到 2W+),加上 elb 应该没有太大压力
- Q2 部分代码进行了优化,正常水平在单机 4000(split 均匀之后),错误格式检查也加入了,再优化一下配合 elb 试试看
- Q3 部分代码进行了优化,估计是因为检查格式的问题导致性能有比较大影响(测试了,并不是),现在大概在单机 1200 左右徘徊,具体改进方法仍需测试
- 机器的健康状况需要注意
- HBase 数据 split 之后性能会好很多,需要一段时间等待(根据请求来 split,指标监控)
一些据(瓜瓜)说
- Base64编码一定要弄好
- Vertx 自己做 lb 性能不错
- string 和byte之间转换,decode的时候不要用Byte
第二次测试
ELB + 4 m4.large + 1 master + 4 slaves(前端在 slaves 上)
# hbase 配置

ec2-54-174-161-64.compute-1.amazonaws.com master

ec2-54-86-63-49.compute-1.amazonaws.com
ec2-54-165-177-0.compute-1.amazonaws.com
ec2-54-152-97-180.compute-1.amazonaws.com
ec2-54-152-18-227.compute-1.amazonaws.com


ssh -i group.pem ubuntu@ec2-54-174-161-64.compute-1.amazonaws.com master

ssh -i group.pem ubuntu@ec2-54-86-63-49.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-54-165-177-0.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-54-152-97-180.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-54-152-18-227.compute-1.amazonaws.com

# 数据导入参考 Cloudera 配置

# 测试地址
address/q1?key=40845969093821&message=URYEXYBJB
address/q2?userid=1000001233&hashtag=BabyyO
address/q3?start_date=2014-04-01&end_date=2014-05-28&start_userid=51538630&end_userid=51539182&words=u,petition,loving

scan 'q2db'
scan 'q3db',  {STARTROW => '00952122372', STOPROW => '00952124492' }

# 更新前端,注意做好镜像
./updatefe.sh

# 配置 Java 版本,都换成 1.7 的,因为 cloudera 会修改之前的默认配置
sudo update-alternatives --config java
sudo update-alternatives --config javac

# 启动前端,端口号也换了
mvn clean; mvn compile; mvn exec:java

# elb 地址

phase3-test-2025663654.us-east-1.elb.amazonaws.com

sudo apt-get install htop
第二次测试收获
- ELB 热机时间半个小时远远不够,提前热机吧
- 用 Slave 节点做前端效果还是可以,机器利用率比较充分
- 但是可能会对 HBase 的性能有影响,具体还需要评估
- Base64 的库,jdk1.8 和 google 的不行,用 apache 的或者
import com.sun.jersey.core.util.Base64; - Split 数据也需要比较长的时间,注意留足
- 可能还是需要前后端分开,很容易出现一台机利用率高(同时做前后端压力比较大)但其他机器不怎么在运行的状态,另外 split 分区的时候其实也不需要 4 个 region
第三次测试
ELB + 2 FE + (1+3) HBase
ec2-52-87-253-19.compute-1.amazonaws.com master
ec2-54-87-201-211.compute-1.amazonaws.com
ec2-52-91-98-143.compute-1.amazonaws.com
ec2-54-88-169-155.compute-1.amazonaws.com

ssh -i group.pem ubuntu@ec2-52-87-253-19.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-54-87-201-211.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-52-91-98-143.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-54-88-169-155.compute-1.amazonaws.com

ec2-107-23-21-131.compute-1.amazonaws.com
ec2-54-210-109-107.compute-1.amazonaws.com

ssh -i group2.pem ubuntu@ec2-107-23-21-131.compute-1.amazonaws.com
ssh -i group2.pem ubuntu@ec2-54-210-109-107.compute-1.amazonaws.com

# inverted index
hbase(main):001:0> create 'q2db', {NAME => 'data', DATA_BLOCK_ENCODING => 'FAST_DIFF', IN_MEMORY => 'true', COMPRESSION => 'SNAPPY', BLOCKCACHE => 'true'}, SPLITS=> ['1', '2', '3', '4', '5', '6', '7' , '8' , '9']

hbase(main):001:0> create 'q3db', {NAME => 'data',DATA_BLOCK_ENCODING => 'FAST_DIFF', IN_MEMORY => 'true', COMPRESSION => 'SNAPPY', BLOCKCACHE => 'true'}

# inverted index
hbase(main):001:0> create 'q4db', {NAME => 'data', DATA_BLOCK_ENCODING => 'FAST_DIFF', COMPRESSION => 'SNAPPY', IN_MEMORY => 'true', BLOCKCACHE => 'true'}, SPLITS=> ['1', '2', '3', '4', '5', '6', '7' , '8' , '9']
重洗 q2 数据
ssh -i group.pem ubuntu@ec2-54-87-214-132.compute-1.amazonaws.com

scp -i group.pem ./Wash.java ubuntu@ec2-54-87-214-132.compute-1.amazonaws.com:/mnt

javac Wash.java
java Wash

aws s3 cp ./hbasedata-inv s3://housailei15619/alloutput/

# q3
sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.bulk.output=/hfile_groupt38 -Dimporttsv.columns=HBASE_ROW_KEY,data:t q3db /housailei/csv/q3-hbase-data

// --
sudo -u hdfs hdfs dfs -chmod -R +rwx /hfile_groupt38

sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /hfile_groupt38 q3db

# q2
wget http://s3.amazonaws.com/housailei15619/alloutput/hbasedata-inv

sudo -u hdfs hadoop fs -put ./hbasedata-inv /housailei/csv/

sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.bulk.output=/hfile_groupt22 -Dimporttsv.columns=HBASE_ROW_KEY,data:t q2db /housailei/csv/hbasedata-inv

// --
sudo -u hdfs hdfs dfs -chmod -R +rwx /hfile_groupt22

sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /hfile_groupt22 q2db


mvn clean; mvn compile; sudo mvn exec:java
第三次测试收获
- q2, q4 预先 split,q3 还是根据具体的请求分布来 split
- q3 预 split 的效果并不好,还是根据具体情况来 split
Live Test
ELB + 2 FE + (1+3) HBase
# HBase 地址
# master
ec2-54-84-31-226.compute-1.amazonaws.com
172.31.39.83
# slave
ec2-52-87-152-246.compute-1.amazonaws.com
ec2-54-87-177-113.compute-1.amazonaws.com
ec2-54-152-61-115.compute-1.amazonaws.com

ssh -i group.pem ubuntu@ec2-54-84-31-226.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-52-87-152-246.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-54-87-177-113.compute-1.amazonaws.com
ssh -i group.pem ubuntu@ec2-54-152-61-115.compute-1.amazonaws.com

sudo sysctl -w vm.swappiness=0
sudo apt-get install htop
# 修改最大可打开文件数目,前后端都需要
ulimit -n 2048

# 调整一些参数
HBASE_HEAPSIZE 4000   HBase使用的 JVM 堆的大小
HBASE_OPTS  "‐server ‐XX:+UseConcMarkSweepGC"JVM GC 选项

# 这俩加起来不能超过 0.8
hbase.regionserver.global.memstore.upperLimit 0.3
hfile.block.cache.size 0.5
hbase.master.handler.count 35
hbase.regionserver.handler.count 100
hbase.hregion.max.filesize 512 MB

Java Heap Size of HBase Master in Bytes 768mb
Java Heap Size of HBase RegionServer in Bytes 2 gb


# 复制代码
# 1
scp -i group.pem -r ubuntu@ec2-52-23-179-24.compute-1.amazonaws.com:~/undertow-server/* ./frontend1
# 2
scp -i group.pem -r ubuntu@ec2-54-89-28-200.compute-1.amazonaws.com:~/undertow-server/* ./frontend2


# 新前端
phase3-live-test-909770649.us-east-1.elb.amazonaws.com
# 1
ec2-52-23-179-24.compute-1.amazonaws.com
172.31.44.202
ssh -i group.pem ubuntu@ec2-52-23-179-24.compute-1.amazonaws.com
# 2
ec2-54-89-28-200.compute-1.amazonaws.com
172.31.44.201
ssh -i group.pem ubuntu@ec2-54-89-28-200.compute-1.amazonaws.com

# 更新代码
# 1
scp -i group.pem -r ./frontend1/* ubuntu@ec2-52-23-179-24.compute-1.amazonaws.com:~/undertow-server/
# 2
scp -i group.pem -r ./frontend2/* ubuntu@ec2-54-89-28-200.compute-1.amazonaws.com:~/undertow-server/


vim src/main/java/housailei/undertow/util/HBaseUtil.java

mvn clean; mvn compile; sudo mvn exec:java- q2 不用 cache,数量过大影响性能,O(1) 是理论上的查询速度
- 解码的问题 q4,read timeout 设置
- 上过这个课的知道坑在哪里,才能避过,不然我们要如何解决自己都不知道可能会存在的问题?
相关文章
- 云计算 Twitter 语料分析 9 用 CDH 5 搭建基于 Hadoop 2.0 的 HBase2016-03-22
- 云计算 Twitter 语料分析 8 处理复杂读请求2016-03-17
- 云计算 Twitter 语料分析 7 探索 HBase2016-03-13
- 云计算 Twitter 语料分析 6 MySQL 和 HBase 配置及测试2016-03-11