云计算 Twitter 语料分析 7 探索 HBase
本页目录
优化 HBase 性能的时候遇到了诸多问题,主要原因在于对于 HBase 细节的不理解,所以要对着官方文档,仔细过一次,希望能以此找到症结所在。
HBase是一个分布式,版本化,面向列的数据库,构建在 Apache Hadoop 和 Apache ZooKeeper 之上。
就我的理解来说,Hadoop 负责做 MapReduce,ZooKeeper 负责管理整个过程。因为 Amazon EMR 只提供 0.94.18 版本的 HBase,所以这里看老一些的文档(和当前最新的有一定出入)。官方文档中写在最前面的话很好,这里引用一下:
若这是你第一次踏入分布式计算的精彩世界,你会感到这是一个有趣的年代。分布式计算是很难的,做一个分布式系统需要很多软硬件和网络的技能。你的集群可以会因为各式各样的错误发生故障。比如HBase本身的Bug,错误的配置(包括操作系统),硬件的故障(网卡和磁盘甚至内存) 如果你一直在写单机程序的话,你需要重新开始学习。
就抱着『新参者』的心态,来重新开始这次的旅程吧。
先装好 Linux(我用的是 Ubuntu 14.04,虚拟机),我习惯装下面这个插件,可以直接在右键菜单中在当前文件夹打开终端,还是比较方便的,具体安装只需:
sudo apt-get install nautilus-open-terminal
nautilus -q
快速入门 - 单机
然后我们就来安装 HBase 吧!没有 0.94.18 版本下载,所以在官网上选择了最接近的 hbase-0.94.27版本,下载完成之后解压,我就把解压后的文件夹放到 ~/ 下了。
然后需要改动 conf/hbase-site.xml,添加一个 hbase.rootdir 属性。默认 hbase.rootdir 是指向 /tmp/hbase-${user.name} ,也就说你会在重启后丢失数据(重启的时候操作系统会清理/tmp目录),这里我们改一下,放到根目录下名为 db 的文件夹下,conf/hbase-site.xml 大概像这样:
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
  <property>
    <name>hbase.rootdir</name>
    <value>file:///home/parallels/db</value>
  </property>
</configuration>
运行 HBase 需要 Java,我们需要安装并配置 JAVA_HOME,先 sudo apt-get install default-jdk,然后修改 /etc/environment(或者 ~/.bashrc),添加下面两行:
JAVA_HOME=/usr/lib/jvm/default-java
export JAVA_HOME
最后输入 . /etc/environment 载入环境变量,我们就可以以单机模式启动了,命令如下:
./bin/start-hbase.sh执行结果为:
parallels@ubuntu:~/hbase-0.94.27$ ./bin/start-hbase.sh
starting master, logging to /home/parallels/hbase-0.94.27/bin/../logs/hbase-parallels-master-ubuntu.out
所有的服务都运行在一个JVM上,包括HBase和Zookeeper。HBase的日志放在logs目录,当你启动出问题的时候,可以检查这个日志。
这之后就可以用我们属性的 hbase shell 来连接了,因为没有把当前文件夹加到路径中,所以需要完整路径,如果不想这样的话,仍然是打开 /etc/environment,把 /home/parallels/hbase-0.94.27/bin 添加到 PATH 中,这样执行的时候就会搜索这个文件夹(仍然需要 . /etc/environment 载入环境变量)。具体如下:
parallels@ubuntu:~/hbase-0.94.27$ hbase shell
HBase Shell; enter 'help<RETURN>' for list of supported commands.
Type "exit<RETURN>" to leave the HBase Shell
Version 0.94.27, rfb434617716493eac82b55180b0bbd653beb90bf, Thu Mar 19 06:17:55 UTC 2015

hbase(main):001:0>
输入 help 可以查看帮助信息,基本的操作如下:
create 'wdxtub', 'data'
list
put 'wdxtub', 'row1', 'data:a', 'value1'
scan 'wdxtub'
get 'wdxtub', 'row1'
disable 'wdxtub'
drop 'wdxtub'
exit
使用停止脚本来停止 HBase ./bin/stop-hbase.sh。
分布式配置
HBase使用和Hadoop一样配置系统。具体的做法是编辑 conf/hbase-env.sh 中的环境变量。在分布模式下运行时,在编辑HBase配置文件之后,确认将conf目录复制到集群中的每个节点。HBase不会自动同步,可以使用 rsync 来完成这个工作。另外,重启集群才能使新的配置生效。
具体的做法可以参考官方文档,我会在之后的文章中记录自己具体的配置过程。这篇文章主要是偏理论的介绍和研究。
hbase-site.xml
HBase 的配置文件是 conf/hbase-site.xml,具体的项目比较多,我选取了部分如下:
hbase.rootdir
这个目录是 region server 的共享目录,用来持久化 HBase。URL 必须完全正确,还要包含文件系统的 scheme。例如,要表示 hdfs 中的 /hbase 目录,namenode 运行在namenode.example.org 的 9090 端口。则需要设置为 hdfs://namenode.example.org:9000/hbase。默认情况下HBase是写到/tmp的。不改这个配置,数据会在重启的时候丢失。
默认: file:///tmp/hbase-${user.name}/hbase
hbase.master.port
HBase的Master的端口.
默认: 60000
hbase.cluster.distributed
HBase的运行模式。false 是单机模式,true 是分布式模式。若为 false, HBase 和Zookeeper 会运行在同一个 JVM 里面。
默认: false
hbase.tmp.dir
本地文件系统的临时文件夹。可以修改到一个更为持久的目录上。(/tmp会在重启时清楚)
默认: ${java.io.tmpdir}/hbase-${user.name}
hbase.local.dir
作为本地存储,位于本地文件系统的路径。
默认: ${hbase.tmp.dir}/local/
hbase.master.info.port
HBase Master web 界面端口. 设置为-1 意味着你不想让他运行。
默认: 60010
hbase.master.info.bindAddress
HBase Master web 界面绑定的端口
默认: 0.0.0.0(就是哪里都可以访问)
hbase.client.write.buffer
HTable客户端的写缓冲的默认大小。这个值越大,需要消耗的内存越大。因为缓冲在客户端和服务端都有实例,所以需要消耗客户端和服务端两个地方的内存。得到的好处是,可以减少RPC的次数。可以这样估算服务器端被占用的内存: hbase.client.write.buffer *
hbase.regionserver.port
HBase RegionServer绑定的端口
默认: 60020
hbase.regionserver.info.port
HBase RegionServer web 界面绑定的端口 设置为 -1 意味这你不想与运行 RegionServer 界面.
默认: 60030
hbase.regionserver.info.bindAddress
HBase RegionServer web 界面的IP地址
默认: 0.0.0.0
hbase.client.pause
通常的客户端暂停时间。最多的用法是客户端在重试前的等待时间。比如失败的get操作和region查询操作等都很可能用到。
默认: 1000
hbase.client.retries.number
最大重试次数。所有需重试操作的最大值。例如从root region服务器获取root region,Get单元值,行Update操作等等。这是最大重试错误的值。
默认: 10
hbase.bulkload.retries.number
最大重试次数。 原子批加载尝试的迭代最大次数。 0 表示永不放弃。
默认: 0
hbase.client.scanner.caching
当调用 Scanner 的 next 方法,而值又不在缓存里的时候,从服务端一次获取的行数。越大的值意味着Scanner会快一些,但是会占用更多的内存。当缓冲被占满的时候,next方法调用会越来越慢。慢到一定程度,可能会导致超时。例如超过了 hbase.regionserver.lease.period。
默认: 100
hbase.client.keyvalue.maxsize
一个 KeyValue 实例的最大 size. 这个是用来设置存储文件中的单个 entry 的大小上界。因为一个 KeyValue 是不能分割的,所以可以避免因为数据过大导致 region 不可分割。明智的做法是把它设为可以被最大 region size 整除的数。如果设置为 0 或者更小,就会禁用这个检查。默认10MB。
默认: 10485760
hbase.regionserver.lease.period
客户端租用HRegion server 期限,即超时阀值。单位是毫秒。默认情况下,客户端必须在这个时间内发一条信息,否则视为死掉。
默认: 60000
hbase.regionserver.handler.count
RegionServers 受理的 RPC Server 实例数量。对于 Master 来说,这个属性是 Master 受理的 handler 数量
默认: 10
hbase.regionserver.msginterval
RegionServer 发消息给 Master 时间间隔,单位是毫秒
默认: 3000
hbase.regionserver.regionSplitLimit
region 的数量到了这个值后就不会在分裂了。这不是一个 region 数量的硬性限制。但是起到了一定指导性的作用,到了这个值就该停止分裂了。默认是 MAX_INT.就是说不阻止分裂。
默认: 2147483647
hbase.balancer.period
Master执行region balancer的间隔。
默认: 300000
hbase.regions.slop
当任一区域服务器有 average + (average * slop)个分区,将会执行重新均衡。
默认:0.2
hbase.regionserver.global.memstore.upperLimit
单个 region server 的全部 memtores 的最大值。超过这个值,一个新的 update 操作会被挂起,强制执行flush操作。
默认: 0.4
hbase.regionserver.global.memstore.lowerLimit
当强制执行flush操作的时候,当低于这个值的时候,flush会停止。默认是堆大小的 35% . 如果这个值和 hbase.regionserver.global.memstore.upperLimit 相同就意味着当update操作因为内存限制被挂起时,会尽量少的执行flush(译者注:一旦执行flush,值就会比下限要低,不再执行)
默认: 0.35
hbase.storescanner.parallel.seek.enable
允许 StoreFileScanner 并行搜索 StoreScanner, 一个在特定条件下降低延迟的特性。
默认: false
hbase.storescanner.parallel.seek.threads
并行搜索特性打开后,默认线程池大小。
默认: 10
hfile.block.cache.size
分配给HFile/StoreFile的block cache占最大堆(-Xmx setting)的比例。默认0.25意思是分配25%,设置为0就是禁用,但不推荐。
默认:0.25
hbase.hash.type
哈希函数使用的哈希算法。可以选择两个值:: murmur (MurmurHash) 和 jenkins (JenkinsHash). 这个哈希是给 bloom filters用的.
默认: murmur
hbase.zookeeper.quorum
Zookeeper集群的地址列表,用逗号分割。如:"host1.mydomain.com,host2.mydomain.com,host3.mydomain.com".默认是localhost,是给伪分布式用的。要修改才能在完全分布式的情况下使用。如果在hbase-env.sh设置了HBASE_MANAGES_ZK,这些ZooKeeper节点就会和HBase一起启动。
默认: localhost
hbase.zookeeper.property.clientPort
ZooKeeper的zoo.conf中的配置。 客户端连接的端口
默认: 2181
hbase.zookeeper.property.maxClientCnxns
ZooKeeper的zoo.conf中的配置。 ZooKeeper集群中的单个节点接受的单个Client(以IP区分)的 请求的并发数。这个值可以调高一点,防止在单机和伪分布式模式中出问题。
默认: 300
hbase-env.sh
在这个文件里面设置HBase环境变量。比如可以配置JVM启动的堆大小或者GC的参数。你还可在这里配置HBase的参数,如Log位置,niceness(译者注:优先级),ssh参数还有pid文件的位置等等。打开文件conf/hbase-env.sh细读其中的内容。每个选项都是有详尽的注释的。你可以在此添加自己的环境变量。
这个文件的改动系统HBase重启才能生效。
log4j.properties
编辑这个文件可以改变HBase的日志的级别,轮滚策略等等。 这个文件的改动系统HBase重启才能生效。 日志级别的更改会影响到HBase UI
推荐配置
zookeeper.session.timeout
这个默认值是3分钟。这意味着一旦一个server宕掉了,Master至少需要3分钟才能察觉到宕机,开始恢复。你可能希望将这个超时调短,这样Master就能更快的察觉到了。在你调这个值之前,你需要确认你的JVM的GC参数,否则一个长时间的GC操作就可能导致超时。(当一个RegionServer在运行一个长时间的GC的时候,你可能想要重启并恢复它).
要想改变这个配置,可以编辑 hbase-site.xml, 将配置部署到全部集群,然后重启。
我们之所以把这个值调的很高,是因为我们不想一天到晚在论坛里回答新手的问题。“为什么我在执行一个大规模数据导入的时候 Region Server 死掉啦”,通常这样的问题是因为长时间的 GC 操作引起的,他们的JVM没有调优。我们是这样想的,如果一个人对HBase不很熟悉,不能期望他知道所有,打击他的自信心。等到他逐渐熟悉了,他就可以自己调这个参数了。
ZooKeeper 实例个数
一个分布式运行的HBase依赖一个zookeeper集群。所有的节点和客户端都必须能够访问zookeeper。默认的情况下HBase会管理一个zookeep集群。这个集群会随着HBase的启动而启动。当然,你也可以自己管理一个zookeeper集群,但需要配置HBase。你需要修改conf/hbase-env.sh里面的 HBASE_MANAGES_ZK 来切换。这个值默认是true的,作用是让HBase启动的时候同时也启动zookeeper
对于zookeepr的配置,你至少要在 hbase-site.xml中列出zookeepr的ensemble servers(这个我们也可以在代码中配置),具体的字段是 hbase.zookeeper.quorum. 该这个字段的默认值是 localhost,这个值对于分布式应用显然是不可以的. (远程连接无法使用).
具体参考这里
hbase.regionserver.handler.count
这个设置决定了处理用户请求的线程数量。默认是10,这个值设的比较小,主要是为了预防用户用一个比较大的写缓冲,然后还有很多客户端并发,这样region servers会垮掉。有经验的做法是,当请求内容很大(上MB,如大puts, 使用缓存的scans)的时候,把这个值放低。请求内容较小的时候(gets, 小puts, ICVs, deletes),把这个值放大。
当客户端的请求内容很小的时候,把这个值设置的和最大客户端数量一样是很安全的。一个典型的例子就是一个给网站服务的集群,put操作一般不会缓冲,绝大多数的操作是get操作。
把这个值放大的危险之处在于,把所有的Put操作缓冲意味着对内存有很大的压力,甚至会导致OutOfMemory.一个运行在内存不足的机器的RegionServer会频繁的触发GC操作,渐渐就能感受到停顿。(因为所有请求内容所占用的内存不管GC执行几遍也是不能回收的)。一段时间后,集群也会受到影响,因为所有的指向这个region的请求都会变慢。这样就会拖累集群,加剧了这个问题。
在单个RegionServer启动log并查看log末尾 (请求队列消耗内存)。来决定合适的数量
在区域服务器打开RPC-level的日志对于深度的优化是有好处的。一旦打开,日志将喷涌而出。所以不建议长时间打开,只能看一小段时间。要想启用RPC-level的职责,可以使用区域服务器 UI点击Log Level。将org.apache.hadoop.ipc 的日志级别设为DEBUG。然后tail 区域服务器的日志,进行分析。要想关闭,只要把日志级别设为INFO就可以了.
大内存机器的配置
HBase有一个合理的保守的配置,这样可以运作在所有的机器上。如果你有台大内存的集群-HBase有8G或者更大的heap,接下来的配置可能会帮助你
压缩
应该考虑启用ColumnFamily 压缩。有好几个选项,通过降低存储文件大小以降低IO,降低消耗且大多情况下提高性能。具体参考这里
较大 Regions
更大的Region可以使你集群上的Region的总数量较少。 一般来言,更少的Region可以使你的集群运行更加流畅。(你可以自己随时手工将大Region切割,这样单个热点Region就会被分布在集群的更多节点上)。
较少的Region较好。一般每个RegionServer在20到小几百之间。 调整Region大小以适合该数字。
可以调整hbase-site.xml中的 hbase.hregion.max.filesize属性. RegionSize 也可以基于每个表设置
HBase Shell
输入 help 就会返回Shell的命令列表和选项。可以看看在Help文档尾部的关于如何输入变量和选项。尤其要注意的是表名,行,列名必须要加引号。
如果要使用脚本,可以看HBase的bin 目录.在里面找到后缀为 *.rb的脚本.要想运行这个脚本,要这样
$ ./bin/hbase org.jruby.Main PATH_TO_SCRIPT
可以在你自己的Home目录下创建一个 .irbrc 文件. 在这个文件里加入自定义的命令。有一个有用的命令就是记录命令历史,这样你就可以把你的命令保存起来。
$ more .irbrc
require 'irb/ext/save-history'
IRB.conf[:SAVE_HISTORY] = 100
IRB.conf[:HISTORY_FILE] = "#{ENV['HOME']}/.irb-save-history"
你可以将shell切换成debug模式。这样可以看到更多的信息。例如可以看到命令异常的stack trace:
hbase> debug <RETURN>想要在 shell 中看到 DEBUG 级别的 logging ,可以在启动的时候加上 -d 参数.
$ ./bin/hbase shell -d数据模型
简单来说,应用程序是以表的方式在HBase存储数据的。表是由行和列构成的,所有的列是从属于某一个列族的。行和列的交叉点称之为cell,cell是版本化的。cell的内容是不可分割的字节数组。
表的行键也是一段字节数组,所以任何东西都可以保存进去,不论是字符串或者数字。HBase的表是按key排序的,排序方式之针对字节的。所有的表都必须要有主键-key.
基本概念
有一个名为webtable的表,包含两个列族:contents和anchor.在这个例子里面,anchor有两个列 (anchor:cssnsi.com,anchor:my.look.ca),contents仅有一列(contents:html)
一个列名是由它的列族前缀和修饰符(qualifier)连接而成。例如列contents:html是列族 contents加冒号(:)加 修饰符 html组成的。
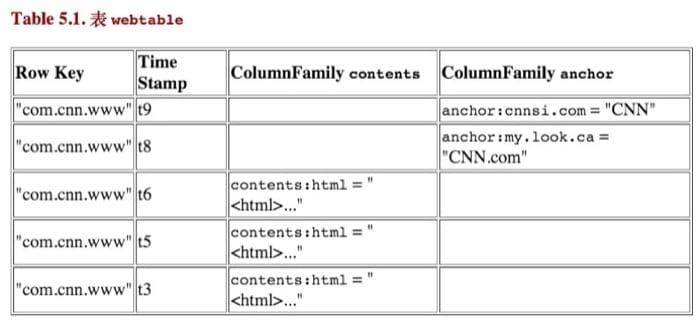
- 表
- 表是在schema声明的时候定义的
- 行键
- 不可分割的字节数组。行是按字典排序由低到高存储在表中的。一个空的数组是用来标识表空间的起始或者结尾
- 列族
- 在HBase是列族一些列的集合。一个列族所有列成员是有着相同的前缀。比如,列courses:history 和 courses:math都是 列族 courses的成员.冒号(:)是列族的分隔符,用来区分前缀和列名。column 前缀必须是可打印的字符,剩下的部分(称为qualify),可以又任意字节数组组成。列族必须在表建立的时候声明。column就不需要了,随时可以新建。
- 在物理上,一个的列族成员在文件系统上都是存储在一起。因为存储优化都是针对列族级别的,这就意味着,一个colimn family的所有成员的是用相同的方式访问的。
- Cell
A {row, column, version}元组就是一个HBase中的一个 cell。Cell的内容是不可分割的字节数组。
操作主要是四个:Get, Put, Scans, Delete
HBase是否支持联合是一个网上常问问题。简单来说 : 不支持。至少不想传统RDBMS那样支持(如 SQL中带 equi-joins 或 outer-joins). 正如本章描述的,读数据模型是 Get 和 Scan. 但并不表示等价联合不能在应用程序中支持,只是必须自己做。 两种方法,要么指示要写到HBase的数据,要么查询表并在应用或MapReduce代码中做联合(如 RDBMS所展示,有几种步骤来实现,依赖于表的大小。如 nested loops vs. hash-joins). 哪个更好?依赖于你准备做什么,所以没有一个单一的回答适合所有方面。
Schema 设计
列族设计
现在HBase并不能很好的处理两个或者三个以上的列族,所以尽量让你的列族数量少一些。目前,flush和compaction操作是针对一个Region。所以当一个列族操作大量数据的时候会引发一个flush。那些不相关的列族也有进行flush操作,尽管他们没有操作多少数据。Compaction操作现在是根据一个列族下的全部文件的数量触发的,而不是根据文件大小触发的。当很多的列族在flush和compaction时,会造成很多没用的I/O负载(要想解决这个问题,需要将flush和compaction操作只针对一个列族) 。
尽量在你的应用中使用一个列族。只有你的所有查询操作只访问一个列族的时候,可以引入第二个和第三个列族.例如,你有两个列族,但你查询的时候总是访问其中的一个,从来不会两个一起访问。
一个表存在多列族,注意基数(如, 行数). 如果列族A有100万行,列族B有10亿行,列族A可能被分散到很多很多区(及区服务器)。这导致扫描列族A低效。
行键(RowKey)设计
下面是一些具体的技巧
- 使用了顺序的key会将本没有顺序的数据变得有顺序,把负载压在一台机器上。所以要尽量避免时间戳或者(e.g. 1, 2, 3)这样的key。
- 尽量最小化行和列的大小。大部分时候,小的低效不会影响很大。不幸的是,这里会是个问题。无论是列族,属性和行键都会在数据中重复上亿次。
- 尽量使列族名小,最好一个字符。(如 "d" 表示 data/default).
- 详细属性名 (如, "myVeryImportantAttribute") 易读,最好还是用短属性名 (e.g., "via") 保存到HBase.
- 让行键短到可读即可,这样对获取数据有用(e.g., Get vs. Scan)。 短键对访问数据无用,并不比长键对get/scan更好。设计行键需要权衡。
- long 类型有 8 字节. 8字节内可以保存无符号数字到18,446,744,073,709,551,615. 如果用字符串保存--假设一个字节一个字符,需要将近3倍的字节数
- 一个数据库处理的通常问题是找到最近版本的值。采用倒序时间戳作为键的一部分可以对此特定情况有很大帮助。
- 行键不能改变。唯一可以“改变”的方式是删除然后再插入。这是一个网上常问问题,所以要注意开始就要让行键正确(且/或在插入很多数据之前)。
性能调优
- RAM, RAM, RAM. 不要饿着 HBase.
- 使用 64-bit 平台(和64-bit JVM).
- 小心交换,将交换区设为0。
可以调整的参数;
- hbase.regionserver.handler.count
- 这个参数的本质是设置一个RegsionServer可以同时处理多少请求。 如果定的太高,吞吐量反而会降低;如果定的太低,请求会被阻塞,得不到响应。
- hfile.block.cache.size
- hbase.regionserver.global.memstore.upperLimit
- hbase.regionserver.global.memstore.lowerLimit
- hbase.hstore.blockingStoreFiles
- hbase.hregion.memstore.block.multiplier,如果有足够的RAM,提高这个值
具体的很多内容还是需要在实践中尝试,这次的探索就到这里。
相关文章
- 云计算 Twitter 语料分析 6 MySQL 和 HBase 配置及测试2016-03-11
- 云计算 Twitter 语料分析 10 搭建数据分析网络应用2016-04-01
- 云计算 Twitter 语料分析 9 用 CDH 5 搭建基于 Hadoop 2.0 的 HBase2016-03-22
- 云计算 Twitter 语料分析 8 处理复杂读请求2016-03-17