云计算 Twitter 语料分析 9 用 CDH 5 搭建基于 Hadoop 2.0 的 HBase
本页目录
之前的任务中我们使用 Amazon EMR 来搭建 HBase,这样一来,可定制性就比较差,没有办法根据具体的应用来进行调优,所以这里我们试着直接使用普通的 EC2 实例来自己搭建 HBase。
因为是试验性质,所以这里启用 2 台 m4.large 实例,1 台作为 master,1 台作为 core。先来看看整体的架构图:
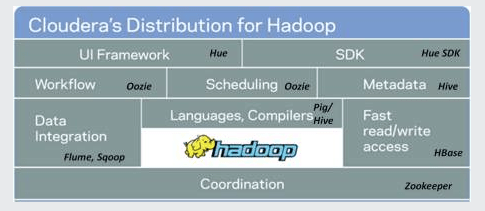
CDH 5 默认安装基于 YARN 架构的 MapReduce 2.x 版本(通常直接叫 YARN),更多版本相关的细节可以查看这里。
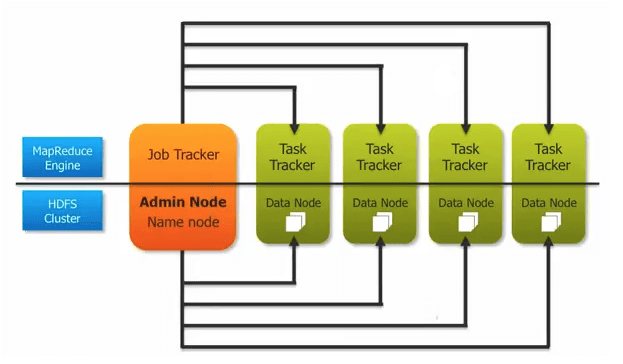
MapReduce 2.0(YARN) 采用了和之前版本不一样的架构。原先的架构分为 JobTracker(管理资源、调度和监控 job)以及每个 node 都有的 NodeManager:
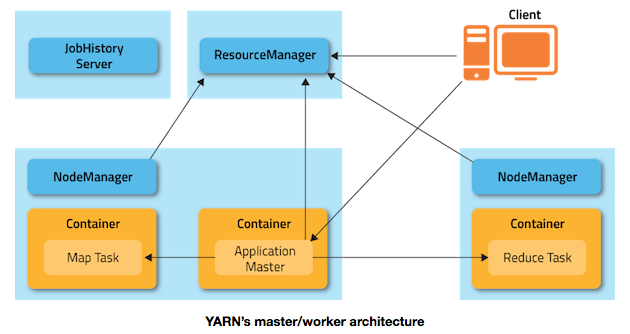
相比之下 MapReduce 2.0(YARN) 的设计是:
- 采用全局的 ResourceManager 来取代原来的 JobTracker 和在数据节点上跑的 TaskTracker
- 采用 ApplicationMaster 来进行节点监控和任务管理
接下来我们就具体来进行安装配置.
安装 Cloudera
先连接到我们创建的 EC2 实例
ssh -i group.pem ubuntu@ec2-52-91-54-229.compute-1.amazonaws.com
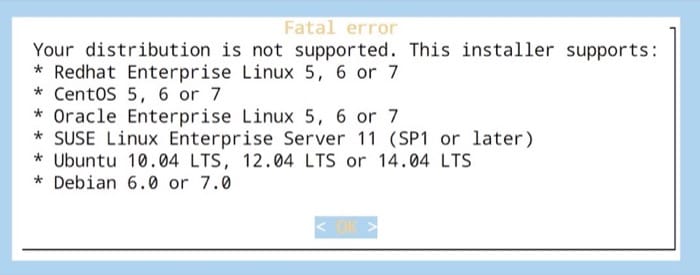
最好使用 Ubuntu,因为支持的版本有限
然后通过下面的命令下载并安装 Cloudera Manager,因为是二进制文件,所以需要修改权限
wget http://archive.cloudera.com/cm5/installer/latest/cloudera-manager-installer.bin

chmod u+x cloudera-manager-installer.bin
sudo ./cloudera-manager-installer.bin
跟着屏幕的指示进行安装即可,如果想要卸载,可以使用:
sudo /usr/share/cmf/uninstall-cloudera-manager.sh
管理集群
安装完成之后使用 sudo service cloudera-scm-server start 启动,具体的启动过程可以通过以下命令查看
sudo tail -f /var/log/cloudera-scm-server/cloudera-scm-server.log
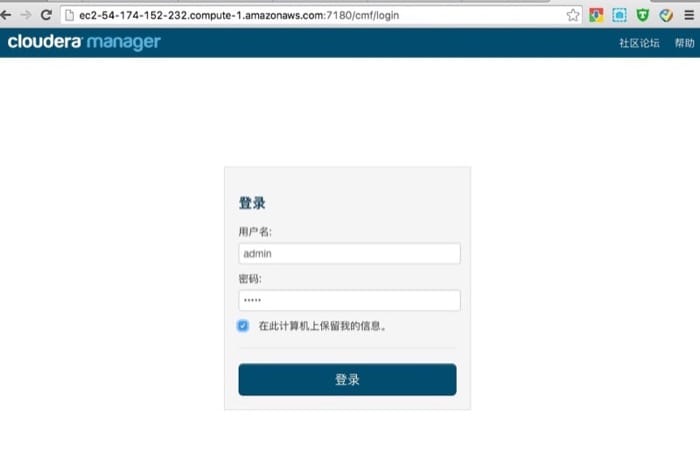
或者也可以使用 netstat 命令查看 7180 端口有没有启动,启动完成后。根据安装过程中出现的提示,我们可以在浏览器中访问 http://ec2-54-174-152-232.compute-1.amazonaws.com:7180 并用默认账户登录(用户名和密码都是 admin,地址就是 EC2 主机的地址)
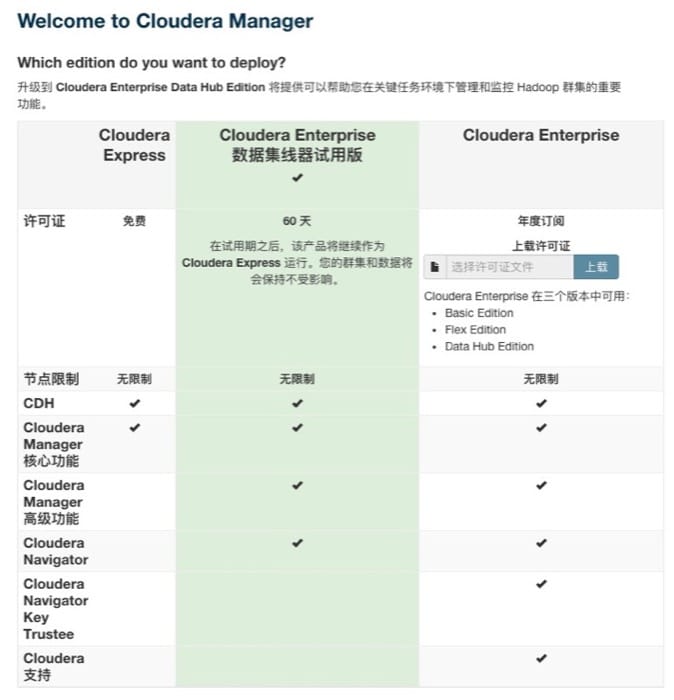
接受用户协议之后需要选择套餐,直接选择试用就行
开启新的主机,然后填写地址(这里需要填写所有开启的主机的地址),输入用户名 ubuntu 并上传对应的 key.pem,然后就会自动进行安装配置了。
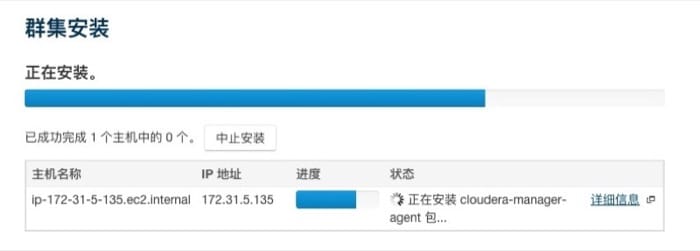
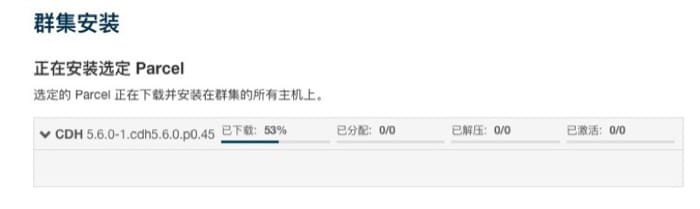
最后会进行主机的检查,这里有一个提醒:
Cloudera 建议将 /proc/sys/vm/swappiness 设置为 0。当前设置为 60。使用 sysctl 命令在运行时更改该设置并编辑 /etc/sysctl.conf 以在重启后保存该设置
所以我们登录到 core 节点做一些修改。
ssh -i group.pem ubuntu@ec2-52-87-250-126.compute-1.amazonaws.com
sudo sysctl -w vm.swappiness=0
sudo vim /etc/sysctl.conf
# 在最后添加一行 vm.swappiness=0
重新检测之后一切正常,我们可以继续之后的操作。
安装服务
然后我们就可以选择需要安装的服务了
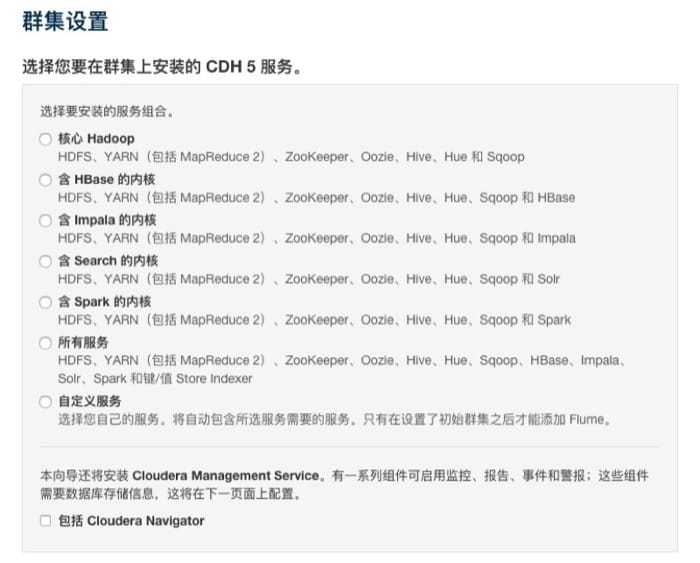
直接选择 HBase,然后一路进行配置(实际使用时需要选择需要的几个就好,其他不用的最好不要安装)。具体选项很多,因为是试验,我都没有修改,直接用的默认值。然后就开始配置:
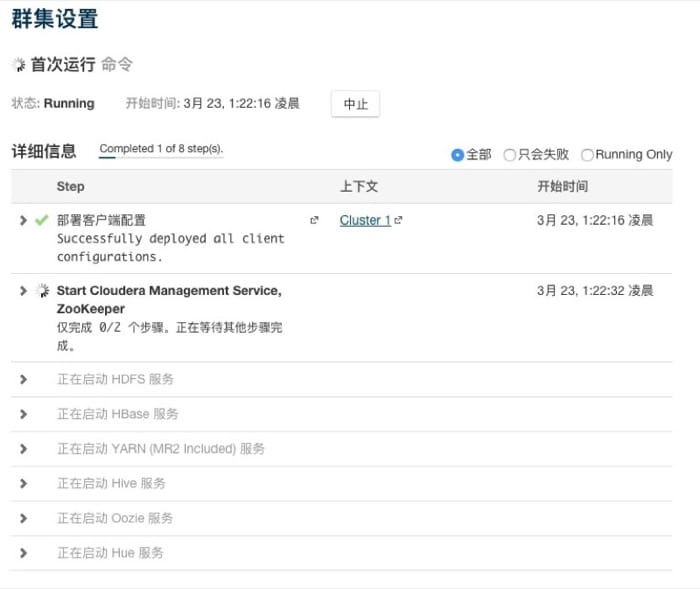
其实有很多服务都不用配置的,之后真正搭建的时候可以只保留 HBase 相关的服务。我的选择是:hbase, zookeeper, hdfs 和 hadoop(1 or 2)
各种步骤都完成之后,就可以登录并使用 hbase 了,其余的步骤都类似,这里不再赘述:
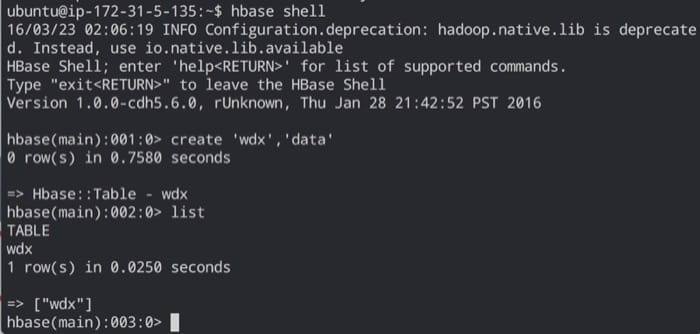
总体来说,Cloudera 很好很强大,全中文配置也很省心,重要的是,免费!
前后端配置命令
DNS 地址
front
ec2-54-209-177-206.compute-1.amazonaws.com

back
ec2-54-173-203-155.compute-1.amazonaws.com
ec2-54-152-66-11.compute-1.amazonaws.com
ec2-52-91-84-4.compute-1.amazonaws.com
ec2-52-90-62-232.compute-1.amazonaws.com
ec2-52-90-185-14.compute-1.amazonaws.com


ssh -i ../group.pem ubuntu@ec2-52-90-185-14.compute-1.amazonaws.com
sudo sysctl -w vm.swappiness=0
可能还需要修改 java 虚拟机默认的堆的大小,在 ~/.bashrc 中加入 export MAVEN_OPTS="-Xms8000m -Xmx8000m" 并 source .bashrc
# 更新服务器代码
scp -i ../group.pem -r ./* ubuntu@ec2-54-209-177-206.compute-1.amazonaws.com:~/undertow-server/

# 启动 server
mvn clean; mvn compile; sudo mvn exec:java
HBase 数据导入,会有权限问题,这里用另外的用户组来执行。洗数据的时候需要拼接(如果用 userid 作为 key 的话),也就是先 padding 再 combine
sudo -u hdfs hadoop fs -mkdir /housailei
sudo -u hdfs hadoop fs -mkdir /housailei/csv


hbase(main):001:0> create 'q2db', {NAME => 'data', IN_MEMORY => 'true', COMPRESSION => 'SNAPPY', BLOCKCACHE => 'true', BLOOMFILTER => 'ROWCOL'},{ NUMREGIONS => 20, SPLITALGO => 'UniformSplit'}

hbase(main):001:0> create 'q3db', {NAME => 'data', IN_MEMORY => 'true', COMPRESSION => 'SNAPPY', BLOCKCACHE => 'true', BLOOMFILTER => 'ROWCOL'},{ NUMREGIONS => 20, SPLITALGO => 'UniformSplit'}

hbase(main):001:0> create 'q4db', {NAME => 'data', IN_MEMORY => 'true', COMPRESSION => 'SNAPPY', BLOCKCACHE => 'true', BLOOMFILTER => 'ROWCOL'},{ NUMREGIONS => 20, SPLITALGO => 'UniformSplit'}

cd /mnt
wget http://s3.amazonaws.com/housailei15619/alloutput/hbasedata
sudo -u hdfs hadoop fs -put ./hbasedata /housailei/csv/
rm hbasedata


sudo -u hdfs hadoop fs -ls /hfile_groupt2/

sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.bulk.output=/hfile_groupt2 -Dimporttsv.columns=HBASE_ROW_KEY,data:t q2db /housailei/csv/hbasedata

# 这句很重要,不然要出事
sudo -u hdfs hdfs dfs -chmod -R +rwx /hfile_groupt2

# 方法1
sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.completebulkload /hfile_groupt2 q2db

# 方法2
sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /hfile_groupt2 q2db
sudo -u hdfs hadoop fs -rm /housailei/csv/hbasedata

# q3 部分

wget http://s3.amazonaws.com/housailei15619/Query3-Result-All-Postprocessed/q3-hbase-data
sudo -u hdfs hadoop fs -put ./q3-hbase-data /housailei/csv/
rm q3-hbase-data

sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.bulk.output=/hfile_groupt35 -Dimporttsv.columns=HBASE_ROW_KEY,data:t q3db /housailei/csv/q3-hbase-data

# 这句很重要,不然要出事
sudo -u hdfs hdfs dfs -chmod -R +rwx /hfile_groupt35

sudo -u hdfs hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /hfile_groupt35 q3db

sudo -u hdfs hadoop fs -rm -r /housailei/csv/*

aws s3 cp ./q3-hbase-data s3://housailei15619/Query3-Result-All-Postprocessed/
查数据命令
scan 'q3db', {STARTROW => '00952122372', STOPROW => '00952124492' }测试网址
- Q2
http://q1-1848733628.us-east-1.elb.amazonaws.com/q2?userid=1000001233&hashtag=BabyyO - Q3
http://q1-1848733628.us-east-1.elb.amazonaws.com/q3?start_date=2014-04-01&end_date=2014-05-28&start_userid=51538630&end_userid=51539182&words=u,petition,loving
数据 padding,另外注意 scan 的结束范围是开区间,所以记得 id + 1,再进行处理
f = open("q3-hbase-data")
output = open('q3-hbase-pad-data', 'w')

line = f.readline()
i = 0
j = 1
while line:
    temp = line.split('\t')
    s = temp[0].zfill(11) + '\t' + temp[1] + '\t' + temp[2]
    output.write(s)
    i = i + 1
    if i == 1000:
        print j , 'K'
        i = 0
        j = j + 1
    line = f.readline()
f.close()
output.close()
运行服务器
mvn clean; mvn compile; sudo mvn exec:java访问
curl 'http://ec2-54-209-177-206.compute-1.amazonaws.com/q2?userid=1000001233&hashtag=BabyyO'
curl 'http://ec2-54-209-177-206.compute-1.amazonaws.com/q3?start_date=2014-04-01&end_date=2014-05-28&start_userid=51538630&end_userid=51539182&words=u,petition,loving'
参考资料
相关文章
- 云计算 Twitter 语料分析 10 搭建数据分析网络应用2016-04-01
- 云计算 Twitter 语料分析 8 处理复杂读请求2016-03-17
- 云计算 Twitter 语料分析 7 探索 HBase2016-03-13
- 云计算 Twitter 语料分析 6 MySQL 和 HBase 配置及测试2016-03-11