云计算 Twitter 语料分析 6 MySQL 和 HBase 配置及测试
本页目录
完成了数据处理,我们就可以把清洗之后的数据导入数据库了,需要分别针对 MySQL 和 HBase 写两套代码。具体我们可以把数据库与前端分离,只要配置好能让前端来连接即可。
数据库设计
我们需要做的很简单,就是返回某个用户用指定的 hashtag 发的 tweet,具体请求和响应的格式为:
请求格式
GET /q2?userid=uid&hashtag=hashtag

响应格式(如果有对应的推文)
TEAMID,TEAM_AWS_ACCOUNT_ID\n
Sentiment_density1:Tweet_time1:Tweet_id1:Cencored_text1\n
Sentiment_density2:Tweet_time2:Tweet_id2:Cencored_text2\n
Sentiment_density3:Tweet_time3:Tweet_id3:Cencored_text3\n

响应格式(如果没有对应的推文)

TEAMID,TEAM_AWS_ACCOUNT_ID\n
\n
可以看到,实际要在数据库中检索的内容,就是 userid 和 hashtag,其他的列只需要按照格式建立对应的列即可(后面需要用来排序)。
MySQL Schema
一个可能的表格
DROP TABLE IF EXISTS `q2`;

CREATE TABLE `q2` (
  `tweet_id` BIGINT(20) UNSIGNED
	`user_id` BIGINT(20) UNSIGNED NOT NULL,
	`time` char(20) NOT NULL,
	`content` varchar(140),
	`score` REAL,
	`hashtag` varchar(14)
) ENGINE=InnoDB DEFAULT CHARACTER SET = utf8mb4 COLLATE = utf8mb4_unicode_ci;- 索引要怎么建立
- 导入数据时可以使用 MyISAM engine,导入数据时较快,增加
key_buffer_size
创建的时候可以直接命令执行(直接用的之前的命令,注意对应改)
mysql -u root -pdb15319root song_db < create_tables.sql
HBase Table
HBase 的设计主要是需要决定具体的 rowkey 是什么(需要是唯一的),可以考虑用不同的项拼成一个 rowkey,然后剩下的数据放在 column family 中。
一个可能的设计是用 tweet_id+user_id+hashtag 作为 rowkey,具体怎么弄还要测试
- 增加 BlockCache size
- 增加第二个索引: Phoenix -> converted index
导入数据
预处理
这里我们需要把 MapReduce 得到的结果合并、排序并处理成我们需要的形式。
首先是把数据下载到机器(本地或者 EC2 都可以)上,我们的结果放在 s3://housailei15619/alloutput/ 中,直接 wget 应该就可以:
wget http://s3.amazonaws.com/housailei15619/alloutput/part-00000wget http://s3.amazonaws.com/housailei15619/alloutput/part-00001wget http://s3.amazonaws.com/housailei15619/alloutput/part-00002
或者 aws s3 命令:
aws s3 cp s3://housailei15619/alloutput/part-00000 ./aws s3 cp s3://housailei15619/alloutput/part-00001 ./aws s3 cp s3://housailei15619/alloutput/part-00002 ./
这里也说一下如何配置 awscli(ubuntu 镜像,如果使用 Amazon Linux AMI 则已经预装)
- 先安装 pip
sudo apt-get install python-pip - 然后安装 awscli
pip install awscli(也可以直接sudo apt-get install awscli) - 然后使用
aws configure来进行配置,地区选择 us-east-1
接下来需要做的事情如下:
- 合并数据(bash)
- 比较简单,直接
cat part-00000 part-00001 part-00002 > origindata
- 比较简单,直接
- 按照指定列排序(bash)
- 需要用 sort 命令
sort -t$'\t' -k2 origindata > sorteddata
- 需要用 sort 命令
- 清洗数据 userid+hashtag 一致的项目
- 把 " 这些都还原了
- 把写好的文件传上去
scp -i group2.pem ./Wash.java ubuntu@ec2-52-23-186-7.compute-1.amazonaws.com:~/ - 取一小部分到本地测试
scp -i group2.pem ubuntu@ec2-52-23-186-7.compute-1.amazonaws.com:~/test ./
开 m4.large 性能还算不错,处理五千多万条记录大概的时间是:
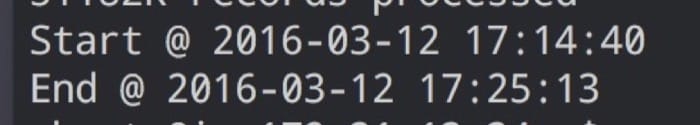
得到的文件可能会变大,然后通过 aws s3 把处理好的文件放回去 s3,方便其他机器用
aws s3 cp ./hbasedata s3://housailei15619/alloutput/
测试之后发现可能会有重复的记录,可以用 grep 来看到底出了什么问题 grep "1000001233" hbasedata | grep "BabyyO"
导入 MySQL
大概的语法是:
date
mysqlimport --local --fields-terminated-by='\t' --lines-terminated-by='\n' -uroot -proot --default-character-set=utf8mb4 dbname filename
date
建立索引
date
mysql -uroot -proot dbname -e "create index iname on tablename (column1, column2,..)"
date
导入 HBase
需要使用 EMR 进行导入,具体参考 云计算 第 14 课 文件 vs 数据库
- 启动 EMR 集群:1 master & 1 core
- 在创建页面中选择 "Go to advanced options"
- 确保所有的实例都是 m4.large
- 选择 AMI version 3.11.0 (hadoop version 2).
- 移除所有的已有服务(Pig & Hive)并选择安装 HBase version 0.94.
- 指定 key-pair 以便 SSH 到 master 实例,ssh 的时候注意用户名是 hadoop
- 不要忘记设置标签:
15619project:phase1,15619backend:hbase - 开启 "termination protection" 和 "keep-alive"
- master 和 core 节点的安全组都允许所有流量,使用 Master public DNS 来进行连接
- ssh 到 master 节点之后,运行
hadoop dfsadmin -report检查 HDFS 的状态
这里我们用提供的 reference 来进行导入测试,注意需要先清理掉没有 hashtag 的内容,并且把数据组织成我们需要的形式(注意 hashtag 最后的 \n)。
这里可以下载下来本地跑,或者新开一个服务器来处理。
- 根据设计的表来处理数据
- 用 awk 排序
- 合并数据,直接得到答案
开启之后连接上去 ssh -i group2 hadoop@dns.compute-1.amazonaws.com
然后用 hdfs dfsadmin -report 检查状态,一切正常之后就可以上传数据了,用如下命令即可
mkdir Q2
cd Q2
scp -i group2.pem ./cdata hadoop@ec2-52-91-183-102.compute-1.amazonaws.com:~/Q2/
然后创建对应的 HDFS 目录,再把 csv 文件移过去:
hadoop fs -mkdir /housailei
hadoop fs -mkdir /housailei/csv
hadoop fs -put ./cdata /housailei/csv/
# 查看
hadoop fs -ls /housailei/csv/
然后进入 HBase Shell 操作 hbase shell
hbase(main):001:0> create 'q2db', {NAME => 'data', DATA_BLOCK_ENCODING => 'FAST_DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '131072', IN_MEMORY => 'true', BLOCKCACHE => 'true', BLOOMFILTER => 'ROWCOL'}
hbase(main):002:0> list
hbase(main):003:0> describe 'q2db'
hbase(main):004:0> exit
然后就需要具体的导入了,可能会遇到数据太大放不进去的问题,这时候放到挂载的目录下 /mnt 才行,命令如下:
cd /mnt
wget http://s3.amazonaws.com/housailei15619/alloutput/hbasedata
aws s3 cp s3://housailei15619/alloutput/hbasedata ./

hadoop fs -put ./hbasedata /housailei/csv/

# 这里是处理完全部数据导入的时候的命令
# rowkey 直接是 userid+hashtag:
# 以 \t 为分隔符的话就不需要设定,这是默认的
hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.bulk.output=/hfile_groupt1 -Dimporttsv.columns=HBASE_ROW_KEY,data:t q2db /housailei/csv/hbasedata

hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /hfile_groupt1 q2db
完成之后测试一下 hbase shell:
hbase(main):001:0> scan 'q2db'如果导入错误的话,可以在 hbase shell 中 disable 'q2db' 之后 drop 'q2db' 来删除这个表,还要原来的 shell 中删除原来的数据文件 hadoop fs -rm /housailei/csv/cdata
重新导入的时候需要注意输出文件夹不能已存在,每次换新的就好。注意需要确保没有 BAD_LINE 才能继续。
在 HBase 的 master node 中备份(注意需要创建好对应的文件夹):aws emr create-hbase-backup --cluster-id j-3CU55C20WQ5E4 --dir s3://housailei15619/backups/j-3CU55C20WQ5E4 --consistent
最后附送几条 hadoop 指令
mapred job -list查看当前在执行的任务列表hadoop job -kill $jobId杀掉当前的任务
前端设计
其实只需要写两个连接器用来连接对应的数据库,然后在 Undertow 的 handler 中对应调用即可。具体访问的方式同样可以参考 云计算 第 14 课 文件 vs 数据库
- HBase 直接在 EMR 上做完,所以直接连接即可,不需要怎么配置
- MySQL 就需要自己安装和配置了
需要把换行符换回来
get 'twitterdata','1000001233BabyyO'
一些不错的测试用例:
ec2-54-208-201-121.compute-1.amazonaws.com/q2?userid=1000001233&hashtag=BabyyO
- 各种字符 + 多行输出:http://q1-1848733628.us-east-1.elb.amazonaws.com/q2?userid=1000001233&hashtag=BabyyO
- 各种字符 + 多行输出:http://q1-1848733628.us-east-1.elb.amazonaws.com/q2?userid=1000003579&hashtag=niigata
- 各种字符 + 单行输出:http://q1-1848733628.us-east-1.elb.amazonaws.com/q2?userid=1000034468&hashtag=الشباب
更新前端命令:scp -i ../group.pem -r ./* ubuntu@ec2-54-208-201-121.compute-1.amazonaws.com:~/undertow-server/
注意 pom 文件的版本要正确,并且不能在本地连接,要在 ec2 上连接。
可能还需要修改 java 虚拟机默认的堆的大小,在 ~/.bashrc 中加入 export MAVEN_OPTS=”-Xms14000m -Xmx14000m” 并 source .bashrc
杀掉当前在跑的进程 ps -ef | grep mvn 然后 kill pid,然后去 /etc/init.d 文件夹下把开机启动脚本删除(因为队友建的镜像默认是开机启动的,不方便调试)
启动 server mvn clean; mvn compile; sudo mvn exec:java
优化技巧
MySQL 优化
为查询缓存优化你的查询
// 查询缓存不开启
$r = mysql_query("SELECT username FROM user WHERE signup_date >= CURDATE()");

// 开启查询缓存
$today = date("Y-m-d");
$r = mysql_query("SELECT username FROM user WHERE signup_date >= '$today'");
上面两条SQL语句的差别就是 CURDATE() ,MySQL的查询缓存对这个函数不起作用。所以,像 NOW() 和 RAND() 或是其它的诸如此类的SQL函数都不会开启查询缓存,因为这些函数的返回是会不定的易变的。所以,你所需要的就是用一个变量来代替MySQL的函数,从而开启缓存。
为搜索字段建索引
索引并不一定就是给主键或是唯一的字段。如果在你的表中,有某个字段你总要会经常用来做搜索,那么,请为其建立索引吧。具体建立索引的方法前面有提过,这里不赘述。
从 PROCEDURE ANALYSE() 取得建议
PROCEDURE ANALYSE() 会让 MySQL 帮你去分析你的字段和其实际的数据,并会给你一些有用的建议。只有表中有实际的数据,这些建议才会变得有用,因为要做一些大的决定是需要有数据作为基础的。
例如,如果你创建了一个 INT 字段作为你的主键,然而并没有太多的数据,那么,PROCEDURE ANALYSE()会建议你把这个字段的类型改成 MEDIUMINT 。或是你使用了一个 VARCHAR 字段,因为数据不多,你可能会得到一个让你把它改成 ENUM 的建议。这些建议,都是可能因为数据不够多,所以决策做得就不够准。
一定要注意,这些只是建议,只有当你的表里的数据越来越多时,这些建议才会变得准确。一定要记住,你才是最终做决定的人。
选择正确的存储引擎
在 MySQL 中有两个存储引擎 MyISAM 和 InnoDB,每个引擎都有利有弊。
MyISAM 适合于一些需要大量查询的应用,但其对于有大量写操作并不是很好。甚至你只是需要update一个字段,整个表都会被锁起来,而别的进程,就算是读进程都无法操作直到读操作完成。另外,MyISAM 对于 SELECT COUNT(*) 这类的计算是超快无比的。
InnoDB 的趋势会是一个非常复杂的存储引擎,对于一些小的应用,它会比 MyISAM 还慢。他是它支持“行锁” ,于是在写操作比较多的时候,会更优秀。并且,他还支持更多的高级应用,比如:事务。
参数配置
打开配置文件 vim /etc/my.cnf
- 修改
back_log参数值:由默认的50修改为500.(每个连接256kb,占用:125M)back_log值指出在MySQL暂时停止回答新请求之前的短时间内多少个请求可以被存在堆栈中。也就是说,如果MySql的连接数据达到max_connections时,新来的请求将会被存在堆栈中,以等待某一连接释放资源,该堆栈的数量即back_log,如果等待连接的数量超过back_log,将不被授予连接资源。back_log值不能超过TCP/IP连接的侦听队列的大小。若超过则无效,查看当前系统的TCP/IP连接的侦听队列的大小命令:cat /proc/sys/net/ipv4/tcp_max_syn_backlog。对于 Linux 系统推荐设置为小于 512 的整数。show variables like 'back_log';查看当前数量
- 修改
max_connections参数值,由默认的151,修改为3000(750M)max_connections是指MySql的最大连接数,如果服务器的并发连接请求量比较大,建议调高此值,以增加并行连接数量,当然这建立在机器能支撑的情况下,因为如果连接数越多,介于MySql会为每个连接提供连接缓冲区,就会开销越多的内存,所以要适当调整该值,不能盲目提高设值。可以过'conn%'通配符查看当前状态的连接数量,以定夺该值的大小。- MySQL服务器允许的最大连接数16384;
- 查看系统当前最大连接数
show variables like 'max_connections';
- 修改
thread_concurrency值thread_concurrency的值的正确与否, 对mysql的性能影响很大, 在多个cpu(或多核)的情况下,错误设置了thread_concurrency的值, 会导致mysql不能充分利用多cpu(或多核), 出现同一时刻只能一个cpu(或核)在工作的情况。thread_concurrency应设为CPU核数的2倍. 比如有一个双核的CPU, 那thread_concurrency的应该为4; 2个双核的cpu, thread_concurrency的值应为8.
HBase 优化
HBase 不能支持 where 条件、Order by 查询,只支持按照主键 Rowkey 和主键的 range 来查询,但是可以通过 HBase 提供的 API 进行条件过滤。
HBase 的 Rowkey 是数据行的唯一标识,必须通过它进行数据行访问,目前有三种方式,单行键访问、行键范围访问、全表扫描访问。数据按行键的方式排序存储,依次按位比较,数值较大的排列在后,例如 int 方式的排序:1,10,100,11,12,2,20…,906,…。
ColumnFamily 是“列族”,属于 schema 表,在建表时定义,每个列属于一个列族,列名用列族作为前缀“ColumnFamily:qualifier”,访问控制、磁盘和内存的使用统计都是在列族层面进行的。 Cell 是通过行和列确定的一个存储单元,值以字节码存储,没有类型。
Timestamp 是区分不同版本 Cell 的索引,64 位整型。不同版本的数据按照时间戳倒序排列,最新的数据版本排在最前面。
Hbase 在行方向上水平划分成 N 个 Region,每个表一开始只有一个 Region,数据量增多,Region 自动分裂为两个,不同 Region 分布在不同 Server 上,但同一个不会拆分到不同 Server。
Region 按 ColumnFamily 划分成 Store,Store 为最小存储单元,用于保存一个列族的数据,每个 Store 包括内存中的 memstore 和持久化到 disk 上的 HFile。
分配合适的内存给 RegionServer 服务
在不影响其他服务的情况下,越大越好。例如在 HBase 的 conf 目录下的 hbase-env.sh 的最后添加 export HBASE_REGIONSERVER_OPTS="-Xmx16000m $HBASE_REGIONSERVER_OPTS” 其中 16000m 为分配给 RegionServer 的内存大小。
RegionServer 的请求处理 IO 线程数
较少的 IO 线程适用于处理单次请求内存消耗较高的 Big Put 场景 (大容量单次 Put 或设置了较大 cache 的 Scan,均属于 Big Put) 或 ReigonServer 的内存比较紧张的场景。 较多的 IO 线程,适用于单次请求内存消耗低,TPS 要求 (每秒事务处理量 (TransactionPerSecond)) 非常高的场景。设置该值的时候,以监控内存为主要参考。 在 hbase-site.xml 配置文件中配置项为 hbase.regionserver.handler.count。
200
调整 Block Cache
hfile.block.cache.size:RS的block cache的内存大小限制,默认值0.25,在偏向读的业务中,可以适当调大该值,具体配置时需试hbase集群服务的业务特征,结合memstore的内存占比进行综合考虑。
名称优化
列族名称尽量短,比如:“f”,并且尽量只有一个列族;
硬件优化
增加数据节点
参考资料
相关文章
- 云计算 Twitter 语料分析 7 探索 HBase2016-03-13
- 云计算 Twitter 语料分析 10 搭建数据分析网络应用2016-04-01
- 云计算 Twitter 语料分析 9 用 CDH 5 搭建基于 Hadoop 2.0 的 HBase2016-03-22
- 云计算 Twitter 语料分析 8 处理复杂读请求2016-03-17