云计算 第 10 课 Parallel Programming using EMR
本页目录
这节课我们来看看,如何利用 AWS 来进行并行处理,完成与上节课类似的文本处理任务。
这周的主要任务有下面四个:
- 探索一个大数据集
- 利用 MapReduce 来处理一个大数据集
- 使用 EMR(Elastic MapReduce) 在云上运行一个 MapReduce 工作
- 理解使用诸如 MapReduce 这样的框架来处理大数据的优势
注意!EMR 非常贵!所以从小的数据集开始。有两个部分要收钱:per-instance EMR 费用和实际的 EC2 实例费用。使用竞价实例来减小第二部分的花费。
先使用 WordCount 的例子来熟悉如何设置 cluster。
这次的的限额是 $15,大概就是有 2 次跑全数据的测试。
任务和上一周的类似,用上个月的维基百科页面访问的数据来进行分析。我们先从上个 project 所做的 filtering 开始,然后把所有的 2015 年 12 月的页面访问数据聚合起来。取出那些最重要的记录并输出到一个小的输出文件中,然后做一些处理来得到真正有用的信息。
上一次我们顺序处理了一个单一文件,但是没办法回答以下这些问题:
- 2015 年 12 月最受欢迎的页面是哪个
- 某个页面在某一天得到了多少点击
如果想要回答这两个问题,我们必须:
- 把所有的访问次数聚合起来,并且
- 对每个我们感兴趣的文章,生成每天的页面访问时间轴
为了处理这么大的一个数据集(压缩后 65 GB),我们会设置一个 Elastic MapReduce 工作来完成。需要写简单的 Map 和 Reduce 函数/程序。
开始之前,最好先弄明白 EMR 怎么收费。
别忘了打上 Project: 1.2 的标签
Introduction to MapReduce
MapReduce 是用许多机器来进行大数据处理的编程模型。Hadoop 是开源版本的 MapReduce 实现。Hadoop 把 MapReduce 当做一个分析引擎,并使用 Hadoop Distributed File System(HDFS) 来进行存储。HDFS 把数据集分成固定大小的块,分布式存放在不同的节点上。具体要执行的任务可以在不同的机器上并行处理。MapReduce 会把整个大任务分成不同的小的 map 和 reduce 任务。所有的 map 任务都在 map 阶段进行,所有的 reduce 任务都在 reduce 阶段进行。map 阶段可能有 1 个或多个任务,reduce 阶段可以有 0 个或多个 reduce 任务。
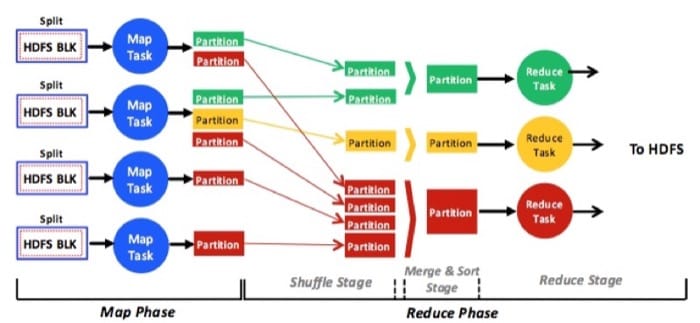
上图描述了一个简化的,但是完整的 MapReduce 分析引擎。Map 任务在分布式 HDFS 块上执行,reduce 任务在 map 任务的输出上执行(标记为 intermediate output 或 partitions)。每个 map 任务处理一个或多个不同的 HDFS 块,每个 reduce 任务处理一个或多个 partitions。在一个典型的 MapReduce 程序中,在所有 HDFS 块上执行的 map 任务都是一样的,在所有的 partitions 上执行的 reduce 任务也是一样的。
要使用集群来进行计算,需要考虑以下问题:
- 怎么样切分输入数据?
- 怎么样分配不同的工作?
- 怎么样协调所有的机器?
- 怎么样汇总结果?
有一些模型可以给我们一些帮助,如 MPI,但是只在消息传递阶段可以给我们帮助。这个时候,就要 MapReduce 出场了。先来看定义:
MapReduce (Definition): Programming model for processing large data sets with a parallel, distributed algorithm on a cluster.
分步骤来描述的话就是:
- Map:提取出关注的数据
- Group by key:对这些数据排序和重组(sort and shuffle)
- Reduce:聚合,汇总,过滤或者转变(Aggregate, summarize, filter or transform)
- 最后输出结果
具体来看看每个阶段的细节。
在 Map 阶段,需要为 mapper 准备好输入数据,也就是把大数据分割成小块并指派给各个 mapper。然后每个 mapper 就会在分到的数据块上完成指定的工作,之后输出键值对(key-value pair)。这里的键会用于之后的 shuffle 与 merge。Value 是从 mapper 发送到 reducer 的信息。
在 Shuffle 阶段,会把 mapper 阶段得到的结果根据 key 来进行排序和分组。利用哈希的方式把 key 进行分隔然后指派到不同的 reducers 中,每个 key 只会被指派给 1 个 reducer。
在 Reduce 阶段,每个 reducer 会处理 1 个或多个 key。这里的输入就是 mapper 的输出,也就是键值对,这里的输出就是我们需要的结果(可以编写不同的聚合逻辑)
对于程序员来说,使用 MapReduce 这个编程模型,需要提供:
- Map 函数
- Reduce 函数
- 输入和输出的位置
而 MapReduce 框架会处理好:
- 分隔输入数据
- 在一组机器上运行程序
- 执行 Group by key
- 处理机器执行失败的情况
- 管理必需的机器间交互
那么所谓的『并行』,体现在哪里呢?首先,mapper 是并行执行的,同时 reducer 也是并行执行的。但是。reducer 必须在 mapper 执行完成之后才可以开始。
MapReduce 的发展历程大概如下:
- 1958: LISP and Lambda Functions in Functional Programming
- 1995: Message Passing Interface(MPI) has Gather/Scatter functions
- 2004: Google's MapReduce Paper
- 2006-2008: Apache Hadoop v1.0
- 2013: YARN (Hadoop 2.0)
那么要如何使用 Hadoop 的 MapReduce 呢?可以有以下几种方式:
- 用 Java 写原生 MapReduce 程序:自定义 mapper 和 reducer
- Streaming MapReduce 工作:使用任何可执行的程序来作为 mapper 和 reducer
- 高层抽象:Pig, Hive 等
Amazon 的 Elastic MapReduce 是一个 Hadoop 的 PaaS 实现,为的是快速申请 Hadoop 集群并利用 S3 来导入/导出数据。接下来通过一个简单的例子来感受一下 Elastic MapReduce 是怎么回事。
Example EMR Job Flow: Wordcount
这里我们用 Java 来进行实现(Python 的就只提供视频地址):Java 版本视频教程 / Python 版本视频教程
整个过程可以用如下的命令来大致描述:
cat input | mapper_program | sort | reducer_program > output我们的输入是一个文本文件,里面是一篇英文的文章,我们的 mapper 程序如下:
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.util.StringTokenizer;

public class wordcountMapper{
    public static void main(String args[]){
        try {
            BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
            String input;
            // While we have input on stdin
            while((input = br.readline()) != null){
                StringTokenizer tokenizer = new StringTokenizer(input);
                while (tokenizer.hasMoreTokens()){
                    String word = tokenizer.nextToken();
                    System.out.println(word + "\t" + "1");
                }
            } catch(IOException io){
                io.printStackTrace();
            }
        }
    }
}
然后我们来看看 reducer 程序,这个比 mapper 稍微复杂一点:
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.util.StringTokenizer;

public class wordcountReducer {
    public static void main(String args[]){
        try {
            BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
            String input;
            String word = null;
            String currentWord = null
            int currentCount = 0;

            while ((input = br.readLine()) != null) {
                try {
                    String[] parts = input.split("\t");
                    word = parts[0];
                    int count = Integer.parseInt(parts[1]);

                    // We have sorted input, so check if we have the same word
                    if (currentWord != null && currentWord.equals(word)){
                        currentCount++;
                    } else { // the word has changed
                        if (currentWord != null) {
                            System.out.println(currentWord + "\t" + currentCount);
                        }
                        currentWord = word;
                        currentCount = count;
                    }
                } catch (NumberFormatException e) {
                    continue;
                }
            }

            if (currentWord != null && currentWord.equals(word)) {
                System.out.println(currentWord + "\t" + currentCount);
            }
        } catch(IOException io) {
            io.printStackTrace();
        }
    }
}
查看结果的话命令为(注意需要先编译,上面给出的代码不包含头文件):
cat input.txt | java wordcoutnMapper | sort | java wordcountReducer > output如果代码都准备好了,可以参考下面的视频,在 EMR 上运行 Java Streaming Program
从 S3 的 Bucket 获取数据,把 mapper 和 reducer 打包生成 jar 包并上传到 S3。然后到 Analytic 类别下的 EMR 选项。注意,运行 EMR 之前一定要在本地先测试!
命令行生成 jar 包的过程(假设我们有 wordcountMapper.java 和 wordcountReducer.java 两个文件):
- 先编译
javac wordcountMapper.java和javac wordcountReducer.java,然后我们就有了对应的.class文件 - 然后就可以打包了
jar -cvf wordcount.jar *.class,如果不是这么简单的情况,还是用 IDE 来打包比较方便
用具体的步骤来描述就是(前面是英文这里参考中文界面):
- 在 AWS 管理控制台选择 分析 下的 EMR(Hadoop 托管框架)
- 然后选择 创建集群,这里我们不使用快速选项,而是『转到高级选项』
- 配置页面要注意以下内容
- 起个名字
- 输入 S3 地址,用来存储 log
- 开启 logging 和 debugging
- bucket 名字最好值包含小写字母和数字,不要用
.,-和大写字母 - 软件配置中,选择
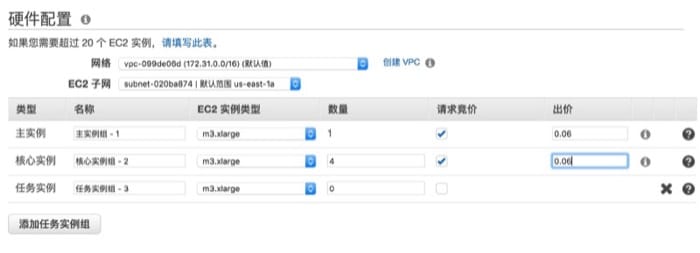
emr-4.0.0,除了 Hadoop 的那一项其他都可以不选 - 硬件配置中,选择
m3.xlarge,1 个 master,2 个 core,不需要 task 节点 - 选择一个之前已经创建过的安全组
- 没有提到的一般不需要修改
- 注意要打好对应的标签。竞价实例可能没办法保证 tag,所以需要检查并添加上(当实例真正启动时)
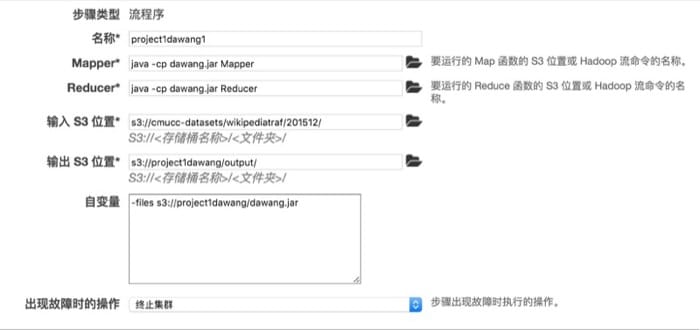
- 在添加步骤中,选择流程序,然后进行配置。输入 mapper 和 reducer 的执行命令
java -cp wordcount.jav wordcountMapper和java -cp wordcount.jar wordcountReducer。然后配置输入输出的地址(也可以在界面上选),这里注意输出的文件夹最好不存在,不然覆盖的时候可能会失败,在参数里设置-files s3://address for jar file。最后选择失败时要执行的操作,这里选择terminate cluster比较好(省钱)。 - 不要选择完成后自动终止,这样我们可以登录到机器上来查看任务详情,但是用完之后务必要手动关闭。
- 检查无误后,点击创建实例之后就可以开始等待了。完成之后可以在 S3 里看到对应的输出,多个 reduce 会有多个结果,可能需要下载下来进行合并。
Writing your own Mappers and Reducers
现在我们就来处理维基百科的数据集了,这里需要写自己的 mapper 和 reducer,在整整一个月的输入数据中,完成下面的任务:
- 设计一个 MapReduce 的工作流,需要完成
- 根据上一个 project 的规则来过滤元素
- 从 mapper 中读取输入的文件名。因为 日期/时间 的信息在文件名当中,所以 Hadoop 流会把文件名放在名为
mapreduce_map_input_file这个环境变量中,每个 map 任务都可以访问。举个例子,python 中用os.environ["mapreduce_map_input_file"],Java 中用System.getenv("mapreduce_map_input_file") - 把每小时的页面浏览记录聚合成每天的页面浏览记录
- 计算每篇文章的总浏览记录
- 对于浏览次数超过 100,000 的页面,用以下的格式进行输出
[月总浏览量]\t[文章名称]\t[第一个日期的浏览量]\t[第二个日期的浏览量]......
- 设计并测试好了 MapReduce 工作流后,使用 EMR 跑 2015 年 12 月的全部数据
- 数据集可以在
s3://cmucc-datasets/wikipediatraf/201512/找到 - 记录下集群的配置以及运行时间(分钟位单位)
- 在 S3 中只使用小写字母和数字,不然会失败
- 数据集可以在
- 结果处理好之后,启动一个
t1.micro实例ami-bcd8f8d6来提交成绩- 把结果从 S3 下载到 这个实例中
- 把输出融合成一个 output 文件
- 用
submitter来测试 mapper 和 reducer
- 完成
runner.sh中的问题 - 使用
submitter来提交最终的答案
一些建议:
- 用竞价实例很省钱
- 只支持 Python 2.7 和 Java 1.7
- 输出格式:
- 日期用
yyyymmdd格式 - 日期要按照时间顺序来
20151201应该在20151202之前 - 所有的页面浏览数据应该输出到一个文件中
- 日期用
一个简单的例子,每一行都必须有 31 天,即使那一天的访问量是 0:
10 Dopamine 20151201:1 20151202:2 20151203:0 20151204:0 20151205:1 20151206:0 20151207:0 20151208:0 20151209:0 20151210:6 20151211:0 20151212:0 20151213:0 20151214:0 20151215:0 20151216:0 20151217:0 20151218:0 20151219:0 20151220:0 20151221:0 20151222:0 20151223:0 20151224:0 20151225:0 20151226:0 20151227:0 20151228:0 20151229:0 20151230:0 20151231:0- 访问 master public DNS:9100 可以访问日志
Grading
一些提交步骤的记录:
- 文件夹位于
/home/ubuntu/Project1_2,有三个文件,可以编辑runner.sh和references - 如果完成了 mapper 和 reducer,可以通过
submitter提交来测试./submitter -a andrewid -l java或者 java 换成 python
- 结果中的第一行表示正确的 mapper 和 reducer
- 得到结果后聚合成一个文件,名字是 output,然后需要完成
runner.sh中的题目 - 其他的要求和之前一样
项目日志
Mapper
首先我们要理解清楚这次的任务是什么,说起来很简单,就是用 MapReduce 把上个项目的工作大概再做一次,借此理解 MapReduce 的编程模型。
实话说,MapReduce 的模型是比较容易理解的,尤其是我们这个项目所用的流程序,唯一需要弄清楚的就是三个步骤:怎么输入,中间怎么处理,怎么输出。
输入输出部分之前的 wordcount 的例子都有讲解,看一下代码应该就能弄明白,这里主要说说中间要怎么处理。
在 MapReduce 中,一切的内容都要转换为键值对,那么我们就需要考虑,键值对的格式是什么,怎么样设计会方便我们处理。
但是在设计之前,我们先大概想一下,具体需要些什么内容。我们需要:
- 文章的日期
- 文章的标题
- 文章的访问量
文章的标题和访问量就在传入的每一行数据中,这个方便处理,但是日期这里,因为是跟输入文件的文件名有关,所以我们得想个办法获取到。对,就是利用环境变量(前面有提到):String env = System.getenv("mapreduce_map_input_file");
可以通过以下命令查看所有文件(如果配置了 aws cli tool )
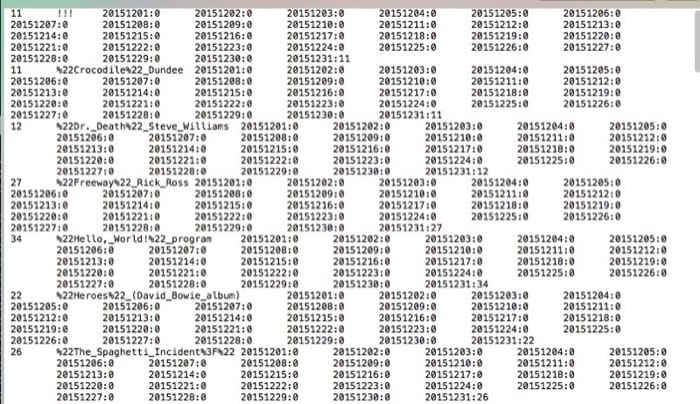
aws s3 ls s3://cmucc-datasets/wikipediatraf/201512/然后获取到的路径大概是这样的格式:s3://cmucc-datasets/wikipediatraf/201512/pagecounts-20151231-230000.gz,所以需要做一些解析,取出我们需要的 20151231 这样的日期。然后结合之前的项目,过滤后输出即可。我得到的结果大概是这样的(我只用了很小很小的测试集),可以通过下面的命令在裁剪数据集:
head -1000000 testdata > smalltestdataReducer
Reducer 要做的工作稍微多一点,比方说要按照规定的格式进行输出,但是本质上和 example 中的逻辑是差不多多少的,毕竟 mapper 中已经把数据过滤得差不多了。这里要注意的就是数值累加即可。得到的数据差不多是这样(这里我修改了阈值来查看输出,如果你也是这样做的,请记得测试完改回去)
代码测试
然后我们可以提交自己的 Mapper.java 和 Reducer.java,测试一下功能正确与否。(注意要把为了本地跑的部分测试代码注释掉,不然就过不了测试,感谢 @jiexing)
启动一个 t1.micro 实例 ami-bcd8f8d6。记得打标签。
先登录:ssh -i demo.pem ubuntu@ec2-54-152-44-36.compute-1.amazonaws.com
用下面的命令把文件复制到机器里:
scp -i demo.pem ./Mapper.java ubuntu@ec2-54-152-44-36.compute-1.amazonaws.com:~/Project1_2/

scp -i demo.pem ./Reducer.java ubuntu@ec2-54-152-44-36.compute-1.amazonaws.com:~/Project1_2/然后可以用下面的代码提交:./submitter -a dawang -l java。如果成功的话,应该可以看到第一栏得到 20 分,那么就可以进行下一步了。
EMR 测试
首先是把对应的内容上传到 S3 中。当然这之前需要打包一下:jar -cvf dawang.jar Mapper.java Reducer.java *.class,然后准备创建 EMR 集群。如下
然后我们多选择一点机器,然后设置一个竞价,如下图:
然后设置一下日志和其他设定:
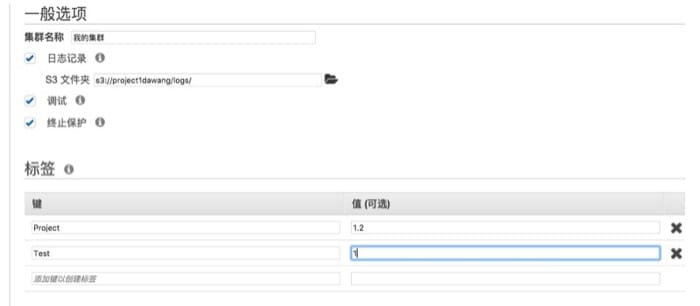
然后就可以创建集群来跑一跑看了。这里记得在竞价实例创建之后,要手动给不同的机器打上标签(如果没有自动生成的话)。
等待竞价实例启动,就可以监控了,如下图:
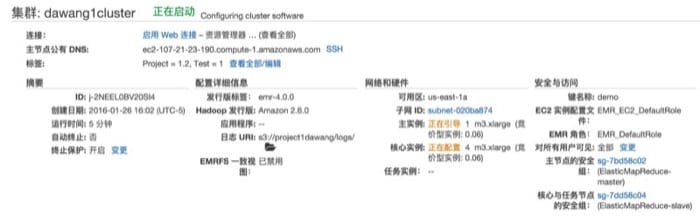
然后果断失败了,因为我的 Java 版本是 1.8,需要切换到 1.7,具体参考这里
简单来说就是:
vi ~/.bash_profile # 输入以下内容
source .bash_profile # 生效新配置
内容是
# Mac默认 JDK 6(Mac默认自带了一个jdk6版本)
export JAVA_6_HOME=`/usr/libexec/java_home -v 1.6`
# 设置 JDK 7
export JAVA_7_HOME=`/usr/libexec/java_home -v 1.7`
# 设置 JDK 8
export JAVA_8_HOME=`/usr/libexec/java_home -v 1.8`

#默认JDK 6
export JAVA_HOME=$JAVA_6_HOME

#alias命令动态切换JDK版本
alias jdk6="export JAVA_HOME=$JAVA_6_HOME"
alias jdk7="export JAVA_HOME=$JAVA_7_HOME"
alias jdk8="export JAVA_HOME=$JAVA_8_HOME"
直接直接可以用 jdk6, jdk7, jdk8 来切换。
经过漫长的等待(约 73 分钟),就可以在 S3 中拿到结果,可以用 aws s3 cp s3://project1dawang/output/ ./output/ --recursive,然后用 cat part-* > output 来进行合并。然后就可以来做最后的计算和分析了。
这里把 instance 上的文件都拷贝到本地来进行测试:
scp -i demo.pem ubuntu@ec2-54-84-88-191.compute-1.amazonaws.com:~/Project1_2/* ./server/然后在下一个阶段完成所有的工作
Runner
先把 runner 复制到本地,用以下命令:
scp -i demo.pem ubuntu@ec2-54-164-94-23.compute-1.amazonaws.com:~/Project1_2/runner.sh ./需要回答的问题是:
- output 文件中有多少行,可以用这个命令
wc -l output | awk {'print $1'} - 过滤后的输出中最不热门的文章是哪个,获得了多少次访问
- 12 月 18 日最热门的文章是哪篇,对应那一天的点击量是多少
- 2015 年 12 月最受欢迎的且在 12 月 1 日没有人访问的页面是那个(实在想不明白为什么会出现顺序影响结果的问题)
- 这个月有多少天,标题是
Twitter的页面的访问次数比标题是Apple_Inc.的页面的访问次数多。 - 给在文件 q6 中出现的电影排序,根据单天最高的浏览量来排(高的在前面),用逗号分隔,没有空格
- 给在文件 q7 中出现的操作系统排序,根据月份最高的浏览量来排(高的在前面),用逗号分隔,没有空格,数量相同需要用字母降序排序
- 有多少数据集中的电影也有对应的电视剧?电影名称
<article_name>_([year_]film),电视剧名称<article_name>_([year]_TV_series),也就是说,article_name必须完全相同,电影和电视剧系列可能跟着一个 4 位数的年份(也就是说可能没有) - Find out the number of articles with longest number of strictly decreasing sequence of views 最长递减子序列的个数,可以一次做完
后面四个问题是不评分的,按照实际情况填写就好。我用的都是 m3.xlarge 类型的 instance,然后一共 4 个 core,时间是:73 min
因为之前终止了实例,所以需要把之前的工作重新上传:
先登录:ssh -i demo.pem ubuntu@ec2-54-84-88-191.compute-1.amazonaws.com
用下面的命令把文件复制到机器里:
scp -i demo.pem ./Mapper.java ubuntu@ec2-54-175-116-84.compute-1.amazonaws.com:~/Project1_2/

scp -i demo.pem ./Reducer.java ubuntu@ec2-54-175-116-84.compute-1.amazonaws.com:~/Project1_2/

scp -i demo.pem ./runner.sh ubuntu@ec2-54-84-88-191.compute-1.amazonaws.com:~/Project1_2/

scp -i demo.pem ./Q4.java ubuntu@ec2-54-84-88-191.compute-1.amazonaws.com:~/Project1_2/

scp -i demo.pem ./Q7.java ubuntu@ec2-54-164-94-23.compute-1.amazonaws.com:~/Project1_2/

# 恢复上次的工作
scp -i demo.pem ./server/* ubuntu@ec2-54-84-88-191.compute-1.amazonaws.com:~/Project1_2/然后可以用下面的代码提交:./submitter -a dawang -l java。
大部分的时间都在为奇奇怪怪又不说清楚的测试集耽误时间,真心觉得这样浪费大家时间没多少意义。差评。
相关文章
- 云计算 第 9 课 Sequential Programming2016-01-20
- 云计算 Twitter 语料分析 5 ETL 导入数据2016-03-09
- 云计算 第 13 课 缓存2016-02-15
- 云计算 第 12 课 深入负载均衡器及其使用策略2016-02-08