云计算 第 13 课 缓存
本页目录
前面我们已经了解了如何进行 autoscaling 和自定义负载均衡器,这一课我们来接触另一个在 web 服务中非常重要的概念——缓存。
学习目标
- 了解在 web 服务中缓存所扮演的角色
- 比较影响缓存的两个方面:temporal locality 和 spatial locality
- 部署一个使用缓存的 web 服务
- 比较不同的缓存策略对性能的影响
先来看看数据格式,保存在 data center 中的数据格式是:
targetID(数字), first_name, last_name, encrypted data(文本)而客户端(在这里就是 load generator)发给 data center 的数据格式是:
Target <targetID> first_name last_name’s encrypted conversations are: <conversations>每个 data center 在同一时间大概能够缓存 10000 条记录,但是面对 load generator 仍然有些力不从心,我们的任务就是利用缓存来提高性能。
不少互联网应用都需要大量的资源,提高性能的方法很多,其中一个就是我们之前尝试过的 horizontal 和 vertical scaling。这种方式虽然比较方便,但是贵呀,能不能在已有资源限制的情况下,尽可能提高性能呢?两个比较常见的办法是『缓存(caching)』和『复制(replication)』。
复制、缓存和负载均衡可以在不对数据进行分割的情况下提高性能。很多工具(比如 Varnish, Squid, memcached)可以完成缓存这项任务,把最常用的资源保存下来。这样有两个好处:
- 系统不必重复运算,节约计算资源
- 可以快速向用户返回结果
另外一个比较常见的方法是『复制』,通常会与缓存结合使用。系统会保存多个全部数据集的副本,这样系统可以同时访问多个不同资源。使用『复制』方法的时候,需要注意以下几点:
- 需要确定一个分配用户请求的策略,可以是内容相关的(即特定请求会重定向至特定机器)或者是内容无关的
- 『复制』的实例本身需要实时监控,避免出现负载不均衡的问题
- 在进行内容写入的时候,还需要保证数据一致性(但是在这次的作业中不要求)
这周我们要处理的系统,后端有两个『复制』的数据库。除了可以应对大负载,某种程度上来说也提高了容错性(比如说数据库损坏)。任何时候,只有一个实例在运行,都是很危险的。具体的架构见下图:
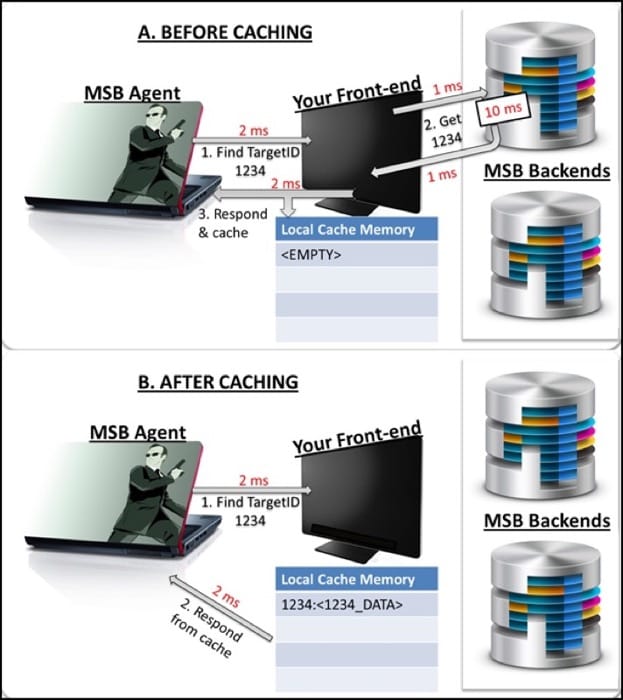
说明以下上图的例子,前端访问数据库需要 1 ms(单向),从数据库中获取数据需要 10 ms,而直接访问前端获取一次数据需要 2 ms(单向),同一条记录,如果没有缓存,那么一共需要 16ms 来完成整个操作,而如果有缓存,则只需要 4 ms。
- Temporal locality: 假如一条记录刚刚被用到,那么很可能之后也会被常用到
- Spatial locality: 假如一条记录刚刚被用到,那么很可能它附近的几条记录也会被用到
另外一个需要注意的是,除了前端这个显式缓存,无论是数据库还是文件系统都会有自己的缓存系统,比方说 data center 会缓存最近的 10000 条记录,我们访问一条没有在前端缓存的记录时,如果它已经被 data center 缓存,那么整个可能寻找数据只需要 6 ms(而不是之前的 10 ms)。
注意事项
- 用 Java 写,Azure 部分就有 100% 的分数,提交的代码中不要出现:
Appid,appkey,storage account key和endpoint url - 最多只能在前端存储 1000 条记录
- 做 AWS 的部分记得打上
Project : 2.3的标签
系统镜像 Azure
- Data Center,
Standard_D1,https://cc15319619.blob.core.windows.net/system/Microsoft.Compute/Images/vhds/cc15619p23dcv5-osDisk.dc552bc1-518d-451e-b856-c0419a6adcdb.vhd - Load Generator,
Standard_D1,https://cc15319619.blob.core.windows.net/system/Microsoft.Compute/Images/vhds/cc15619p23lgv4-osDisk.40d2443e-9f8c-41ce-9826-e0d7792a6c27.vhd - 前端,
Standard_A0,https://cc15319619.blob.core.windows.net/system/Microsoft.Compute/Images/vhds/cc15619p23fe-osDisk.8d5f0df8-c94d-43e0-8a11-77ba440e0d8f.vhd
系统镜像 AWS
- Data Center,
m3.medium,ami-1b193371 - Load Generator,
m3.medium,ami-c00134aa - 前端,
m3.medium,ami-6f2a1f05
缓存测试
研究 trace file 来确定缓存的策略。Data Center 各可以缓存 10000 条记录,并提供以下接口:
/target?targetID=X返回结果并缓存/range?start_range=X&end_range=Y缓存一个范围内的结果(以;分隔)并缓存
任务列表
- 启动一个
Standard_A0虚拟机作为前端 - SSH 到前端,账户
ubuntu密码Cloud@123 - 文件夹
vertx中有MSB.java和run_vertx.sh - 熟悉
MSB.java中的代码 - 启动两个
Standard_D1虚拟机作为 data center - 在
MSB.java文件中,把两个 data center 的 DNS 填写进去,格式为xxx.eastus.cloudapp.azure.com - 修改
retrieveDetails函数,提高性能,现在代码已经是可以运行的,可以运行来体验下整个过程 - 可以在前端机器上存储 1000 条记录以提高性能。具体用什么数据结构和载入策略都可以自己决定。唯一的限制就是不能超出 1000 条的上限。
- 改动完成后可以用下面的命令启动 web 服务:
./run_vertx.sh - 确定代码没有问题后,可以开启一个
Standard_D1虚拟机作为 load generator,在浏览器中访问其 DNS 就可以看到界面 - 提交密码和 andrew id
- 填写前端 DNS 地址以开始 Trace 1 测试,目标是 145 RPS
- 填写前端 DNS 地址以开始 Trace 2 测试,目标是 145 RPS
- 填写前端 DNS 地址以开始 MSB Trace 测试,目标是 145 RPS
- 测试的时候可以在浏览器里查看日志
提示
- 研究清楚 web 服务的代码再开启 load generator 和 data center
- 可以随意修改
MSB.java,唯一需要注意的是不能缓存超过 1000 条记录 - 统计系统中的不同组件的延迟来找出哪里更加需要优化
- 了解 temporal locality 和 spatial locality,思考如何可以在代码中利用这两个特性
- 开始 MSB Trace Test 之前确保已经通过了前两个测试
- 执行
run_vertx.sh之后,可以使用sudo cat nohup.out来查看日志 - 前两个测试可以通过观察请求中的 id 来进行策略设计,但 MSB Trace 测试需要更加复杂的缓存机制
- 我们手头上有两台数据相同的 data center,各有不同的缓存,想想如何利用这个特点来提高效率(不同的请求发送给不同的主机,需要分类)
- 了解同步和异步请求的概念,data center 提供 web 服务对数据库进行异步请求,看看这部分代码是怎么实现的
- 这里只会对数据库进行读取,所以不需要考虑数据一致性的问题
- 只需要提交 MSB Trace Test 的代码,把所有代码放到一个 zip 包里,用 load generator 提交
- 每当 cache 有 miss 的时候,输出一下,找找规律
参考资料
- Rabinovich, Michael, and Oliver Spatscheck. Web caching and replication. Boston, USA: Addison-Wesley...”
- Brewer, Eric A. "Lessons from giant-scale services." Internet Computing, IEEE 5.4 (2001): 46-55
- Sivasubramanian, Swaminathan, et al. "Analysis of caching and replication strategies for web applications." Internet Computing, IEEE 11.1 (2007): 60-66
- Karger, David, et al. "Consistent hashing and random trees: Distributed caching protocols for relieving hot spots on the World Wide Web." Proceedings of the twenty-ninth annual ACM symposium on Theory of computing. ACM, 1997
- Fan, Bin, et al. "Small cache, big effect: Provable load balancing for randomly partitioned cluster services." Proceedings of the 2nd ACM Symposium on Cloud Computing. ACM, 2011
AWS 部分
这一部分是选做的,基本要求一样,有以下需要注意的的:
- 安全组中要打开 80 端口
- AWS 的地址格式和 Azure 的稍有不同
- 性能的要求是 142 RPS
项目日志
首先可以直接利用上个项目的代码,用指定的镜像开好四个机器,检查一下是否开机成功,都没问题之后,就可以 ssh 到我们的 Front End 机器:ssh ubuntu@yourdns.eastus.cloudapp.azure.com,然后把所有文件都复制下来方便本地修改:scp -r ubuntu@yourdns.eastus.cloudapp.azure.com:~/vertx/* ./,里面还是有不少文件的,不过我们这次只需要修改一个 MSB.java。
先来看看具体我们要做什么,观察 MSB.java,会发现这次处理请求的实现方式和之前都不一样,留意以下这一段代码
vertx.createHttpServer().requestHandler(new Handler<HttpServerRequest>() {
    public void handle(HttpServerRequest req) {
        String query_type = req.path();
        req.response().headers().set("Content-Type", "text/plain");
        if(query_type.equals("/target")) {
            String key = req.params().get("targetID");
            processRequest(key,req);
        } else if (query_type.equals("/range")) {
            String start = req.params().get("start_range");
            String end = req.params().get("end_range");
            processRequest(start, end, req);
            }
        }
    }).listen(80);
可以看到这里在 80 端口打开了一个监听器,每次遇到请求,就会调用其中的 handle(HttpServerRequest req) 函数,那么这个函数里做了什么事情呢?
- 根据不同的请求类型,执行不同的请求
- 具体的请求在
retrieveDetail函数中完成
所以具体来说,要做好的是以下四个事情:
- 确定缓存所使用的数据结构
- 确定缓存替换记录的策略
- 确定需要缓存多少请求
- 确定两个 data center 的访问策略
基本上做好这四个事情,就算是完成任务了。修改完成之后可以把文件传回服务器 scp -r ./MSB.java ubuntu@yourdns.eastus.cloudapp.azure.com:~/vertx/
AWS 部分改动不多,改一下 data center 的地址就好,上传的代码为:scp -i demo.pem ./MSB.java ubuntu@dns.compute-1.amazonaws.com:~/,然后 ssh 过去运行 ssh -i demo.pem ubuntu@dns.compute-1.amazonaws.com
这次的作业比较简单,希望以后也能这么开心。
相关文章
- 云计算 第 12 课 深入负载均衡器及其使用策略2016-02-08
- 云计算 第 11 课 Horizontal Scaling and Advanced Resource Scaling2016-02-01
- 云计算 第 10 课 Parallel Programming using EMR2016-01-25
- 云计算 第 9 课 Sequential Programming2016-01-20