云计算 第 9 课 Sequential Programming
本页目录
这一讲我们就要开始实际接触一个真实的项目——处理一个大文本数据集了。在云上编程和平时学习的可能有一些不同,这里会尽量写得详细一些。
先来具体说说这节课的任务:
- 用顺序执行的程序在云上处理一个大文本数据集。
- 在这个过程中了解顺序方法的限制
这次我们会在特定的 AMI(可以理解为系统镜像)上进行操作,注意不能用外部依赖(也就是不能 sudo apt-get install 任何软件或库,即使装了在测试的时候也没办法运行)
数据集来自维基的页面访问统计数据 hourly page view statistics
关于数据集
Wikimedia 会维护所有保存在服务器的对象的每小时页面访问数据并以开放数据集的形式给大家使用。我们会使用这些数据来分析一定时间内页面浏览的趋势。
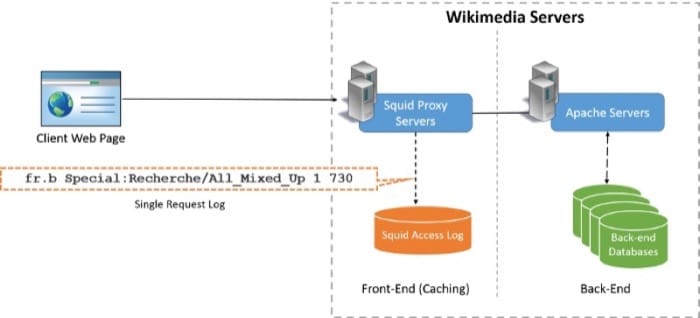 A simplified diagram of a page access form Wikimedia. More information
每个对于维基服务器的请求会被当做一个 squid cache proxy 来进行处理,同时也会把这些请求记录到日志中。这些日志每个小时更新,大家都可以访问。文件里的每一行对应着一次访问记录,格式如下:
[项目名称] [页面标题] [访问次数] [总共返回的字节数][项目名称]包括两个部分,一个是语言标识符和一个子项目后缀,具体如下:
(no suffix): wikipedia.b: wikibooks.d: wiktionary.m: wikimedia.mw: wikipedia mobile.n: wikinews.q: wikiquote.s: wikisource.v: wikiversity.w: mediawiki
举个例子,假设有一行是这样的:
fr.b Special:Recherche/All_Mixed_Up 1 730就说明这条记录的产生是因为有人访问了 French Wikibooks 中的 Special:Recherche/All_Mixed_Up 页面 1 次,并且总共传输了 730 个字节。
这个项目中,我们主要会分析 2015 年 12 月的数据。不过现在我们只需要处理 12 月 1 日的第一个小时的数据。数据在 s3://cmucc-datasets/wikipediatraf/201512/pagecounts-20151201-000000.gz。可以使用 aws-cli, s3cmd 或者 S3 查看器来了解。但是在服务器上,就需要用 wget 来下载了,具体的地址是 https://cmucc-datasets.s3.amazonaws.com/wikipediatraf/201512/pagecounts-20151201-000000.gz
命令为 wget https://cmucc-datasets.s3.amazonaws.com/wikipediatraf/201512/pagecounts-20151201-000000.gz
如果不是很了解如何访问 Amazon S3,可以回头看看云计算 第 2 课 AWS 简介(原文暂缺)
Data Filtering
简单来说,我们要从维基的访问数据中,用各类数据分析的方法,看看能不能找到些什么有意思的东西。
我们会先从第一个小时的维基流量日志开始分析,主要关注英文维基的内容。这种从完整数据的一个子集开始测试起并最终应用到全部数据的方法,在之后的项目中会很有用。
我们先使用 ami-95e9cdff(社区 AMI 中)来创建一个 t1.micro 实例,记得在右上角把地区切换为 弗吉尼亚北部。允许 SSH 和 HTTP 连接(可以使用之前的安全组)。像下面这样:
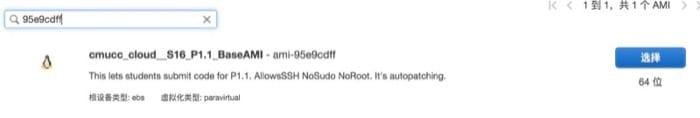
这里我选择的是竞价型实例(因为会便宜一点),但需要注意的是申请成功之后一定要注意重新打上标签:{"Key":"Project","Value":"1.1"} 。
然后我们耐心等待实例创建,然后使用 ssh -i demo.pem ubuntu@ec2-54-165-218-37.compute-1.amazonaws.com 来进行连接,如下图:
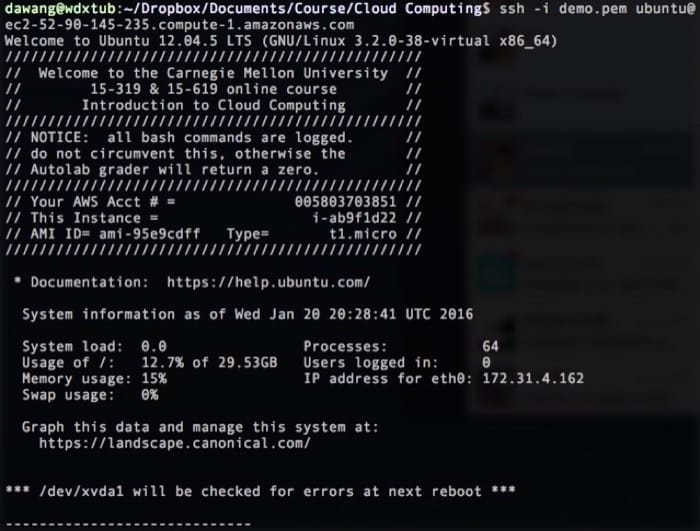
然后进入 Project1_1 文件夹,先把第一个小时的日志文件下载下来,命令为:wget https://cmucc-datasets.s3.amazonaws.com/wikipediatraf/201512/pagecounts-20151201-000000.gz
下载速度还是很快的(20MB/s),然后是一些注意事项:
需要过滤的内容 1
有些行只有 3 个(或更少)元素,需要过滤掉,如
en 1282 10636194
需要过滤的内容 2
那些不是来自英文维基的页面访问需要过滤掉,也就是说,如果某一行不是以 en 开始的(大小写敏感),就需要过滤
需要过滤的内容 3
维基的特殊页面在这里不需要考虑,排除那些以如下字段开始的标题(大小写敏感):
Media:
Special:
Talk:
User:
User_talk:
Project:
Project_talk:
File:
File_talk:
MediaWiki:
MediaWiki_talk:
Template:
Template_talk:
Help:
Help_talk:
Category:
Category_talk:
Portal:
Wikipedia:
Wikipedia_talk:
需要过滤的内容 4
维基的政策规定所有的英文文章都必须以大写字母开头,过滤掉那些以小写字母开头的访问记录。注意,有些页面的标题是非英文字符,应该保留。
需要过滤的内容 5
还有一些记录是引用图片文件的,同样需要过滤掉标题以下列扩展名结尾的记录
.jpg, .gif, .png, .JPG, .GIF, .PNG, .txt, .ico
需要过滤的内容 6
还有一些无关的页面记录需要移除,如果页面标题是如下内容(大小写敏感),需要过滤掉:
404_error/
Main_Page
Hypertext_Transfer_Protocol
Search
这些都完成之后,把剩余的记录用下面的格式输出:
[page title]\t[number of accesses]
注意:
- 你可能会发现语言包括
en,EN和EN,只对en的部分进行处理 - 输出应该根据访问次数降序排列
接下来会用几种不同的方式来完成,我们先解压文件 gzip -d pagecounts-20151201-000000.gz
awk 版本
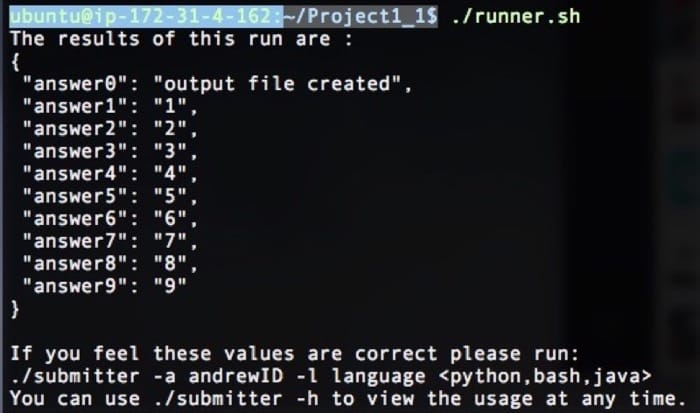
因为第一步只是做简单的文字处理,所以用命令行自带的 awk 应用就可以完成。awk 的用法这里不详细介绍,在 runner.sh 中的 answer_0() 函数中填写下面代码:
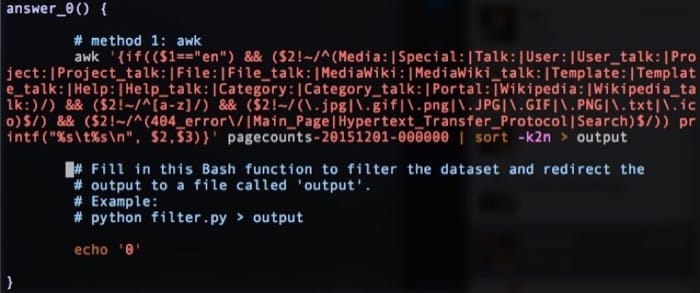
然后执行 ./runner.sh,就可以看到:
我们现在来试着提交一下:
./submitter -a dawang -l bash
如果引用了其他的内容,需要把对应的资料放到 reference 文件夹中,不然抄袭后果很严重。
因为这一问不评分,所以并没有结果。
这里我又用 java 重写了一次,这里建议大家最好在本地测试运行一下再上传到 AWS 上。考虑到 python 性能比较差,所以从一开始就用 java。
Data Analysis
接下来就是完成 runner.sh 中的各项任务了,具体任务如下:
- 输出过滤前所有的行数
- 输出过滤前所有的访问数的总和
- 过滤之后有还剩多少行
- 过滤后的最受欢迎的文章是什么,输出标题即可
- 在过滤后的数据集中,包含『cloud』和『computing』的文章有多少个,这里注意是精确匹配,也不区分大小写
- 过滤后的数据集中最受欢迎的电影的次数,注意,电影的话标题里会有『film』
- 过滤后的数据集中访问次数在 2500~3000 之间的有多少个
- 以一个数字开头,之后是字母的页面有多少次访问(注意是开头,正则表达式要匹配上)
- 是 2014 年的电影更热门还是 2015 年的更热门,搜索『2014_film』和『2015_film』,注意大小写敏感
这里需要注意的是,因为在 runner.sh 中分成了九个不同的函数来做,而其实这些都可以一次处理完,所以我会把结果存在临时文件里,然后用 bash 输出。
如果不想在命令行里编程,可以把文件弄到本地来进行编写,命令如下:
远程到本地
sudo scp -i demo.pem ubuntu@ec2-54-165-218-37.compute-1.amazonaws.com:~/Project1_1/SeqProg.java ./

sudo scp -i demo.pem ubuntu@ec2-54-165-218-37.compute-1.amazonaws.com:~/Project1_1/runner.sh ./
本地到远程
sudo scp -i demo.pem ./SeqProg.java ubuntu@ec2-54-165-218-37.compute-1.amazonaws.com:~/Project1_1/

sudo scp -i demo.pem ./runner.sh ubuntu@ec2-54-165-218-37.compute-1.amazonaws.com:~/Project1_1/
提交用:
./submitter -a dawang -l java
总结
- 一定要认真看题
- 一定要认真看题
- 一定要认真看题
- AWS 上有时候 java 表现会很奇怪,暂时未知
本来打算两种语言都写一下的,但是因为踩了太多坑已经阵亡,最后就只用 Java 实现了(毕竟是会快一点)
相关文章
- 云计算 第 10 课 Parallel Programming using EMR2016-01-25
- 云计算 第 13 课 缓存2016-02-15
- 云计算 第 12 课 深入负载均衡器及其使用策略2016-02-08
- 云计算 第 11 课 Horizontal Scaling and Advanced Resource Scaling2016-02-01