云计算 Twitter 语料分析 1 项目简介
本页目录
项目名称:Twitter Analytics on the Cloud
从这次作业开始,就要小组作业和个人作业并行了。这次的项目主要是在云上分析 Twitter 的相关内容,与以前 GB 级数据不一样,这次我们要处理 TB 级的数据,还是很刺激的。另,这是小组作业,在此先感谢我的队友 @leiyu 和 @shushanc
任务目标
- 在一定预算限制下利用所学知识搭建一个性能高可靠性又好的 web 服务
- 设计、开发、部署和优化服务器以处理比较高的负载(大约每秒上万次请求)
- 在一个大数据集上(约 1TB)实现 Extract Transform and Load (ETL) 并载入到 MySQL 和 HBase 中
- 设计 MySQL 和 HBase 的 schema 并优化配置来提高性能
- 探索寻找基于云的 web 服务中潜在瓶颈的方法,并提高性能
我们需要搭建并优化一个有两个组件的 web 服务,前端负责处理请求,后端负责查询数据,架构如图:
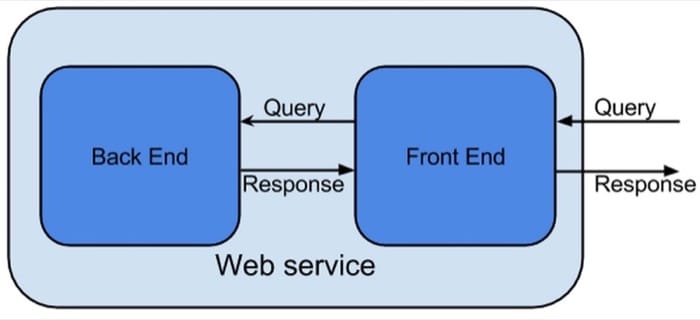
- 前端:能够接收和响应查询请求的 web 服务
- 用过通过指定网址发送 HTTP GET 请求来访问 web 服务。不同的请求有不同的地址,后面跟有不同的参数
- 要返回适当的响应,并且一定要按照指定的格式
- Web 服务需要在持续若干小时的测试中正常运行
- Web 服务不能拒绝请求,应该能够承受高负载
- 后端:保存用来查询的数据文件
- 需要评估 SQL(MySQL) 和 NoSQL(HBase)
- 比较不同数据集不同查询类型的性能表现,然后由此来决定如何实现后端
- Web 服务应该在不超过预算的情况下达到指定的吞吐量
- 钱花得越少越好
- 前端和后端均使用 M 系列的实例,批量处理的时候注意使用竞价实例(总之就是要省钱)
数据集
- 数据集地址为:
s3://cmucc-datasets/twitter/s16/ - 大小超过 1 TB,还会有重复和损坏的记录
- JSON 格式,每行表示一个 tweet,具体看Twitter API.
- 字符编码是 unicode,建议使用下面的库
- simple json/gson(Java)
- 标准库中的 json module(python)
进度安排及制品
项目分三个阶段,每个阶段完成不同的任务,每个阶段完成之后都需要提交制品:
- 性能数据
- 开销分析
- 源代码
- 问答题的答案
- 阶段报告,包括设计选择和制品描述
常见问题
如何提交测试请求?
提交 web 服务的地址即可开始测试,提供不同时间长度的测试,可以有针对性进行选择,比方说如果只是为了检测服务能否正常运行,那么可能几分钟的测试就够了;如果想要看看长时间能否工作,就需要长时间的测试。
到底测试什么?
简单来说,每次提交测试请求之后,系统会产生特定的请求并发送到之前填写的地址,会检测性能和正确性。
为什么提交不了请求了?
为了省钱,每个队伍同时只能用一个测试在跑(或者在排队)
还可以取消当前的测试请求并重新提交
如何计算分数?
主要考察下面几点
- 吞吐量:测试期间平均 RPS
- 延迟:平均每个请求的延迟
- 错误率:不返回 2XX 都是错误
- 正确率:检测是否返回正确的内容,注意仔细检查格式
具体计算公式为:
- 有效吞吐量 = 吞吐量 * (100 - 错误率 / 100) * (正确率 / 100)
- 原始分 = 有效吞吐量 / 目标吞吐量
注意,错误率与正确率都会极大影响最后的分数
任务概览
前端
接收 RESTful 请求并返回响应,不限制所使用的 web 框架,但是需要至少使用两种,并比较他们的异同,最好使用竞价实例,省钱。
最好考虑使用 auto-scaling,因为测试的过程中会有波动。设计前端的时候要考虑到开销,并且写好测试脚本,不然每次都要部署一次很麻烦。
不同的 web 框架的性能也很不一样,如果一开始就选择了比较慢的框架,就相当于选择了 hard 模式,所以开始之前不妨看看主流框架的对比,详情参阅 Techempower
还有一个需要考虑的问题是,选择的前端框架最好有支持 MySQL 和 HBase 的 API,不然可能后面会很麻烦。在报告中注意写清楚为什么选择用某个框架。
选择思路
打开前面给出的 Techempower 网站,可以看到不同框架在不同机器上进行不同测试的成绩,因为我们是在 AWS 上进行部署,所以主要看 EC2 的测试结果(最新的结果是 Round 11 - 2015.11.23 的测试结果)
分为六种测试:
- JSON 序列化
- 单次查询
- 多次查询
- Fortunes 测试(其实就是随机从数据库中返回一句话)
- 数据更新
- 纯文本
因为之前的课程一直都是在用 Java 写,所以就直接只在 Java 框架中选择了,其他的一些过滤条件是:
- 应用操作系统: Linux
- 语言: Java
- 数据库: MongoDB, MySQL
- 数据库操作系统: Linux
这样过滤一下,其实选择就少很多了,我们看看不同框架在这六个测试中的表现(只选取性能较好的一部分):
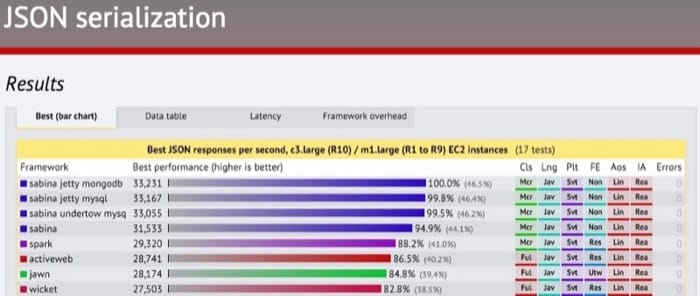
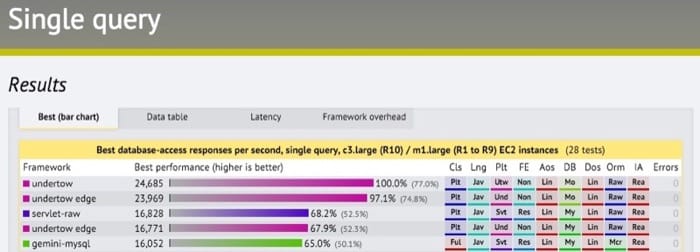
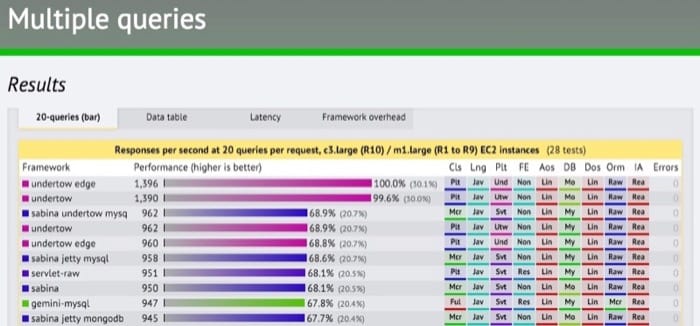
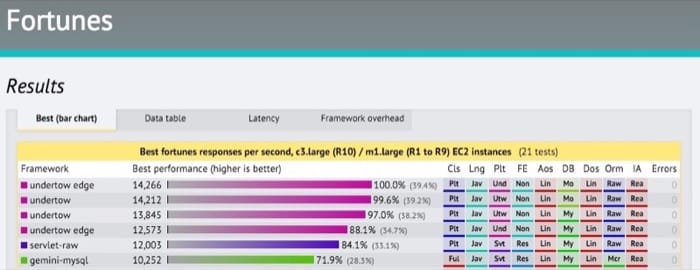
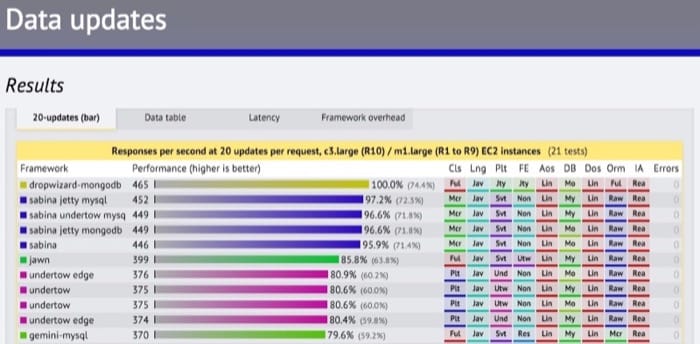
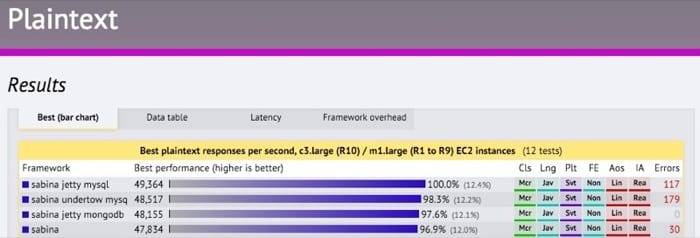
综合一下来看,性能比较好的是:
- sabina
- jetty
- undertow
- gemini
因为我们需要分别对 MySQL 和 HBase 进行操作,所以最好需要有对应的接口(不用自己写太多工具代码,不过其实 Java 都可以方便调用对应的连接器,所以还好),不过在此之前,因为这几个我都没听过,所以大概了解一下。
- Sabina: A Sinatra inspired micro web framework for quickly creating web applications in Java with minimal effort
- 性能不错,但是因为是 Java 8 的框架,而且不算太热门(意味着除了问题难以得到社区支持),所以不考虑
- Jetty:
A Web server and javax.servlet container, plus support for HTTP/2, WebSocket, OSGi, JMX, JNDI, JAAS and many other integrations
- HBase 在产品中还包含了 Jetty,在 HBase 启动时采用嵌入式的方式来启动 Jetty(刚好了)
- 其实和 tomcat 很类似(从文件的组织方式也可以看出来)
- undertow: A flexible performant web server written in java, providing both blocking and non-blocking API’s based on NIO
- 轻量级,比较简单和灵活
- 感觉很适合,至少没有 tomcat 一样一上来就一堆不知道干嘛的文件和文件夹
- gemini
- 企业级应用,感觉太重量级了,暂时不考虑
根据以上分析,决定采用 undertow 作为主要的开发框架。
因为还需要再选择一个框架作为对比(只需要对比一次性能),为了熟悉框架,打算采用 vert.x 来进行测试。
ETL
这部分的工作,需要使用 extract, transform and load (ETL) 把 Twitter 的数据集载入到数据仓库中。先从 S3 中获取大约 200 million tweets,然后把数据存储到目标数据库中,具体的操作取决于数据库设计。最好使用竞价实例,不然很可能会超支。
我们需要使用 AWS 精心设计 ETL 过程,选择合适的实例数量来完成这个工作,完成这个工作后,最好把数据库备份起来,不然每次都要做一次非常浪费钱,使用 EMR 的话,可以用下面这条命令把 HBase 备份到 S3 中
aws emr create-hbase-backup --cluster-id j-3AEXXXXXX16F2 --dir s3://mybucket/backups/j-3AEXXXXXX16F2 --consistent
详情请参阅这里
最好先用小数据集(比如说 200MB)来测试 ETL,不然每次失误的代价就太大了。载入数据库之后最好测试不同的请求类型,确保无误之后再开始后面的工作。
一定要仔细设计数据库的 schema,并据此好好设计 ETL,并确保 ETL 正确工作。因为每次都需要 10-30 个小时,如果需要做几次的话,很痛苦(虽然难以避免,很多时候可能在开发中会修改设计)
早点开始,多多利用并行,比较推荐使用 map reduce 来完成这个工作
后端
实际上就是所有数据存放的地方,前端会连接到后端来进行查询,最后返回对应结果。
这里我们会使用 MySQL 和 HBase,记得阅读提供的资料,可以快速上手。因为预算问题,还是多使用竞价实例。
在导入整个数据集之前,一定要用小数据集做一些测试,并确保后端数据库能返回正确的内容。
相关资源与参考资料
Resources
- Benchmarks of web servers
- Schwartz, B., and P. Zaitsev. "A brief introduction to goal-driven performance optimization." White paper, Percona (2010).
- Practical MySQL Performance Optimization
- HBase Cheat Sheet
Architecting web servers
- Erb, Benjamin. "Concurrent programming for scalable web architectures." Informatiktage. 2012.
- Pariag, David, et al. "Comparing the performance of web server architectures." ACM SIGOPS Operating Systems Review. Vol. 41. No. 3. ACM, 2007.
- McGranaghan, Mark. "Threaded vs Evented Servers"
- Hu, James C., Irfan Pyarali, and Douglas C. Schmidt. "Measuring the impact of event dispatching and concurrency models on web server performance over high-speed networks." Global Telecommunications Conference, 1997. GLOBECOM'97., IEEE. Vol. 3. IEEE, 1997.
Clustering web servers
- Schroeder, Trevor, Steve Goddard, and Byrov Ramamurthy. "Scalable web server clustering technologies." Network, IEEE 14.3 (2000): 38-45.
- Cardellini, Valeria, Michele Colajanni, and S. Yu Philip. "Dynamic load balancing on web-server systems." IEEE Internet computing 3.3 (1999): 28-39.
- Paudyal, Umesh. "Scalable web application using node.js and couchdb." (2011).
Optimizing a Multi-tier System
- Fitzpatrick, Brad. "Distributed caching with memcached." Linux journal 2004.124 (2004): 5.
- Graziano, Pablo. "Speed up your web site with Varnish." Linux Journal 2013.227 (2013): 4.
- Reese, Will. "Nginx: the high-performance web server and reverse proxy." Linux Journal 2008.173 (2008): 2.
Scalable and Performant Data Stores
- DeCandia, Giuseppe, et al. "Dynamo: amazon's highly available key-value store." ACM SIGOPS Operating Systems Review. Vol. 41. No. 6. ACM, 2007.
- Cattell, Rick. "Scalable SQL and NoSQL data stores." ACM SIGMOD Record 39.4 (2011): 12-27.
Web Server Performance Measurement
- Slothouber, Louis P. "A model of web server performance." Proceedings of the 5th International World wide web Conference. 1996.
- Banga, Gaurav, and Peter Druschel. "Measuring the Capacity of a Web Server." USENIX Symposium on Internet Technologies and Systems. 1997.
- Nottingham, Mark. "On HTTP Load Testing"
基本要求
- 给所有的实例打上
15619project:phase1的标签 - 另外,HBase 实例需要打上
15619backend:hbase标签;MySQL 实例需要打上15619backend:mysql标签 - ETL 部分可以选择任何类型的实例
- 前端和后端只能只用 M 系列不超过 large 的实例(large 也是可以用的)
- 可以选择任何免费的镜像,这次需要自己搭建整个系统
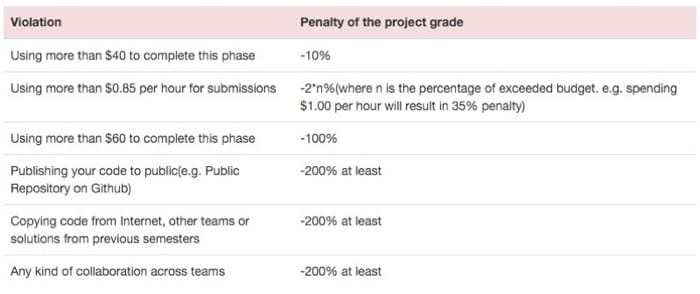
- Web 服务的所有开销加起来不能超过每小时
$0.85(包括 EC2 实例,存储,EMR 和 ELB,不包括网络和磁盘 IO) - 这个阶段每组有
$40的预算
虽然这一部分只占 10%,但是打下的基础很重要,尽可能多学多了解一些。
我们也提供了一个 reference server 方便大家检查结果的正确性,强烈建议在开始导入到数据库之前用 reference server 测试好。也可以利用这个服务器来检测可能出现的编码问题。
这一阶段我们要处理两类请求,从存储系统中获取数据(这一部分我们需要设计和控制),web service 需要能够连接到两个不同的后端存储系统(MySQL 和 HBase),前端需要通过端口 80 接收 HTTP GET 请求。
这次的项目中,我们会设计并开发一个高并行的 web 服务器,可以连接到两种不同类型的数据库。在整个过程中,应该能够了解到不同后端实现的优势和劣势。
最后需要撰写报告,模板在 这里
报告中需要包括 web 框架的如下信息:
- 达到的 RPS
- 资源利用(CPU, Memory)
- 编程难度
- 两个框架的异同
- 适用的不同场景和优劣分析
- 为什么选择这些 web 框架
Query 1 (Heartbeat and Authentication)
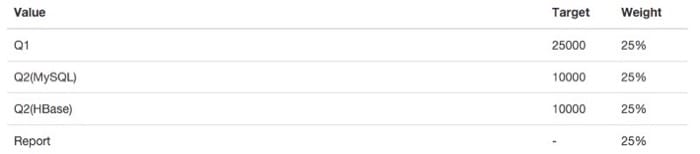
目标吞吐量:25000 rps
这部分的请求会询问 web 服务的状态,前端只需要返回 team id, AWS id, 时间戳以及一段加密的信息。这种机制通常称为心跳机制,但是也可以用来测试前端处理请求的能力。
q1 中的每个请求都包含 key Y 和一段由 key Z 加密的文本,Z 是 X 和 Y 的最大公约数(这里 X 是私钥)。这里我们使用 mythical Phaistos Disc Cipher (PDC) 来加密和解密
PDC 是为长度为完全平方数(4,9,16,25...)的大写英文字母(A-Z)组成的信息所设计的加密方式。我们需要自己进行解密的工作,也就是给定 key 和密文,获取原始的文本
PDC 的过程有三个步骤:KeyGen, Caesarify 和 Spiralize.
- KeyGen 阶段:随机选择一个大整数
Y,计算Y和我们的密钥X的最大公约数,记为Z - Caesarify 阶段:利用
Z生成一个 minikeyK = 1 + Z % 25。我们把消息M中的每个字符都『偏移』K个值,生成中间文本I - Spiralize 阶段:把消息选择写成正方形矩阵(参考下面的例子),然后再一行一行读出来,重排之后的消息就是密文
C.
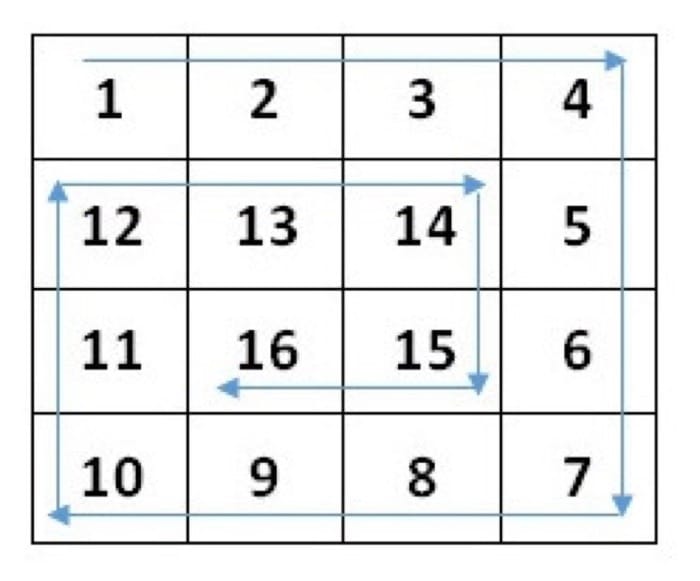
密文是:1,2,3,4,12,13,14,5,11,16,15,6,10,9,8,7(因为这里是数字,所以加上逗号方便区分)
Phaistos Disc Cipher encryption 的例子
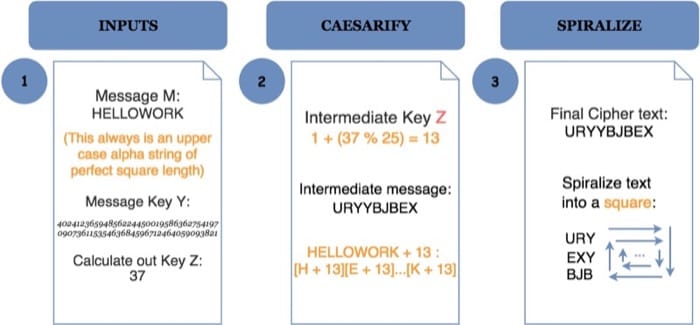
我们需要做的是解密,也就是给定密文 C 和 key Y,需要利用私钥 X 生成 Z,然后用 Z 来还原消息
请求格式
GET /q1?key=<large_number>&message=<uppercase_ciphertext_message_C>
样例
GET /q1?key=4024123659485622445001958636275419709073611535463684596712464059093821&message=URYEXYBJB
响应格式(美东时间 EST)
TEAMID,TEAM_AWS_ACCOUNT_ID\n
yyyy-MM-dd HH:mm:ss\n
[The decrypted message M]\n
样例
TeamCoolCloud,1234-0000-0001
2004-08-15 16:23:42
HELLOWORK
这一部分我们只需要处理前端的问题,暂时不用考虑后端。
Query 2 (Text Cleaning and Analysis)
目标吞吐量: 10000 rps
不允许使用任何已有的缓存应用 (Redis, Memcached, etc.) 或除了 MySQL 和 HBase 之外的数据库。但是可以自己写缓存应用。
在 ETL 阶段可以使用任何类型的实例,比如 c family (Compute Optimized) 和 r family (Memory Optimized),不必只局限于 m family (General Purpose)
MySQL 可以参考官方的优化文档,如果需要的话也可以使用其他版本的 MySQL
HBase: 可以选择用 EMR 来设置 HBase,或者自己搭建,不过自己搭建就要装 zookeeper 之类的,可以自行研究一下。
这里我们会对 Twitter 数据集进行分析,地址是 s3://cmucc-datasets/twitter/s16/part-00XXX,XXX 从 000 到 661。
会查询某个用户用指定的 hashtag 发的 tweet,主要考察如何设计一个高效的后端来处理大量的请求。
我们会提供 user id 和 hashtag(具体参考这里),需要返回该用户所有带此 hashtag 的 tweet,具体格式如下:
- tweet 的 sentiment density
- tweet 的发布时间
- tweet id
- 审查修改过的的 tweet 内容,这里有很多可能出问题的地方,比如 emoji 表情、反斜杠、其他语言的字符等等,都需要小心处理
Here is how you can obtain this information:
- 利用 tweet 的内容来计算 sentiment density
- tweet id 可以从
id或id_str里获取 - 时间可以从
created_at里获取 - Tweet 的内容可以从
text里获取,应该在计算完 sentiment density 再进行内容审查 - hashtag(s) 可以从
entities里获取,如果同一个 hashtag 在一条 tweet 中出现多次,只应该返回那条 tweet 一次
注意事项:
- 需要过滤掉重复的 Tweets(有相同的 id),返回响应的时候一条 tweet 只应该出现一次
- 满足下面条件的 tweet 也应该被过滤掉
id和id_str为空或者没有这两个域created_at、text或entities为空或者直接没有这几个域- 无法被解析为 JSON 对象的记录
- Hashtag matching 需要百分百匹配(每个字节都一致),例如 "Naive", "naive" 和 "naïve" 是不匹配的
情感密度
按照下面四个步骤来计算 Sentiment Density
- 文本切分:把推文分隔成一个一个词,注意,这里堆单词的定义是:one or more consecutive alphanumeric characters ([a-zA-Z0-9]+) separated by non-alphanumeric character(s) ([^a-zA-Z0-9])
- 计算情感得分:简单来说,就是有一个小写字母的英文单词情感词典,只要推文中的某个词在这个词典里,就加上这个词的情感得分(初始分为零),情感词典来自 AFINN 数据集,在这里下载
- 例如:"I love Cloud Computing" 这句话的得分是 3,因为 love 这个单词在情感词典中,且分值为 3
- 计算有效词数量:也就是过滤掉 stop words。所谓 Effective Word Count(EWC) 可以这样计算 EWC = 总单词数目 - 停止词的数目
- 例如:"I love Cloud Computing" 的 EWC 是 3,因为 "I" 是一个停止词
- 计算 Sentiment Density:如果 EWC 是 0,那么 Sentiment Density 就是 0,如果 EWC 不为 0,那么计算公式是 Sentiment Score / EWC
所有的计算结果都四舍五入保留三位小数 (1 -> 1.000, 1.1->1.100, 1.0005 -> 1.001, 1.9999 -> 2.000, -1 -> -1.000, -1.1-> -1.100, -1.0005 -> -1.001, -1.9999 -> -2.000, etc.)
一个完整的例子:
"I love Cloud Computing" 的 Sentiment Density 为 1.000, 因为它的 Sentimental Score(3) 除以 EWC(3) 是 1.000.
文本审查
简单来说就是有敏感词,列表是经过 ROT13ed 处理的。例如,假如一个敏感词是 15619ppgrfg 那么原文就是 15619cctest。具体的敏感词列表在这里下载
一定要先计算情感值然后再进行文本审查,遇到敏感词,把除第一个和最后一个单词都替换成星号(*).
例如,假设 cloud 是敏感词,如果原文是
I love Cloud compz... cloud TAs are the best... Yinz shld tell yr frnz: TAKE CLOUD COMPUTING NEXT SEMESTER!!! Awesome. It's cloudy tonight.
那么返回的时候,应该是这样:
I love C***d compz... c***d TAs are the best... Yinz shld tell yr frnz: TAKE C***D COMPUTING NEXT SEMESTER!!! Awesome. It's cloudy tonight.
可以选择在 ETL 过程中完成所有的运算(MapReduce 的时间更长,花费也就更高),或者在每次返回请求的时候运算(如果你写的代码足够快的话)
ETL 的过程中需要处理很多 corner case,可能会出现很多不清晰的地方,所以这里提供了一个参考文件(小数据集),是第一个数据集(s3://cmucc-datasets/twitter/s16/part-00000) ETL之后的结果,每一行对应输入文件的的一行,每一列以 \t 分隔,具体如下;
- 第 1 列:tweet id.
- 第 2 列:user id.
- 第 3 列:tweet date.
- 第 4 列:sentiment density.
- 第 5 列:审查后的 tweet 内容,去掉了某些字符,如 newline (\n), tab (\t) etc
- 第 6 列:hashtags(可能为空)
注意处理好各种可能的奇奇怪怪的情况,注意处理好各种可能的奇奇怪怪的情况,注意处理好各种可能的奇奇怪怪的情况。
请求格式
GET /q2?userid=uid&hashtag=hashtag
样例
GET /q2?userid=2324314004&hashtag=LinkedIn
响应格式(如果有对应的推文)
TEAMID,TEAM_AWS_ACCOUNT_ID\n
Sentiment_density1:Tweet_time1:Tweet_id1:Cencored_text1\n
Sentiment_density2:Tweet_time2:Tweet_id2:Cencored_text2\n
Sentiment_density3:Tweet_time3:Tweet_id3:Cencored_text3\n
...
样例
TeamSecret,1123-5813-2134
0.308:2014-04-15 11-42-18:456034778891169793:RT @AlexanderCrepin: How To Find The Best #LinkedIn Groups To Join - - #personalbranding #jobhunt - - http://t.co/ixH5dOf88E
0.267:2014-06-01 19-34-25:473185820636356608:RT @tonyrestell: How To Build Relationships And Win Interviews Through #LinkedIn http://t.co/ELZgPnp4gY #jobhunt tips from @mocksource
响应格式(如果没有对应的推文)
TEAMID,TEAM_AWS_ACCOUNT_ID\n
\n
一些细节
Tweet_time的时间格式是 format:yyyy-MM-dd HH-mm-ss (UTC time, 24-hour clock)- 在 ELT 阶段,换行符 '\n' 应该被替换成两个符号 '' + 'n',而在返回请求时需要换回来
- Tab 需要替换成空格
- 排序规则
- 首先看
Sentimental_density,降序 - 如果前面数值相同,那么看
Tweet_time,时间按照升序排列 - 如果还相同,看
Tweet_id,id 按照升序排列,小的在前面
- 首先看
相关文章
- 云计算 Twitter 语料分析 10 搭建数据分析网络应用2016-04-01
- 云计算 Twitter 语料分析 9 用 CDH 5 搭建基于 Hadoop 2.0 的 HBase2016-03-22
- 云计算 Twitter 语料分析 8 处理复杂读请求2016-03-17
- 云计算 Twitter 语料分析 7 探索 HBase2016-03-13