云计算 第 21 课 Kafka / Samza 动手玩
本页目录
终于来到最后一课,这次我们来接触一下 Spark 中的流处理。
学习目标
- 了解大数据处理中的流处理模型
- 理解 Kafka 和 Samza 如何做到高分布式,容错的流处理
- 用 Samza API 设计和实现一个处理 GPS 数据流处理方案,用于提供类似 Uber 的服务
- 了解 Samza 中带状态的流处理,并一次生成乘客-司机匹配列表
现在生成数据的速度越来越快,很多应用需要实时处理,所以类似 Hadoop 和 Spark 这种数据获取和数据处理分离的方式就不太适用。因此流处理技术应运而生,有别于传统的数据处理方式,能够实时(或近实时)处理大量数据。
Apache Kafka
Kafka 是一个分布式的发布-订阅消息系统,使用 commit 日志来持久化数据。commit 日志是一个有序、不可变、只能添加的数据结构。我们可以认为 Kafka 是一个流数据源,下面是一些完成这次作业所需要理解的术语:
- Topics: 表示一个用户定义的类型,消息会在这个类型下发布。主要以 partitioned log 来 维护。
- Partitions: Topics 被分成不同的 partition。一个 partition 是 Kafka 中并行的单位。一般来说,partition 越多,吞吐量就越多。每个 partition 中每条消息都有特定的偏移量,这样数据消费者能借此定位。简单来说,我们可以认为 Kafka 会根据 key 来给数据排序并提供给,类似于 MapReduce 中的 Map 和 Shuffle 阶段
- Producers: 用来向 Kafka 集群中的一个或多个 topic 发送消息的进程
- Consumers: 从 Kafka 集群中读取消息的进程
- Brokers: 用来负责消息的持久化和复制,Producer 和 Consumer 通过 Brokers 来发送和获取消息
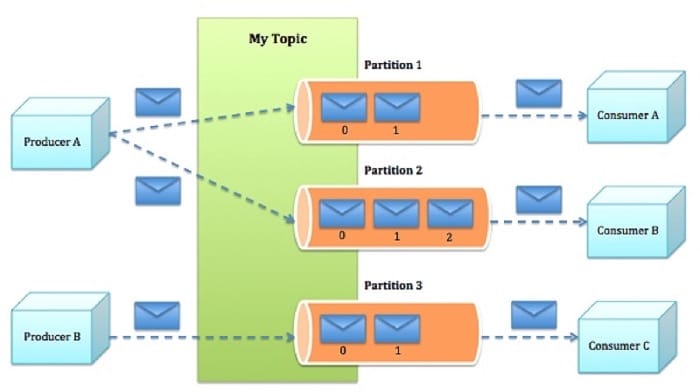
这个项目中 Kafka 用作流数据源,由 Kafka 生成的数据将由 Samza 流处理框架进行处理。需要注意,Kafka 自身不会对数据进行任何处理,只是一种存储和数据分配方式。我们要做的是用 Samza 来处理 Kafka 提供的数据流。
Apache Samza
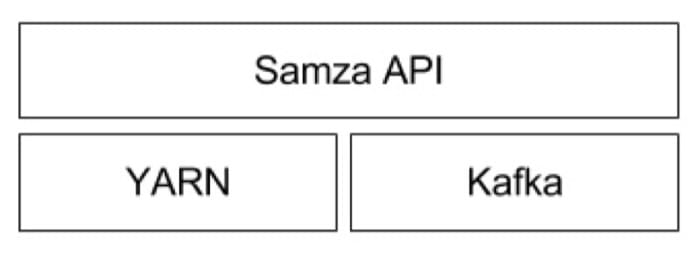
Samza 是由 LinkedIn 开发的分布式流处理框架,也是如下所示的三层流处理架构中的关键组件
- Streaming 层以 partitioned stream 的方式提供输入,这里也就是 Kafka
- Execution 层在不同机器间调度协调任务,这里使用 YARN
- Processing 层负责具体的数据处理,这里使用 Samza
Samza 相关的术语有:
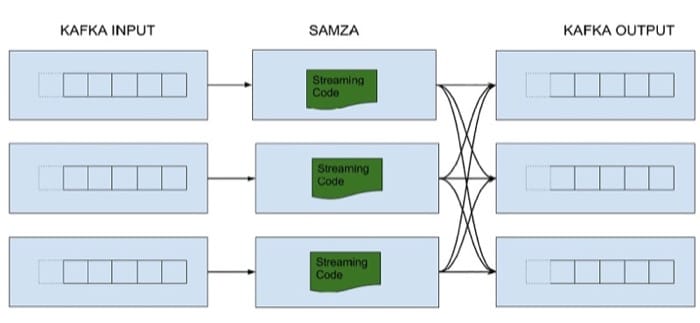
- Streams: 等同于 Kafka topic
- Jobs: 使用 Samza API 来从一个或多个流读取和处理数据。一个 job 可能被分割成不同的 task,每个 task 可能会使用输入流中的一个或多个 partition
- Stateful stream processing: 流处理可以分为有状态和无状态两类。无状态因为不需要同步比较简单。对于有状态的处理,Samza 通过在内存中存储键值对来保存状态,并且会在写入存储的同时复制到 changelog 流中保存到 Kafka 中用来容错。Samza 支持 RocksDB,我们这次也会使用这个
整体架构如下
API
Samza API 设计简单,已经把大部分流处理的复杂度抽象走了。一次处理一条消息,更多样例代码在这里
public class FanOutTask implements StreamTask, InitableTask, WindowableTask {

  private KeyValueStore<String, String> socialGraph;
  private KeyValueStore<String, Map<String, Object>> userTimeline;
  private long numMessages = 0;

  @Override
  @SuppressWarnings("unchecked")
  public void init(Config config, TaskContext context) throws Exception {
    socialGraph = (KeyValueStore<String, String>) context.getStore("social-graph");
    userTimeline = (KeyValueStore<String, Map<String, Object>>) context.getStore("user-timeline");
  }

  @Override
  @SuppressWarnings("unchecked")
  public void process(IncomingMessageEnvelope envelope, MessageCollector collector, TaskCoordinator coordinator) {
    String incomingStream = envelope.getSystemStreamPartition().getStream();
    if (incomingStream.equals(NewsfeedConfig.FOLLOWS_STREAM.getStream())) {
      processFollowsEvent((Map<String, Object>) envelope.getMessage());
    } else if (incomingStream.equals(NewsfeedConfig.MESSAGES_STREAM.getStream())) {
      processMessageEvent((Map<String, Object>) envelope.getMessage(), collector);
    } else {
      throw new IllegalStateException("Unexpected input stream: " + envelope.getSystemStreamPartition());
    }
  }
  ...
}
所有的 Samza job 必须实现 StreamTask 接口,以及另外两个可选接口 (InitableTask, WindowableTask)。InitableTask 接口用来处理初始化工作,init 函数会首先被调用,这里它初始化 RocksDB 来存储本地状态。
WindowableTask 接口用来执行那些定期需要执行的函数。这个项目中用不着。
我们主要写的 Samza 代码是 process 函数。每个 stream 的每个 message 都会调用这个函数。IncomingMessageEnvelope 参数封装了消息,theMessageCollector 参数可以用来发送其他消息,这个例子把两个实时流(FOLLOWS_STREAM 和 MESSAGES_STREAM)连接到一起,从两个流的消息都会到达 process 函数中。
流相关的处理可以通过调用 getStream() 函数来创造一个条件分支,这个项目中我们会连接两个 Kafka 流。
接下来我们来看看 newsfeed-fan-out.properties 文件(在 src/main/config 中)
# Job
job.factory.class=org.apache.samza.job.yarn.YarnJobFactory
job.name=newsfeed-fan-out
yarn.package.path=file://${basedir}/target/${project.artifactId}-${pom.version}-dist.tar.gz

# Task
task.class=com.martinkl.samza.newsfeed.FanOutTask
task.inputs=kafka.newsfeed-follows,kafka.newsfeed-messages
task.checkpoint.factory=org.apache.samza.checkpoint.kafka.KafkaCheckpointManagerFactory
task.checkpoint.system=kafka
# Normally this would be 3, but in development we have only one broker.
task.checkpoint.replication.factor=1

# Interval at which user timelines are truncated
task.window.ms=300000

# Serializers
serializers.registry.json.class=org.apache.samza.serializers.JsonSerdeFactory
serializers.registry.string.class=org.apache.samza.serializers.StringSerdeFactory

# Kafka
systems.kafka.samza.factory=org.apache.samza.system.kafka.KafkaSystemFactory
systems.kafka.samza.msg.serde=json
systems.kafka.consumer.zookeeper.connect=localhost:2181/
systems.kafka.producer.metadata.broker.list=localhost:9092

# Social graph store tracks who is following who
stores.social-graph.factory=org.apache.samza.storage.kv.LevelDbKeyValueStorageEngineFactory
stores.social-graph.changelog=kafka.newsfeed-social-graph-changelog
stores.social-graph.key.serde=string
stores.social-graph.msg.serde=string

# User timeline is a list of recent messages sent by a particular user
stores.user-timeline.factory=org.apache.samza.storage.kv.LevelDbKeyValueStorageEngineFactory
stores.user-timeline.changelog=kafka.newsfeed-user-timeline-changelog
stores.user-timeline.key.serde=string
stores.user-timeline.msg.serde=json
这个文件中主要关注以下几个部分:
task.class: 在这个类中实现process函数和StreamTask接口task.inputs: 输入流,这里的话就是 2 个 Kafka 流stores.social-graph.*: All the configuration for the social-graph KV store that we refer to from the code. The changelog field controls the name of the stream to which changes to the KV store are persisted (for fault tolerance).stores.user-timeline.*: Same as above but for the user-timeline KV store.
任务目标
- 打标签:
Project:4.3 - Load Generator:
ami-cfa3b1a5,t2.large
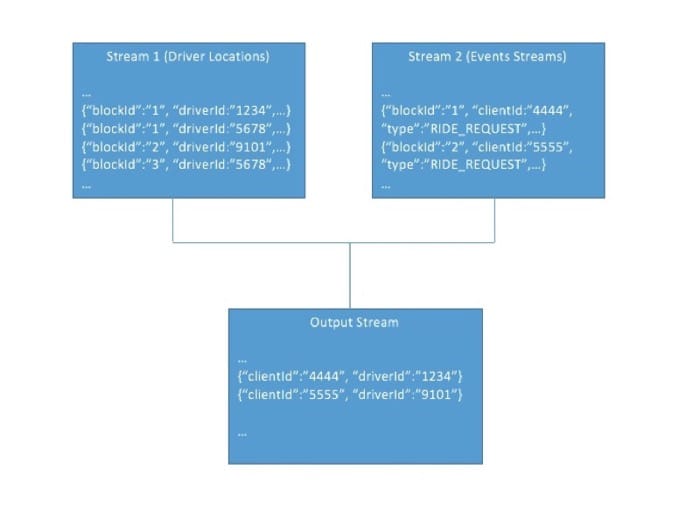
处理两个流并输出客户-司机配对流(需要返回得分最高的),完成 DriverMatchTask.java
启动 Samza 集群
具体配置
- EMR (emr-4.1.0)
- 3 个 m1.large(1+2)
- 选择 Core Hadoop 作为需要安装的应用
- 把 .pem 文件上传到 master 并登录上去 hadoop@xxx
- 设置 .pem 文件的权限位 400
- 下载 Samza 安装脚本
wget https://s3.amazonaws.com/cmucc-public/p43/deploy.sh && chmod +x deploy.sh - 执行
./deploy.sh - 重新登录 master
测试安装
- 进入文件夹
cd hello-samza - 执行
deploy/samza/bin/run-job.sh --config-factory=org.apache.samza.config.factories.PropertiesConfigFactory --config-path=file://$PWD/deploy/samza/config/wikipedia-feed.properties - 等一下再执行
deploy/kafka/bin/kafka-console-consumer.sh --zookeeper localhost:2181 --topic wikipedia-raw - 如果显示对 Wiki 的实时修改,那么启动成功
流信息
driver-locations空闲司机地址,在 Kafka 的driver-locationstopic 下。提交时会自动删除已有的名为driver-locations的 topic 并让负载生成器生成对应数据流。在process函数中调用getMessage()函数时会得到一个包含如下内容的 JSON 字符串blockId: 司机所在的 block. The stream is partitioned on this field. 意味着我们只要考虑同一个 block 的司机(也只有同一个 block 的司机)driverId: 司机唯一的 idtype: 设置为DRIVER_LOCATIONlatitude, longitude: 地理位置,用来比较是否合适- 例如
{"blockId":76,"driverId":9394,"latitude":3075,"longitude":3828,"type":"DRIVER_LOCATION"}
events包含来自用户和司机的事件。在 Kafka 的eventstopic 下。提交时会自动删除已有的名为events的 topic 并让负载生成器生成对应数据流。在process函数中调用getMessage()函数时会得到一个包含如下内容的 JSON 字符串blockId: 用户或司机所在 block。The stream is partitioned on this field. 意味着我们只要考虑同一个 block 的司机(也只有同一个 block 的司机)clientId/driverId: 用户或司机的唯一 id。如果类型是RIDE_REQUEST,那么 id 是用户的,其他时候都是司机的。latitude, longitude: 在ENTERING_BLOCK,RIDE_COMPLETE和RIDE_REQUEST事件中都会出现,用来更新位置和比较是否合适gender: 性别M/F,在ENTERING_BLOCK和RIDE_COMPLETE事件中会出现。gender_preference: 在RIDE_REQUEST中会出现,所希望的司机性别("M" for male, "F" for female and "N" for no preference).rating: 司机评分,从 0.0 到 5.0,在ENTERING_BLOCK和RIDE_REQUEST事件中会出现salary: 司机今天挣到的钱,从 0 到 100,在ENTERING_BLOCK和RIDE_COMPLETE事件中可以看到status: 只在LEAVING_BLOCK或ENTERING_BLOCK中出现,保存司机当前的状态:AVAILABLE或UNAVAILABLEtype: 具体类型LEAVING_BLOCK司机到另一个 block 或者下线,会有旧的 blockId,用这个来更新本地状态,例如一个司机从 block 1 到 block 2,这个事件会带有 blockId 1ENTERING_BLOCK司机到另一个 block 或者上线,会有新的 blockId,用这个来更新,例如一个司机从 block 1 到 block 2,这个事件会带有 blockId 2RIDE_REQUEST用户在某个 block 请求用车,找到最匹配的司机并写入到输出流中RIDE_COMPLETE用车结束,会有司机当前的位置,意味着司机又可以接客了
- 一些例子
{"blockId":76,"driverId":6977,"latitude":3476,"type":"ENTERING_BLOCK","status":"AVAILABLE","longitude":3827,"gender":"M","rating":4.0,"salary":50}{"blockId":34,"clientId":127,"latitude":2323,"longitude":1823,"type":"RIDE_REQUEST","gender_preference":"N"}{"blockId":77,"driverId":8560,"latitude":3606,"type":"ENTERING_BLOCK","status":"UNAVAILABLE","longitude":3640}{"blockId":58,"driverId":8560,"latitude":3606,"longitude":3640,"type":"LEAVING_BLOCK","status":"UNAVAILABLE"}{"blockId":95,"driverId":12833,"latitude":2874,"longitude":4975,"type":"RIDE_COMPLETE","gender":"F","rating":4.5,"salary":83}
可以假设每个 RIDE_REQUEST 都有至少一个司机符合要求。输出流的格式如下:
match-stream输出流,必须是一个 JSON 字符串clientId: 用户 iddriverId: 分数最高的司机 id
Bonus 部分的输出流
match-stream输出流,必须是一个 JSON 字符串clientId: 用户 iddriverId: 司机 idpriceFactor: 对应的 SPF
分值计算
- distance 40% 欧拉距离
distance_score = 1 - (client_driver_distance)/MAX_DISTMAX_DIST这里取 500
- gender 20%
- 如果 match 则为 1,如果为 N 也为 1,其他不匹配的时候为 0
- rating 20%
rating_score = rating / 5.0
- salary 20%
salary_score = 1 - salary / 100.0
最终公式 match_score = distance_score * 0.4 + gender_score * 0.2 + rating_score * 0.2 + salary_score * 0.2
额外任务
根据需求关系动态调整价格,计算对应的 SPF 值(Surge Price Factor)
- 对于每个
RIDE_REQUEST事件,当前 block 可用的司机数量称为 Driver Ratio, R - 计算 R 的平均数 A = AVG(R),需要平均的数值是当前的 R 与之前 4 个请求的 R 值。对于前四个请求,SPF 直接可以输出 1.0
- 如果 A >= 3.6,则供需平衡,SPF 为 1.0
- 如果 A < 3.6,计算 surge factor,
SF = (4 * (3.6 - A)/(1.8 - 1)),而SPF = 1 + SF
一个例子
过去 5 个 RIDE_REQUESTS 对应的司机数量为 4, 2, 2, 2, 6。平均数 AVG(R) 为 3.2。小于 3.6,所以要 Surge,计算 SF = (4 * (3.6 - A)/(1.8 - 1)) = (4 * (3.6 - 3.2) /(1.8 - 1) = (4 * 0.4/0.8) = 2.0,继而 SPF = 1 + SF = 1 + 2.0 = 3.0
工作步骤
- 下载样例代码
wget https://s3.amazonaws.com/15-319-s16/driver-match.tgz - 解压
tar xvf driver-match.tgz - 完成
DriverMatchTask.java
可以通过 friendly submitter (在 driver-match/src/) 生成样例流 ./submitter_task1 -t(需要 load generator,AMI 已提供,只需要开好并对应填写地址,就不需要再做任何操作),可以通过 kafka-console-consumer.sh 查看 driver-locations 和 eventsstreams。记得打开所有的端口
执行代码的步骤
- 进入代码根目录,有 pom.xml 的文件
- 确保
driver-match/src/main/config/driver-match.properties对应值yarn.package.path,systems.kafka.consumer.zookeeper.connect和systems.kafka.producer.bootstrap.servers - 建立部署文件夹
mkdir -p deploy/samza - 构造包
mvn clean package - 移除之前的构建文件
rm -rf deploy/samza/* - 解压所需 jar 包
tar -xvf ./target/pitt_cabs-0.0.1-dist.tar.gz -C deploy/samza - 放到 HDFS 上
hadoop fs -copyFromLocal -f target/pitt_cabs-0.0.1-dist.tar.gz / - 执行 Samza Job
deploy/samza/bin/run-job.sh --config-factory=org.apache.samza.config.factories.PropertiesConfigFactory --config-path=file://$PWD/deploy/samza/config/driver-match.properties - 如果一切正常,就会开始等待两个流。可以在
http://[master-ip]:8088监控 YARN 的状况,检查/var/log/hadoop-yarn/containers/[application-id]/[container-id]/中的日志(日志文件夹会在 container 所在的机器上,通过 YARN UI 来找到对应的 container) - 可以通过
kafka-console-consumer.sh查看输出流(在~/hello-samza/deploy/kafka/bin)
提交方法
- 登录到 master,进入代码文件夹
- 执行
submitter_task1(在driver-match/src/中) 来提交 - 如果 submitter 没有反应,很可能是因为输出流没有内容(Samza job 有错误),从 YARN 日志中找到问题
提交之后需要等待页面刷新时重新 deploy 服务,才能开始测试,之前启用的脚本都需要关闭。
Bonus 提交
- 登录到 master,进入代码文件夹
- 运行
src/文件夹中的submitter_bonus
常用命令
Kafka 命令
所有的命令都是在 master 上运行,并且需要在 /home/hadoop/hello-samza/deploy/kafka/bin 中
- 在 Kafka 集群中创建一个 topic
kafka-topics.sh --zookeeper localhost:2181 --create --topic my-topic --partitions [number-of-partitions] --replication-factor 1 - 描述一个 topic
kafka-topics.sh --zookeeper localhost:2181 --describe --topic my-topic - 列出所有 topic
kafka-topics.sh --zookeeper localhost:2181 --list - 消耗一条消息
kafka-console-consumer.sh --zookeeper localhost:2181 --topic my-topic - 删除一个 topic
kafka-topics.sh --zookeeper localhost:2181 --delete --topic my-topic
调试 Samza
- 通过 YARN UI 来查看状况
http://[master-ip]:8088 - 输出 debug 信息,可以在 YARN container 的日志中看到
/var/log/hadoop-yarn/containers/[application-id]/[container-id]/stdout(需要先确定执行 task 的 container) - 查看日志
var/log/hadoop-yarn/containers/[application-id]/[container-id]/stderr和/var/log/hadoop-yarn/containers/[application-id]/[container-id]/samza-application.log - 可以写入到 Kafka 输出流之后就用
kafka-console-consumer.sh来 debug
其他命令
scp -i ../demo.pem ../demo.pem hadoop@ec2-52-201-245-130.compute-1.amazonaws.com:~/

scp -i ../demo.pem -r ./driver-match/* hadoop@ec2-52-201-245-130.compute-1.amazonaws.com:~/driver-match/

./kafka-console-consumer.sh --zookeeper localhost:2181 --topic match-stream

mvn clean package; rm -rf deploy/samza/*; tar -xvf ./target/pitt_cabs-0.0.1-dist.tar.gz -C deploy/samza; hadoop fs -copyFromLocal -f target/pitt_cabs-0.0.1-dist.tar.gz /

deploy/samza/bin/run-job.sh --config-factory=org.apache.samza.config.factories.PropertiesConfigFactory --config-path=file://$PWD/deploy/samza/config/driver-match.properties