云计算 第 20 课 Spark / GraphLab 动手玩
本页目录
MapReduce 虽好,但是对于需要迭代的计算,步骤繁琐且效率不高,于是振臂一呼,有了 Spark。这节课我们来通过具体的任务学习 Spark 相关知识和编程技巧。
学习目标
- 使用 Spark 框架在大数据集上进行分布式迭代应用开发
- 利用 PageRank 分析 Twitter 社交图谱来找到最有影响力的用户
我们前面使用 MapReduce 的时候,虽然数据是并行处理的,但是一般只需要一个 Map 和 Reduce 过程。随着 MapReduce 越来越广泛的使用,在面对诸如机器学习这种比较复杂的工作(许多多次迭代)时就有些力不从心了。在迭代计算中,前一次迭代的结果是这一次迭代的输入,但是使用 MapReduce 时,这些中间结果需要被写入到 HDFS 中,然后再由下一次迭代从 HDFS 中读取,需要在 IO 上浪费太多时间。那么能不能把数据保存在内存中,并且仍以某种机制保证容错性,以便能大幅提高效率呢?
答案当然是肯定的,于是我们有了 Spark。
Apache Spark
更多的介绍我会专门写日志介绍,这里主要是课程提供的一些信息。
简介
Spark 是由 UC Berkeley AMPLab 开发的开源集群计算框架,在特定的应用中,基于内存计算使其性能可以比 MapReduce 快 100 倍。下面的视频是 Spark 简介
在 Spark 框架中,最重要的是一类新的数据抽象,叫做 Resilient Distributed Dataset - RDD。RDD 是分布式存储在集群中的内存对象,按照值的范围或者哈希结果进行划分。与此同时 RDD 会记录关于数据进行的各种操作(每次操作都会生成新的 RDD),这样即使节点挂掉,也能够根据之前的操作日志重新得到损失的 RDD
我们可以用多种方式来操作 Spark:
- Shells - Python, Scala
- APIs - Java, Scala, Python, R
这里通过计算 abcd 出现的次数的例子来说明 RDD 可用操作
- 载入
>>>input_RDD = sc.textFile("text.file") - Transformation,应用某种操作来生成新的 RDD
>>>transform_RDD = input_RDD.filter(lambda x: "abcd" in x) - 动作,计算并返回结果
>>>print "Number of abcd:" + transform_RDD.count()
了解了基本概念,我们来看看 Spark 是如何工作的。假设我们需要在图上应用机器学习算法,Spark 会先把图保存为 RDD,具体要执行的算法会存储在 Spark Client 中,并根据算法映射到不同的 Spark 操作,最终 Cluster Manager 会把这些 Spark 操作具体调度到其他的 Worker 上进行执行。Spark 支持按照不同的因素进行调度,如优先级、实践、所需资源等等。具体如下所示:
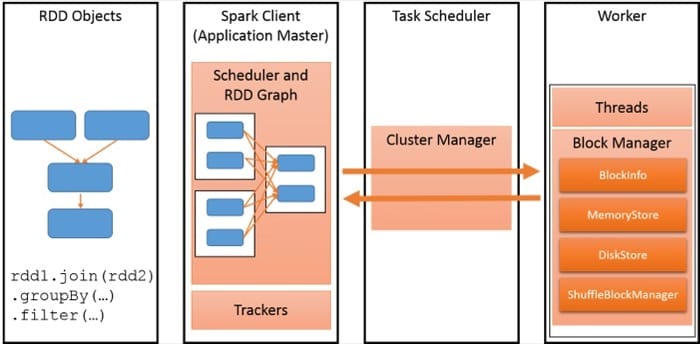
使用 Spark 的时候,我们需要自己写驱动程序(driver program)来连接 Spark 集群,驱动程序定义了一个或多个 RDD,并在其中执行不同的动作。驱动程序也会通过有向无环图(DAG)来记录所有的操作。Worker 是一直都在运行的进程,这样我们才能把 RDD 保存在内存中。
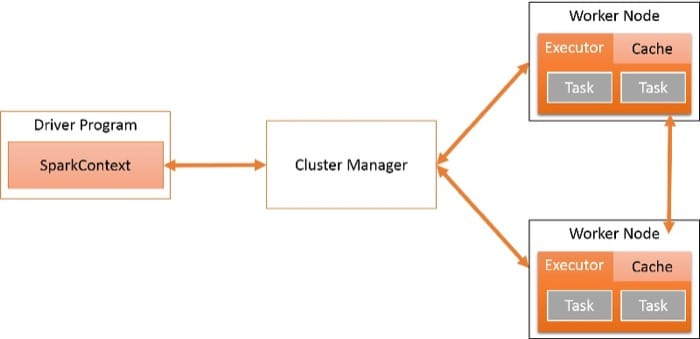
SparkContext 对象可以连接到不同类型的集群管理器来进行调度。集群管理区会隔离不同的 Spark 应用,目前 Spark 支持用 Scala, Java 和 Python 编写的程序。SparkContext 连接到集群管理器之后,就会让 Worker 节点进行计算。注意不同的应用有其 Executor。
这种机制的好处是隔离,坏处也就是数据共享不便。每个 Spark 应用都有自己的一组进程,运行 main() 函数的进程将是 driver,负责创建 SparkContext 对象,之后按照上图所示流程进行操作。
最后了解一下 Spark 生态系统
- Spark SQL: 类似 Hive,支持在不同 RDD 上进行类似 SQL 的操作
- Spark Streaming: 对于流数据进行处理
- MLlib: 机器学习库
- GraphX: 图并行框架
编程初步
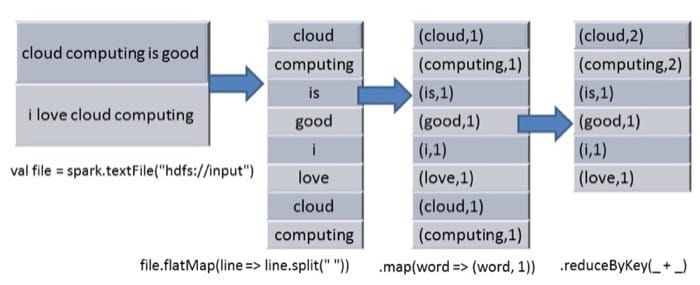
还是通过经典的统计单词出现次数的例子来进行讲解,这里提供三种语言版本。
Scala,这里注意下划线是语法糖,其中 reduceByKey(_ + _) 等于 reduceByKey(case (a, b) => a + b),这里的 case 是 Scala 特有的概念,更多的 Scala Spark 代码可以参见这里
val file = spark.textFile("hdfs:///input")
val counts = file.flatMap(line => line.split(" ")
                 .map(word => (word, 1))
                 .reduceByKey(_ + _)
counts.saveAsTextFile("hdfs:///output")
Java
JavaRDD file = spark.textFile("hdfs:///input");

JavaRDD words = file.flatMap(new FlatMapFunction() {
  public Iterable call(String s) { return Arrays.asList(s.split(" ")); }
});

JavaPairRDD pairs = words.mapToPair(new PairFunction() {
  public Tuple2 call(String s) { return new Tuple2(s, 1); }
});

JavaPairRDD counts = pairs.reduceByKey(new Function2() {
  public Integer call(Integer a, Integer b) { return a + b; }
});

counts.saveAsTextFile("hdfs:///output");
Python
file = spark.textFile("hdfs:///input")
counts = file.flatMap(lambda line: line.split(" ")) \
             .map(lambda word: (word, 1)) \
             .reduceByKey(lambda a, b: a + b)
counts.saveAsTextFile("hdfs:///output")
下图描述了这个过程,具体不再讲解
这里多讲一些 Scala 中的 Map 和 Reduce 函数,主要是 map(func) 和 flatMap(func),以及 reduce(func) 和 reduceByKey(func) 的区别,请仔细阅读下列代码
rdd = (1, 2, 3, 4),
rdd.map(x => (x, x + 1)) => ((1, 2), (2, 3), (3, 4), (4, 5))
rdd.flatMap(x => (x, x + 1)) => (1, 2, 2, 3, 3, 4, 4, 5)

rdd = (1, 2, 3, 4)
rdd.reduce(case (a, b) => a + b) => 10

rdd = ((1, 2), (1, 3), (2, 4), (2, 5))
rdd.reduceByKey(case (a, b) => a + b) => ((1, 5), (2, 9))
启动 Spark 集群
有两种方式启动 Spark 集群,简单的是使用 AWS EMR,详细的指引在这里,大致的步骤为:
- 创建集群 - 高级选项
- 在设置中选择 Amazon EMR-4.2.0,勾上 Spark
- 软件设置中填写
[{"classification":"spark","properties":{"maximizeResourceAllocation":"true"}}](不配置的话将无法最大程度利用硬件) - 名字、实例类型及数量、标签、EC2 密钥一并设置
- 开启成功之后,可以 ssh 到 master 并使用
spark-submit来提交任务,或者也可以在代码中添加步骤
另一种方式是使用 ec2 脚本,具体的步骤在这里,还有一个简单的介绍视频,这里不再赘述。
GraphLab
CMU 开发的分布式 graph parallel 框架,用来在大数据上执行机器学习和数据挖掘算法。GraphLab 把具体的计算抽象成为节点(vertex),而计算之间的数据关系抽象成为边(edge)。
GraphLab 使用以节点为中心的模型,用户的程序会被表示为一个更新函数,作用于一个中心节点及其相邻的边和节点(是不是和 PageRank 的计算过程很配?)具体的计算可以同步通过 Bulk Synchronous Model(BSP) 来完成,也可以通过弹性一致性模型异步完成。
在 GraphLab 1.0 中,数据以边来切分(edge-cut),也就是说一条边连接的两个端点可能在不同的机器上。如下图所示:
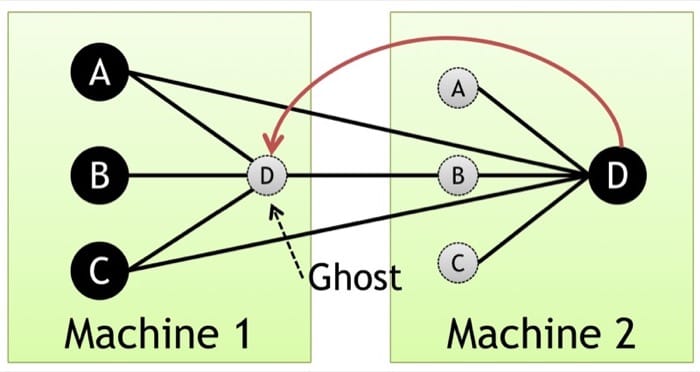
但是在 GraphLab 2.0(PowerGraph) 中,考虑到类似社交网络这样的图会有超级热点(power-law property),如果仍旧用边切分,可能会出现超级节点和其他节点大多数时候处于不同的机器上,这样就会导致性能损失。所以 GraphLab 2.0 选择使用节点来划分(vertex-cut)。这样的好处是,一条边连接的两个节点肯定在一台机器上,对于每个节点来说,可能会有几个不同的复制,其中一个将成为 master,其他的则是 mirror,如下图所示:
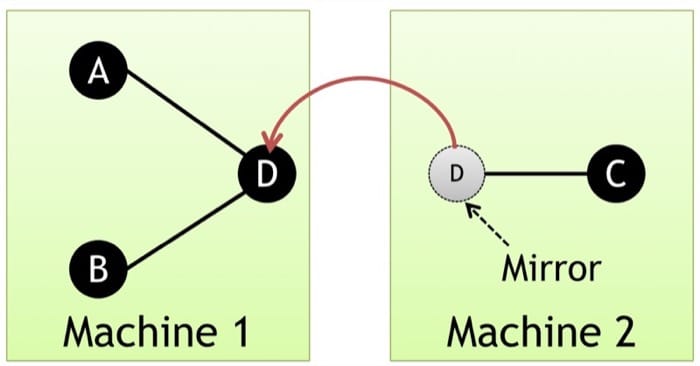
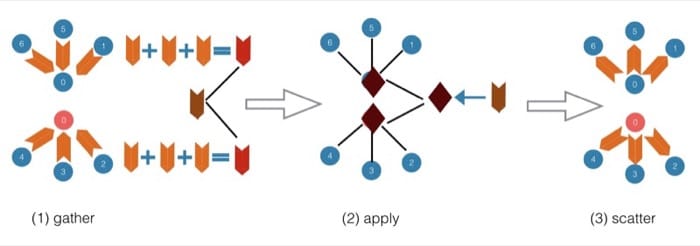
具体的编程和我们之前的方式也有些不同,我们编写的程序会在每个节点上运行,具体有 3 个步骤:
- Gather: 对于每个节点来说,其 master 和 mirror 节点会从相邻的边和节点收集所需信息
- Apply: 所有收集到的信息会在 master 节点完成计算并更新节点,完成之后这个改动会同步到其他的 mirror 节点中
- Scatter: master 和 mirror 节点选择更新对应相邻的边和节点,收到消息的节点会被激活,继续执行对应的计算
之后提到的 GraphLab,统一指 GraphLab 2.0.
启动 GraphLab 集群
这里我们就不能使用 EMR 了,需要手动配置,具体步骤如下:
- 在这里下载 GraphLab
- 解压并进入
PowerGraph-master/scripts/ec2- 进入
graphlab-master文件夹,执行doxygen可以生成文档,具体在graphlab-master/doc/doxygen/html中,点击index.html就可以在浏览器中查看文档了
- 进入
- 在环境变量中配置 AWS 密钥
export AWS_ACCESS_KEY_ID=[your AWS access key]export AWS_SECRET_ACCESS_KEY=[your AWS secret key]
- 启动 GraphLab 集群
./gl-ec2 -k [keypair] -i [key-file] -t [instance-type] -s [num-slaves] -r us-east-1 -a ami-89adafe3 launch [cluster-name] - 给刚启动的实例打上标签
Project:4.2 - 使用该命令登录
./gl-ec2 -k [keypair] -i [key-file] -r us-east-1 login [cluster-name] - 使用该命令关闭集群
./gl-ec2 -k [keypair] -i [key-file] -r us-east-1 destroy [cluster-name]
任务目标
- 打标签
Project:4.2 - 提交
AMI for bonus 2(GraphLab): ami-e1f5fa8b,m1.small - 使用 AWS EMR 的 Spark,注意不能使用 GraphX 和 MLlib 中的函数(就是要自己写)
任务 1 遍历 Twitter 社交图谱
有大 V 的地方,就有江湖。想要混入江湖,就要跟好大 V。
这里使用的数据集来自 Kwak,共 8.66 GB。在 s3://cmucc-datasets/TwitterGraph.txt 可以下载到。
具体数据存着的边列表,格式是 (u,v) 表示 u 关注了 v。
我需要做的是找到『边』和『节点』的数量,注意 (u,v) 和 (v,u) 是两条边。
提交方式
- 登录到 master 机器,下载
https://s3.amazonaws.com/15-319-s16/task1_submitter.tgz - 解压并进入文件夹
- 在
answer文件中填写答案,并把代码复制到task1文件夹中 - 运行
./submitter进行提交
工作日志
- 开启 EMR Spark 之后,登录
ssh -i ../demo.pem hadoop@ec2-52-207-252-75.compute-1.amazonaws.com - 安装 tmux
sudo yum install tmux - 复制数据
hadoop distcp s3://cmucc-datasets/TwitterGraph.txt / - 制作一个测试数据并放到 hdfs 中
hadoop fs -put ./test.txt / - 查看文件
hadoop fs -ls / - 进入 spark-shell
Spark Shell 部分
scala> val textFile = sc.textFile("hdfs:///test.txt").cache
// 因为 Lazy Evaluation,所以直到执行这一句才载入,测试数据也正好是我们需要的 1000 行
scala> textFile.count()
res1: Long = 1000

// 统计用户和边数量
scala> val userCount = textFile.flatMap(line => line.split("\t")).cache
scala> val q1Count = userCount.map(id => (id, 1)).reduceByKey(_ + _).cache
scala> q1Count.count()

scala> val edgeCount = textFile.map(id => (id, 1)).reduceByKey(_ + _).cache
scala> edgeCount.count()

// ----------------
// 重启 spark-shell
scala> val textFile = sc.textFile("hdfs:///TwitterGraph.txt").cache
// 统计行数,顺带载入 cache
scala> textFile.count()
res0: Long = 517970607

// 继续执行各项统计,会分成不同的任务执行
scala> val userCount = textFile.flatMap(line => line.split("\t")).map(id => (id, 1)).reduceByKey(_ + _).cache
scala> userCount.count()
res1: Long = 2315848

scala> val edgeCount = textFile.map(id => (id, 1)).reduceByKey(_ + _).cache
scala> edgeCount.count()
res2: Long = 517970363
得到数据后,提交测试一下
- 下载提交器
wget https://s3.amazonaws.com/15-319-s16/task1_submitter.tgz - 解压
tar xvf task1_submitter.tgz; cd task1
任务 2 计算每个用户的粉丝数量
这个任务的执行,需要运行给定的 submitter 来进行提交。
具体的步骤为:
- 下载
https://s3.amazonaws.com/15-319-s16/task2-follower.tgz - 写一个 spark 程序,生成如下的数据
[user_id]\t[num_followers]- Python 的话脚本名为
follower.py - Java/Scala 的话打包为
follower.jar且 main class 为Follower
- Python 的话脚本名为
- submitter 会在 home 目录运行 Spark 程序,可以在
task2文件夹中用下面命令进行测试- Python:
spark-submit follower.py - Java/Scala:
spark-submit --class Follower follower.jar
- Python:
- submitter 会寻找在
hdfs://follower-output中的输出,不需要自己进行 merge 和 sort - 把所用的代码文件拷贝到
task2文件夹中的src文件夹中,在references中记下有用的链接 - 最终提交命令
chmod +x follower-submitter; ./follower-submitter
工作日志
- 下载提交器
wget https://s3.amazonaws.com/15-319-s16/task2-follower.tgz - 解压
tar xvf task2-follower.tgz; cd task2 - 需要自己用 sbt 压缩成 scala 的 jar 包(Mac 上测试通过)
brew install sbtsbt clean; sbt package
- 拷贝到 EMR 中
cp ./q2/target/scala-2.10/follower_2.10-1.0.jar ./follower.jar; scp -i ./demo.pem ./follower.jar hadoop@ec2-54-86-168-196.compute-1.amazonaws.com:~/task2/ - 清理输出文件夹(如果之前测试了的话)
hadoop fs -rm -r /follower-output - 提交即可,我的用时是 171s
任务 3 根据影响力给用户排序
这里主要使用的是 PageRank 算法,具体不赘述,参考下图的公式:
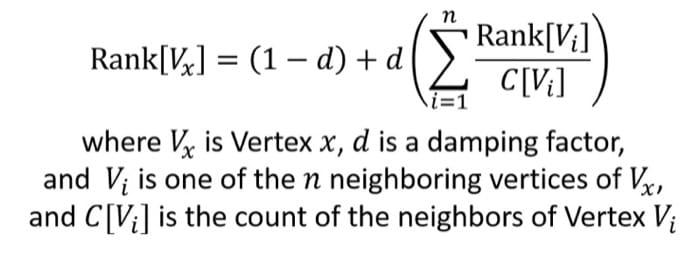
PageRank 实现细节
- Initial Rank values
- 初始值每个用户都是 1,可以用一个
map操作来完成
- 初始值每个用户都是 1,可以用一个
- Damping Factor
- 也就是上面公式中的 d,这里我们用
0.85
- 也就是上面公式中的 d,这里我们用
- Output Format
- 输出格式要和输入格式一样,这样才能保证能够迭代进行计算
- Dangling Users
- 指的是那些不关注任何人的用户,每次迭代需要重新分配其权重
举个例子,一开始的输入数据是:
key: user1 rank: 1.0 follows: user2 user3
key: user2 rank: 1.0 follows: user3 user1
经过第一次迭代之后,会得到如下的分布,这里稍微解释一下,为什么 user1 得到的是 0.5 呢?因为我们可以看到只有 user2 关注 user1,而 user2 一共关注了 2 人,所以其权重被平均分成两份,于是就是 0.5;user2 得到 0.5 也是同理。而 user3 被 user1 和 user2 关注,各从他们身上拿到了 0.5,所以是 1.
key: user1 contributions received: 0.5 follows: user2 user3
key: user2 contributions received: 0.5 follows: user3 user1
key: user3 contributions received: 1.0 follows:
这里 user3 没有关注的人,就成了『异类』,所以必须把这类节点的权重平均分给所有的节点,这里 user3 的初始权重是 1,因为一共有 3 个用户,可得:
user1 = 0.15 + 0.85 * (0.5 + 1.0/3) = 0.8583
user2 = 0.15 + 0.85 * (0.5 + 1.0/3) = 0.8583
user3 = 0.15 + 0.85 * (1.0 + 1.0/3) = 1.2834
之后就继续按照这样的模式计算下去,直到指定次数或者收敛(排名不再变动)
执行与提交
复制数据 hadoop distcp s3://cmucc-datasets/TwitterGraph.txt /
- 下载
wget https://s3.amazonaws.com/15-319-s16/task3-pagerank.tgz- 解压
tar xvf task3-pagerank.tgz; cd task3
- 解压
- 写一个 spark 程序,生成如下的数据
[user_id]\t[PageRank_value],共进行10次迭代- Python 的话脚本名为
pagerank.py - Java/Scala 的话打包为
pagerank.jar且 main class 为PageRank
- Python 的话脚本名为
- submitter 会在 home 目录运行 Spark 程序,可以在
task3文件夹中用下面命令进行测试- Python:
spark-submit pagerank.py - Java/Scala:
spark-submit --class PageRank pagerank.jar
- Python:
- submitter 会寻找在
hdfs:///pagerank-output中的输出,不需要自己进行 merge 和 sort - 把所用的代码文件拷贝到
task3文件夹中的src文件夹中,在references中记下有用的链接 - 最终提交命令
chmod +x pagerank-submitter; ./pagerank-submitter
使用的命令
sbt clean; sbt package

cp ./q3/target/scala-2.10/pagerank_2.10-1.0.jar ./pagerank.jar; scp -i ./demo.pem ./pagerank.jar hadoop@ec2-52-207-241-86.compute-1.amazonaws.com:~/task3/

# 清理输出文件夹(如果之前测试了的话)
hadoop fs -rm -r /pagerank-output
Bonus 1 加速!Spark!
任务很简单,就是让任务 3 能在 30 分钟内完成,具体的步骤也是一样的。下面是一些技巧:
- 优化代码。深入理解 RDD manipulation。理解 Spark 中的 lazy transformation。仔细思考是否需要、何时需要使用
cache(),collect(),persist(),unpersist()函数,可以在这里进一步了解 - 监控实例的状态,看看有没有充分利用,如果是资源不够的话,考虑多申请一些。参考命令
htop,iotop,iostat - 了解 Spark 的参数,如
spark.driver.memory,spark.executor.memory,spark.executor.cores,spark.python.worker.memory,可以在这里进一步了解 - 因为 RDD 是只读的,并且我们的 PageRank 需要迭代十次,所以会有许多中间结果 RDD 或者 grabage。垃圾回收可以极大提高性能,对应的参数是
spark.memory.fraction,spark.memory.storageFraction,可以在这里进一步了解
Bonus 2 在 GraphLab 上实现 PageRank
在前面的计算中,我们可以发现 PageRank 需要其邻居的相关信息,这就和 graph parallel 模型非常搭。这个任务中,我们会用 GraphLab 来实现 PageRank。具体的步骤为
- 开启 GraphLab 集群并登录到 master 实例中
- 进入
graphlab/apps/pagerank目录,可以看到pagerank.cpp文件,我们需要完成这份代码- 改好之后传过去
scp -i demo.pem ./pagerank.cpp ubuntu@ec2-52-91-192-149.compute-1.amazonaws.com:~/graphlab/apps/pagerank/
- 改好之后传过去
- 完成之后,进入
graphlab/release/apps/pagerank文件夹,执行make来进行编译 - 编译之后,在当前目录下使用
~/graphlab/scripts/mpirsync来把程序分发到所有的机器上 - 使用下面的命令来运行 PageRank 应用,进行 15 次迭代
mpiexec -hostfile ~/machines -n [num_of_machines] ./my_pagerank --graph ~/data/ --iterations 15 --saveprefix [path_of_output]
- 收集所有的输出文件,并在 master 实例中 merge
提交方式
- 开启一个
ami-e1f5fa8b的m1.small实例,并把输出文件拷贝过来 - 把数据载入到 MySQL 数据库中,可以用
mysql -uuser -ppassword cc来登录数据库,表名为bonus - 数据载入之后,使用
sudo nohup python server.py 80 &启动服务器 - 进入
Project4_2/bonus目录,把pagerank.cpp文件复制过去并执行submitter_bonus来进行提交