云计算 第 18 课 基于云数据仓库的 OLAP
本页目录
之前的任务我们主要做的是 OLTP 的工作,这节课我们来接触一些 OLAP 数据仓库相关的内容,主要是 Hive, Impala 和 Redshift。
学习目标
- 比较 Online Transaction Processing(OLTP) 与 Online Analytic Processing(OLAP) 系统的异同,并讨论 OLAP 在商业智能系统中扮演的角色
- 通过在 Hive 上运行典型的商业智能请求来分析在数据仓库中使用 MapReduce 编程模型的优劣
- 通过在 Impala 上运行典型的商业智能请求来分析在数据仓库中使用 Massive Parallel Programming engine 的优劣,并对 schema 和 query 进行优化
- 通过设计和优化表结构(sort key 与 distribution key)来利用诸如 Redshift 这样的大型并行系统的并行处理
背景知识
OLTP vs OLAP
我们先来比较以下 OLTP 与 OLAP,这个视频介绍了相关内容。
下面是一个简单粗暴的对比图:
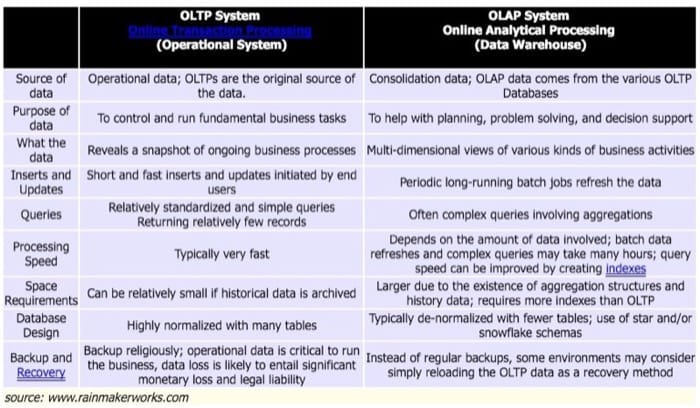
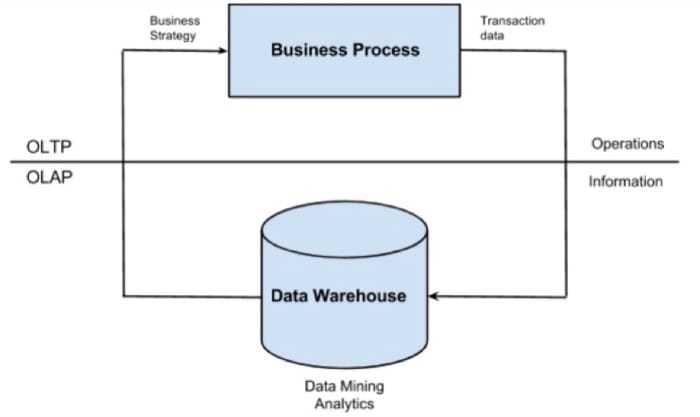
具体的定义如名称所示,一个是处理事务,一个主要用来分析, OLTP 针对『写』优化,OLAP 针对『读』优化,大概知道这个就可以了,架构和分界线为:
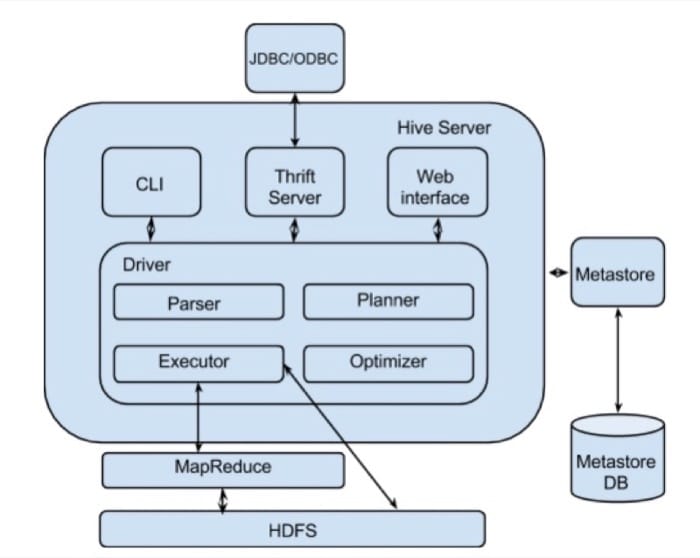
Hive
具体的定义可以查阅官方文档,这里做简要介绍。
- 基于 Hadoop
- 数据存储在 HDFS(或其他文件系统,如 Amazon S3)
- 使用类似 SQL 的语法(称为 HiveQL,与 SQL 的比较可以参考这里)
- 使用 MapReduce 框架进行查询带来了比较严重的延迟(每个请求都是一个 MapReduce job)
- 主要用作批量数据处理
Impala
具体的定义可以查阅官方文档,这里做简要介绍。
- 基于 Hadoop
- 数据存储在 HDFS(或其他文件系统,如 Amazon S3)
- 使用类似 SQL 的语法
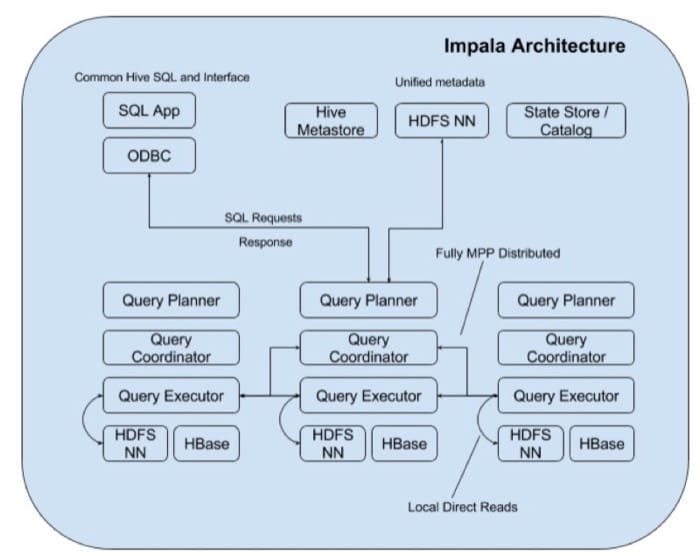
- 为低延迟查询设计,最快的 SQL-on-Hadoop 系统
- 使用 Massive Parallel Programming(MPP) engine 来直接访问集群中的数据
主要组件
- Impala Daemon
- 集群中每个 DataStore 的守护进程,称为
impalad。可以通过 JDBC, ODBC 或者impala-shell进行查询。和 statestore 一直保持连接,也会从catalogd中接收广播消息
- 集群中每个 DataStore 的守护进程,称为
- Impala Statestore
- 检查健康状况,守护进程为
statestored,整个集群只需要一个这样的进程
- 检查健康状况,守护进程为
- Impala Catalog Service
- 用来描述集群的基本信息,守护进程为
catalogd,整个集群只需要一个这样的进程
- 用来描述集群的基本信息,守护进程为
Redshift
具体的定义可以查阅官方文档以及这个视频说明,这里做简要介绍。
- Amazon AWS 提供的 Database-as-a-Service 产品
- 并非基于 MapReduce 和 HDFS
- 通常用于实时查询
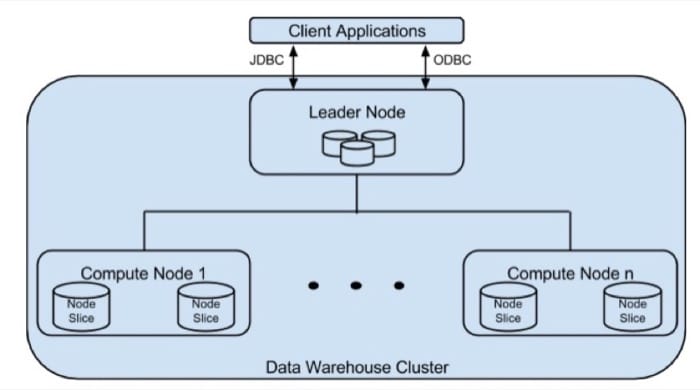
主要组件
- Leader Node
- 处理客户端请求,连接 compute nodes
- Compute Nodes
- 执行由 leader node 发来的代码
- 具体会分为不同的 node slices,一个核就是一个 slice,分别处理不同的数据
- 创建表的时候需要指定 distribution key(用来分 slices)
- 列存储(而非行存储),可以进行压缩,节约空间与 IO 带宽
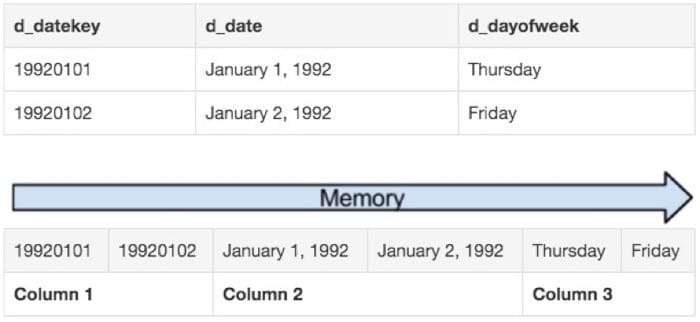
创建步骤
- 创建一个集群,输入数据库名称,用户名与密码
- 选择机器类型与集群类型
- 可以选择是否加密(不加密),选择安全组,其他默认即可
- 开启即可
- 点击『Connect Client』,可以下载对应的连接器(里面有详细的说明)
- 建议使用 SQL WorkbenchJ 来进行测试连接(需要填写各种相关信息)
- 使用完成之后注意关闭
Hadoop 文件格式
SequenceFile
SequenceFile是Hadoop API 提供的一种二进制文件,它将数据以 <key,value> 的形式序列化到文件中。这种二进制文件内部使用Hadoop 的标准的Writable 接口实现序列化和反序列化。它与Hadoop API中的MapFile 是互相兼容的。Hive 中的SequenceFile 继承自Hadoop API 的SequenceFile,不过它的key为空,使用value 存放实际的值, 这样是为了避免MR 在运行map 阶段的排序过程。如果你用Java API 编写SequenceFile,并让Hive 读取的话,请确保使用value字段存放数据,否则你需要自定义读取这种SequenceFile 的InputFormat class 和OutputFormat class。
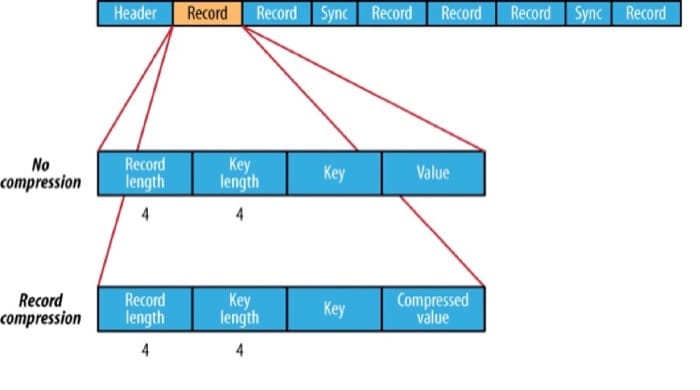
RCFile
RCFile是Hive推出的一种专门面向列的数据格式。 它遵循“先按列划分,再垂直划分”的设计理念。当查询过程中,针对它并不关心的列时,它会在IO上跳过这些列。需要说明的是,RCFile在map阶段从远端拷贝仍然是拷贝整个数据块,并且拷贝到本地目录后RCFile并不是真正直接跳过不需要的列,并跳到需要读取的列, 而是通过扫描每一个row group的头部定义来实现的,但是在整个HDFS Block 级别的头部并没有定义每个列从哪个row group起始到哪个row group结束。所以在读取所有列的情况下,RCFile的性能反而没有SequenceFile高。
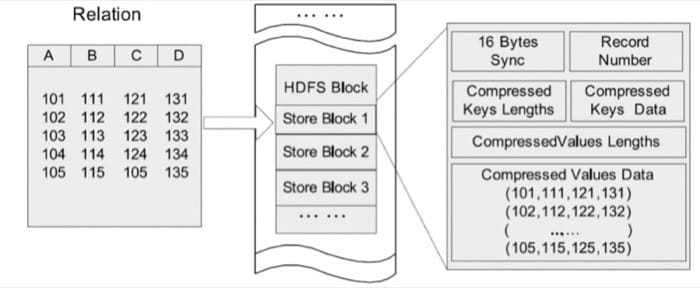
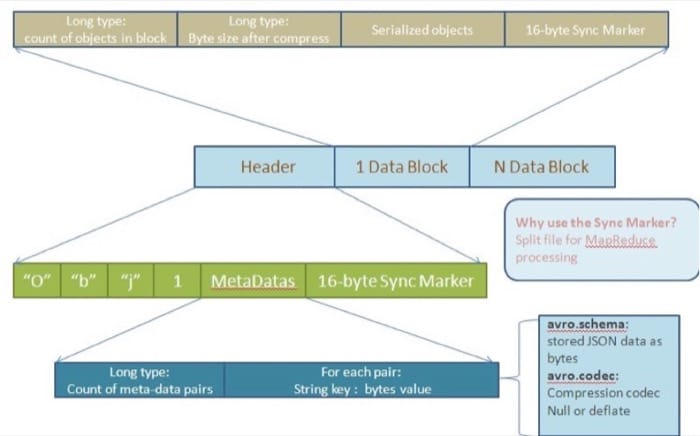
Avro
Avro是一种用于支持数据密集型的二进制文件格式。它的文件格式更为紧凑,若要读取大量数据时,Avro能够提供更好的序列化和反序列化性能。并且Avro数据文件天生是带Schema定义的,所以它不需要开发者在API 级别实现自己的Writable对象。最近多个Hadoop 子项目都支持Avro 数据格式,如Pig 、Hive、Flume、Sqoop和Hcatalog。
TEXT
文本格式的数据也是Hadoop中经常碰到的。如TextFile 、XML和JSON。 文本格式除了会占用更多磁盘资源外,对它的解析开销一般会比二进制格式高几十倍以上,尤其是XML 和JSON,它们的解析开销比Textfile 还要大,因此强烈不建议在生产系统中使用这些格式进行储存。 如果需要输出这些格式,请在客户端做相应的转换操作。 文本格式经常会用于日志收集,数据库导入,Hive默认配置也是使用文本格式,而且常常容易忘了压缩,所以请确保使用了正确的格式。另外文本格式的一个缺点是它不具备类型和模式,比如销售金额、利润这类数值数据或者日期时间类型的数据,如果使用文本格式保存,由于它们本身的字符串类型的长短不一,或者含有负数,导致MR没有办法排序,所以往往需要将它们预处理成含有模式的二进制格式,这又导致了不必要的预处理步骤的开销和储存资源的浪费。
Parquet
Parquet是面向分析型业务的列式存储格式,由Twitter和Cloudera合作开发,2015年5月从Apache的孵化器里毕业成为Apache顶级项目,最新的版本是1.8.0。
列式存储和行式存储相比有哪些优势呢?
- 可以跳过不符合条件的数据,只读取需要的数据,降低IO数据量。
- 压缩编码可以降低磁盘存储空间。由于同一列的数据类型是一样的,可以使用更高效的压缩编码(例如Run Length Encoding和Delta Encoding)进一步节约存储空间。
- 只读取需要的列,支持向量运算,能够获取更好的扫描性能。
列式存储给数据压缩也提供了更大的发挥空间,除了我们常见的snappy, gzip等压缩方法以外,由于列式存储同一列的数据类型是一致的,所以可以使用更多的压缩算法。
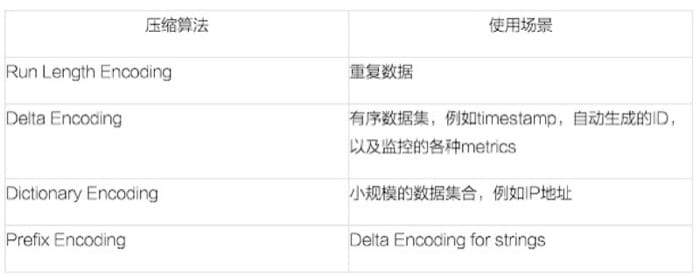
Parquet列式存储带来的性能上的提高在业内已经得到了充分的认可,特别是当你们的表非常宽(column非常多)的时候,Parquet无论在资源利用率还是性能上都优势明显。具体的性能指标详见参考文档。
Spark已经将Parquet设为默认的文件存储格式,Cloudera投入了很多工程师到Impala+Parquet相关开发中,Hive/Pig都原生支持Parquet。Parquet现在为Twitter至少节省了1/3的存储空间,同时节省了大量的表扫描和反序列化的时间。这两方面直接反应就是节约成本和提高性能。
如果说HDFS是大数据时代文件系统的事实标准的话,Parquet就是大数据时代存储格式的事实标准。
任务介绍
- 标签:
Project:3.5 - 镜像
- 测试实例:
m1.small,ami-a13831cb - Hive 集群:
EMR Cluster: 1 m1.large master and 2 m3.xlarge core, Amazon EMR - Impala 集群:
EMR Cluster: 1 m1.large master and 2 m3.xlarge core, Amazon EMR - Redshift 集群:
2 node ds2.xlarge cluster, Amazon Redshift
- 测试实例:
主要需要处理的请求就是『一段时间』+『某些特定数值』的统计学数值(增长减少总和平均趋势等等)。具体的架构为:
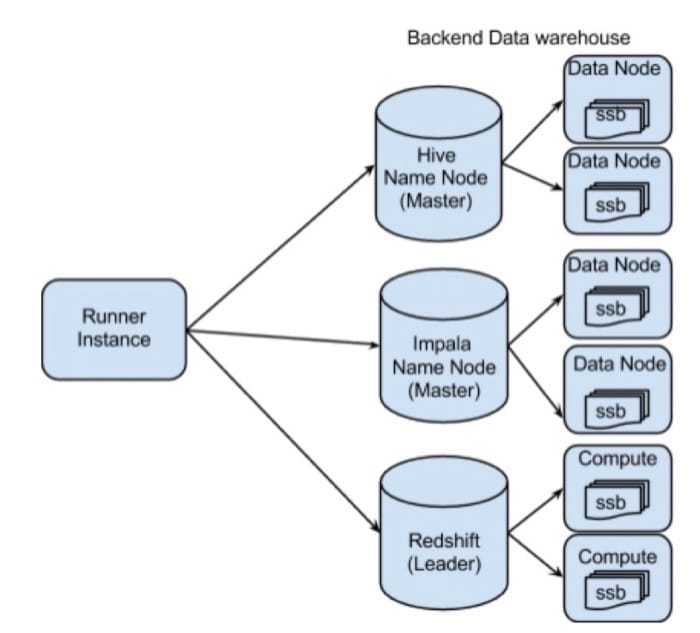
具体有三种请求,我们会分别在 Hive, Impala 和 Redshift 上跑来测试性能,具体优化的话,会针对 Impala 来优化 Query1,针对 Impala 和 Redshift 来优化 Query2 和 Query3。具体的请求如下:
Query 1: restriction on only one dimension. quantify the amount of revenue increase that would have resulted from eliminating certain company-wide discounts in a given percentage range for products shipped in a given year
例如:
select sum(lo_extendedprice*lo_discount) as revenue
from lineorder, dwdate
where lo_orderdate=d_datekey
and d_year=1997
and lo_discount between 1 and 3
and lo_quantity < 24;
Query 2: restrictions on two dimensions. compare revenue for some product classes, for suppliers in a certain region, grouped by more restrictive product classes and all years of order.
例如:
select sum(lo_revenue), d_year, p_brand1
from lineorder, dwdate, part, supplier
where lo_orderdate = d_datekey
and lo_partkey = p_partkey
and lo_suppkey = s_suppkey
and p_category = 'MFGR#12'
and s_region = 'AMERICA'
group by d_year, p_brand1
order by d_year, p_brand1
limit 500;
Query 3: restrictions on three dimensions, including the remaining dimension, customer. The query is intended to provide revenue volume for lineorder transactions by customer nation and supplier nation and year within a given region, in a certain time period.
例如:
select c_city, s_city, d_year, sum(lo_revenue) as revenue
from customer, lineorder, supplier, dwdate
where lo_custkey = c_custkey
and lo_suppkey = s_suppkey
and lo_orderdate = d_datekey
and (c_city='UNITED KI1' or c_city='UNITED KI5')
and (s_city='UNITED KI1' or s_city='UNITED KI5')
and d_yearmonth = 'Dec1997'
group by c_city, s_city, d_year
order by d_year asc, revenue desc
limit 5;
Star Schema
数据仓库一般会选择 star schema,说白了就是不同的信息分开组织,然后有一个中心表格把所有信息集成到一起,如下图所示:
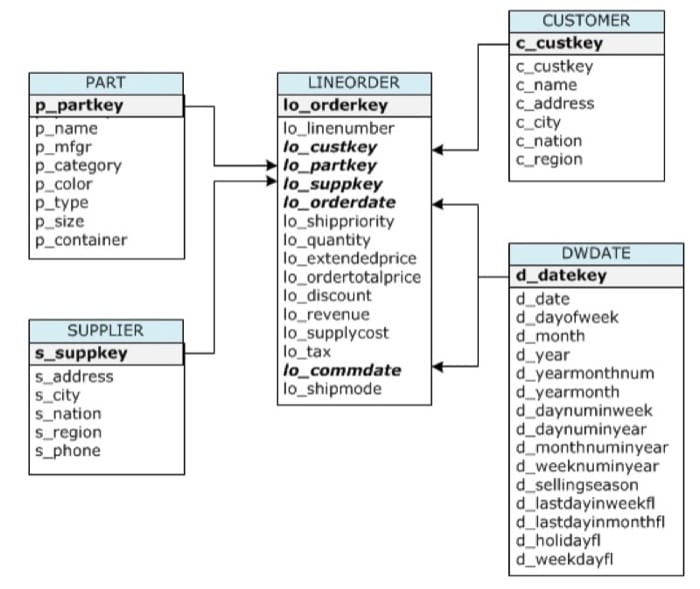
其中不同的小信息成为 lookup 表,而大的称为 fact 表。不同的 lookup 表不会相互连接,而 fact 表通过主键或外键来进行连接。
具体的定义如下:
- A primary key, also called a primary keyword, is a key in a relational database that is unique for each record. A relational database must always have one and only one primary key. Any keys that individually identify unique records and could be chosen as the primary key are known as candidate keys.
- A foreign key is a field (or collection of fields) in one table that uniquely identifies a row of another table. The foreign key in one table (referencing table) matches a particular candidate key (not necessarily the primary key) column of another table (referenced table). The foreign key can be used to cross-reference tables.
- A star join is a primary-key to foreign-key join of the dimension tables to a fact table. All of the dimension tables have a primary key. The central fact table has a foreign key mapping to the dimension tables’ primary key. A star join selects rows from the central fact table for aggregation based on a restriction (filtering condition) on the dimension tables.
Hive 任务
- 启动一个
ami-a13831cb的m1.small实例 - 修改
config.properties,填上对应的地址 - 修改
project3_5.sql中的内容,用Runner.jar来运行 - 运行时间比较长,考虑使用
byobu或者nohup来保持 SSH 连接
具体的用法
Usage: java -jar Runner.jar [backend] [section_name]
[backend] : hive
[section_name] : section name to run from the project3_5.sql
创建 Hive 时可以一并创建好 Impala(因为之后也要用,就不用重新开一个 EMR 了),具体的参数为:
- Cluster Name: < Your choice of EMR Cluster Name >
- Termination Protection: Yes
- Tags:
Project:3.5 - AMI Version: 3.11.0
- Applications to be installed: Hive 0.13.1 (optionally Impala 1.2.4)
- Hardware Configuration: Master
m1.large*1; Corem3.xlarge*2 - EC2 Keypair: < your ec2 key pair >
- 确认开启 10000 及 21050 端口(JDBC 连接)
因为不需要做任何优化,所以只要运行一下就好,具体的步骤为:
- 在
config.properites文件中填写 master 实例的 DNS - 使用
Runner.jar执行project3_5.sql的hive_create_table部分:java -jar Runner.jar hive hive_create_tableHive hive_create_table finishes in 14368msec
- 执行
submitter_hive来跑 query1 和 query2,会生成hive_query1和hive_query2这俩文件,完成之后记录下运行时间 - 使用
Runner.jar执行project3_5.sql的drop_tables部分来清理:java -jar Runner.jar hive drop_tables - 具体的数据在
s3://cmucc-public/p35/ssbgz/中,而获取数据代码会自动完成,我们不用操作。
这部分比较简单,按部就班即可:
- 连接到实例
ssh -i ../demo.pem ubuntu@ec2-54-210-15-148.compute-1.amazonaws.com - 复制文件到本地
- config
scp -i ../demo.pem ubuntu@ec2-54-210-15-148.compute-1.amazonaws.com:~/Project3_5/config.properties ./ - schema
scp -i ../demo.pem ubuntu@ec2-54-210-15-148.compute-1.amazonaws.com:~/Project3_5/schema.sql ./ - sql
scp -i ../demo.pem ubuntu@ec2-54-210-15-148.compute-1.amazonaws.com:~/Project3_5/project3_5.sql ./
- config
- 复制到服务器上
- config
scp -i ../demo.pem ./config.properties ubuntu@ec2-54-210-15-148.compute-1.amazonaws.com:~/Project3_5/ - schema
scp -i ../demo.pem ./schema.sql ubuntu@ec2-54-210-15-148.compute-1.amazonaws.com:~/Project3_5/ - sql
scp -i ../demo.pem ./project3_5.sql ubuntu@ec2-54-210-15-148.compute-1.amazonaws.com:~/Project3_5/
- config
Impala 任务
开 EMR 和 Hive 一样(前面开了现在就不用操心了),具体的任务为:
- 创建测试数据
- 测试基本性能
- 优化
创建测试数据的步骤:
- 在
config.properites文件中填写 master 实例的 DNS - ssh 过去
ssh -i ../demo.pem hadoop@ec2-52-91-242-156.compute-1.amazonaws.com - 因为 Impala 1.2.4 不支持 S3 作为数据源,所以要先下载
- 在 HDFS 上创建文件夹
hdfs dfs -mkdir /data - 载入数据
hadoop distcp s3://cmucc-public/p35/ssb/* /data/ - 验证数据
hdfs dfs -ls -R /data
- 在 HDFS 上创建文件夹
- 使用
RunnerImpala.jar执行project3_5.sql的impala_create_table_unoptimized部分:java -jar RunnerImpala.jar impala impala_create_table_unoptimized,注意这不会进行数据压缩,顺带记录下五个表的导入时间 - 检验一下数据
java -jar RunnerImpala.jar impala count_tables,具体如下
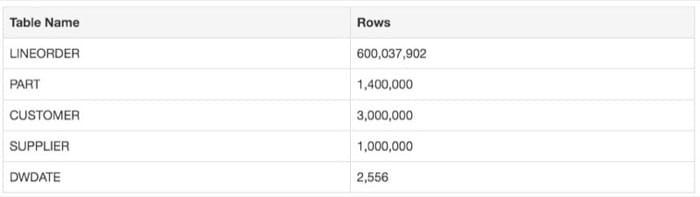
测试的时候要跑两次,第一次的不算数(因为还没缓存),具体的命令为:
java -jar RunnerImpala.jar impala query1java -jar RunnerImpala.jar impala query2java -jar RunnerImpala.jar impala query3
记得记录下每次的时间,查询的时候可能会有错误,简单来说就是内存不够,没办法把整个哈希表放进去,或者就是查询没有优化好。我们啥都不用做,等节点自己重启就好。
优化部分的具体步骤是:
- 用
impala shell来创建对应的优化后的表格,名称为[table_name]_opt,比方说customer对应customer_opt- 根据不同文件格式的分析,因为是列式存储,没啥悬念,直接 Parquet 即可
- 这里需要进入到对应的文件夹(
/impala/impala-shell/)里执行,直接打这个命令无效
- 自己把数据载入到优化后的数据表中
- 验证导入的数据对不对
java -jar RunnerImpala.jar impala count_tables_opt - 优化 query 部分,对应
query1_opt,query2_opt,query3_opt - 执行对应请求,不仅要返回正确结果,还要够快
java -jar RunnerImpala.jar impala query1_optjava -jar RunnerImpala.jar impala query2_optjava -jar RunnerImpala.jar impala query3_opt
- 把 SQL 命令都放在
schema.sql这个文件中,记得加注释 - 执行
submitter_impala来提交,可能需要多跑几次来拿到分数 - 完成之后关掉 EMR
一些提示
- 使用
impala-shell来进行其他命令的执行 - Impala 支持各种 Hadoop 支持的文件格式,包括
Parquet,Text,Avro和SequenceFile,不同的格式有不同的表现,选择个最合适的(columnar storage layout, large I/O request size, compression, encoding) - join 操作很费时,Impala 是通过构造 hash table 来处理查询的,默认使用 broadcast join右边的表格最好比左边的小
- 考虑使用 cache
- 分隔数据,这样查询的时候就不用扫描整个表格,最好使用经常用作过滤条件的列来进行分隔
- 利用查询的数据来进行优化,但注意不要使用
COMPUTE STATS命令 - 查看 Impala 1.2.4 documentation,尝试各种可能的优化
优化思路
我们根据具体的查询来看看相关查询中对几个不同的表的请求情况
- 表
LINEORDER- 相关查询:query1, query2, query3
- Query1 相关列:
lo_orderdate,lo_discount,lo_quantity,lo_extendedprice - Query2 相关列:
lo_revenue,lo_partkey,lo_suppkey - Query3 相关列:
lo_revenue,lo_custkey,lo_suppkey,lo_orderdate
- 表
PART- 相关查询:query2
- Query2 相关列:
p_partkey,p_category,p_brand1
- 表
CUSTOMER- 相关查询:query3
- Query3 相关列:
c_city,c_custkey
- 表
SUPPLIER- 相关查询:query2, query3
- Query2 相关列:
s_suppkey,s_region - Query3 相关列:
s_city,s_suppkey
- 表
DWDATE- 相关查询:query1, query2, query3
- Query1 相关列:
d_datekey,d_year - Query2 相关列:
d_year,d_datekey - Query3 相关列:
d_year,d_yearmonth,d_datekey
基本上需要根据范围来进行分隔,比以此确定 partition key,通过观察应该能够找到合适的 key。其他的部分根据原来的代码复制粘贴即可。
如果使用了 EXTERNAL 关键字,删除的时候还需要对应删除 hdfs 中的文件。然而 EMR 很可能没权限删,所以,插入的时候使用 INSERT OVERWRITE 关键词(感谢 @vera @shuangling)
这部分不算太难。需要仔细。另外注意 project3_5.sql 中不要写注释,会出错。
Redshift 任务
Redshift 很贵,确定弄清楚了要做的事情,才开启,启动的配置如下:
- Node Type:
ds2.xlarge - Cluster Type:
Multi Node - Number of Compute Nodes:
2 - 记得在 Manage Tag 中打上 tag
- 其他基本都是默认,具体参考下面的图
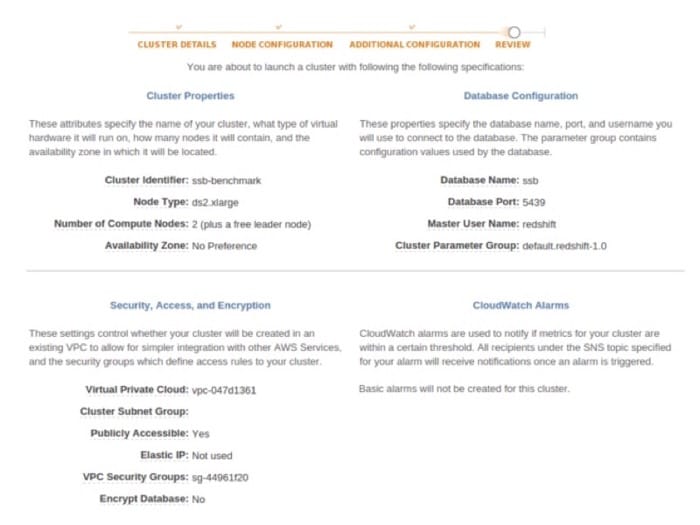
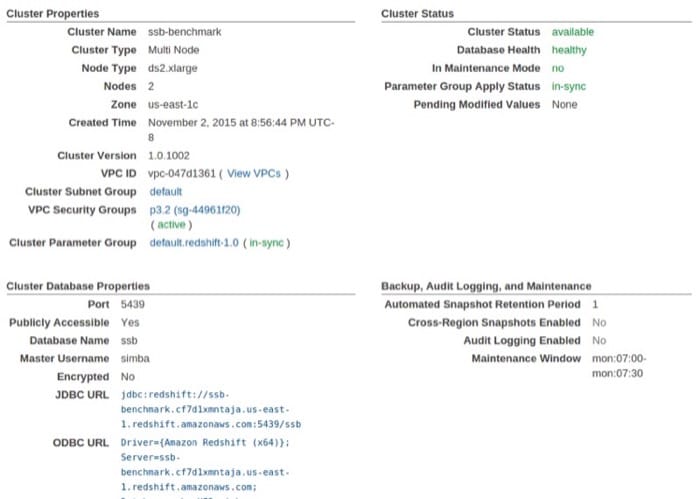
需要完成的工作和前面 Impala 的类似,一共 4 步:
- 创建 schema 并载入数据
- 测试基准性能
- 优化
- 重新载入数据集,再次测试
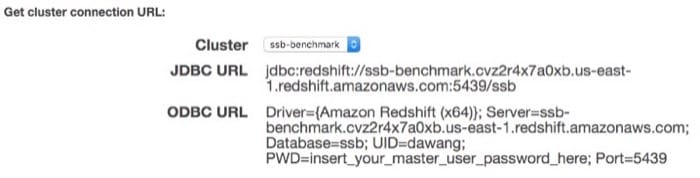
创建 schema 和载入数据的步骤为:
- 创建表
java -jar Runner.jar redshift redshift_create_table_unoptimized - 载入数据
java -jar Runner.jar redshift redshift_load_uncompressed,注意需要填写[AWS_ACCESS_KEY_ID]和[AWS_SECRET_ACCESS_KEY],提交的时候一定要注意删除(这里并不会进行压缩,因为gzip compupdate off选项) - 验证数据
java -jar Runner.jar redshift count_tables,并记录下各个表的载入时间
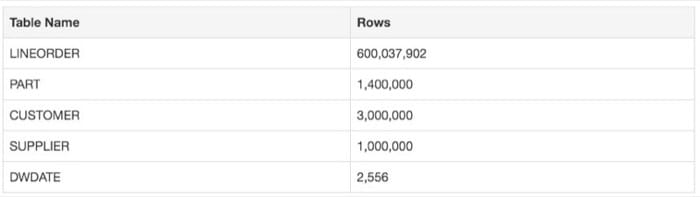
测试基准性能的时候要跑两次,第一次的不算数,具体的命令为:
java -jar Runner.jar redshift query1java -jar Runner.jar redshift query2java -jar Runner.jar redshift query3
优化部分需要做的有
- 更新
redshift_create_tables_optimized部分,包括 sortkey, distribution styles 和 distkeys 来优化性能 - 可以用
explain_query1,explain_query2和explain_query3部分来查看具体是怎么执行的,根据这个信息来进行优化(决定最合适的 distkey),我调用的时候有 bug,不知道为啥
对应的提示
- Query 1 has range filtering on the lineorder table for one of its fields
- Clearly, we have to co-locate one of the tables with lineorder based on a join column. Only 1 table can be co-located with it based on the join column.
重新载入数据的步骤
- 先删掉原来的表
java -jar Runner.jar redshift drop_tables - 创建之前优化的表格
java -jar Runner.jar redshift redshift_create_table_optimized - 导入数据
java -jar Runner.jar redshift redshift_load_compressed
执行命令
java -jar Runner.jar redshift query1java -jar Runner.jar redshift query2java -jar Runner.jar redshift query3
使用 submitter_redshift 来提交,记得移除 AWS 的密码。可能需要多跑几次来拿到分数,完成之后记得关掉。
总结经验就是一条,观察法 + 碰运气,反正每个表需要加一个 sortkey 和 distkey,大概试验一下就知道了。
参考链接
相关文章
- 【不周山之云计算】壹 云平台初探2017-05-26
- 云计算 阅读材料 22 Message Queues and Stream Processing2016-04-22
- 云计算 第 21 课 Kafka / Samza 动手玩2016-04-18
- 云计算 第 20 课 Spark / GraphLab 动手玩2016-04-11