云计算 第 17 课 实现社交网络的时间线功能
本页目录
这一次的任务需要前端后端一起做了!后端包括 MySQL, HBase 和 MongoDB,通过这次的作业,我们应该能够慢慢开始实现自己的 web 应用了。
学习目标
- 了解 AWS 提供的 Database-as-a-Service(DBaaS) 服务(申请、配置和管理)
- 比较 MySQL,HBase 和 MongoDB 在使用 Java API 载入数据时的异同
- 使用多个后端给一个复杂度的 web 应用提供数据
- 评估不同数据库系统在实际使用中的特点
这次的作业比较麻烦,需要提交的内容包括:
- 所有的 java 文件:MiniSite.java, ProfileServlet.java, FollowerServlet.java, HomepageServlet.java, TimelineServlet.java, RecommendationServlet.java(及其他项目中的 java 文件)
- ETL 部分的代码:包括命令、脚本和程序
后端数据的介绍:
- MySQL:这里我们直接使用 AWS 提供的服务,只需要简单配置就可以使用
- MongoDB:是一个 Document Oriented 数据库,可以看做是键值对存储的一个子类型,能对 document 中的域进行索引(这个和 HBase 不同)。另外,它也是 MEAN stack 中最重要的后端组成
背景知识
社交网络的基本架构,是由其需要存储的数据所决定的,包括:用户资料、用户活动以及大数据分析系统,具体如下:
- 用户资料:身份验证、用户信息、活动日志、社交关系(用图表示)
- 用户互动:各种用户产生的多媒体数据
- 大数据分析系统:查询、推荐与用户行为分析
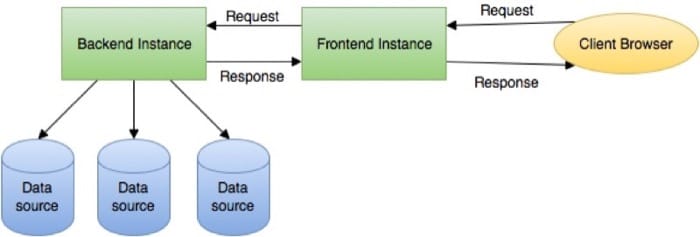
社交网络基本特性的介绍:
- 要处理不同类型的数据(文本、链接、图片、视频或前面的各种排列组合)
- 在时间线页面,一个简单的 HTTP 请求,后端需要处理大量的子请求以及数据库访问。一般来说不同类型的内容会存储在不同的数据库中,然后应用根据需要按需访问(可以参加下图)
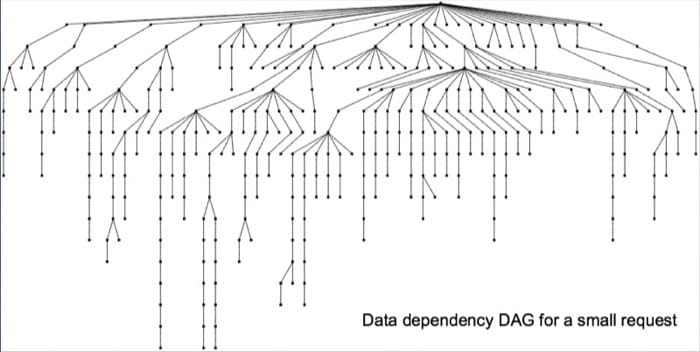
从上图中我们就可以大概感受到一个简单的请求(根节点)之后所需要的各种各样的查询和计算。
我们要做的是:
- 一个电影相关的垂直社交网站
- 前端已经做好,我们需要提供后端服务
- 后端服务需要同时支持 4 种不同类型的查询
DBaaS
简单来说就是不需要怎么配置,直接用就好。Amazon 的对应服务叫做 RDS,具体的细节可以看这个视频,这里我就不废话了。
对于这个项目,我们需要做的就是把各种用户信息导入到 RDS 中,然后前端发送登录请求的时候检查对应的 userid 和 password,根据检查结果来做下一步的操作(具体的操作在『任务介绍』)
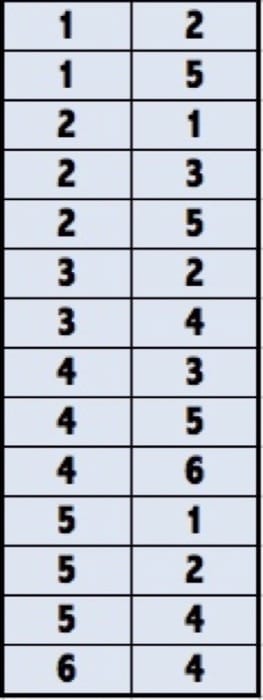
图的数据结构
这里简单介绍一下基本的表示图的方式,假设我们有这样一个图:
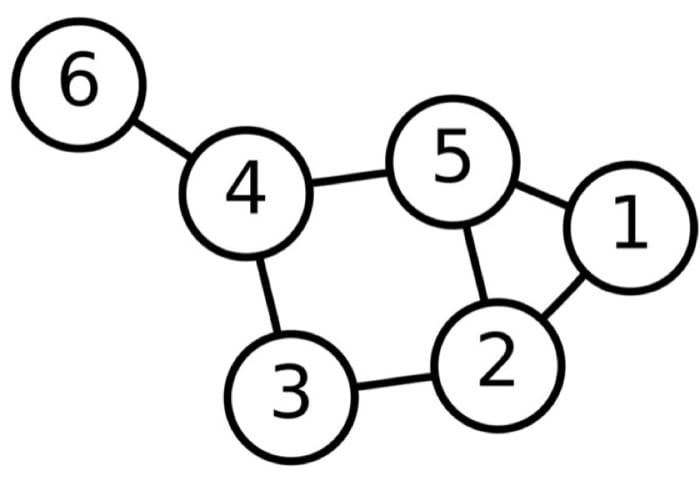
先来看看邻接矩阵,这种方式的存储可以使用 vectorized library,但是需要的空间为
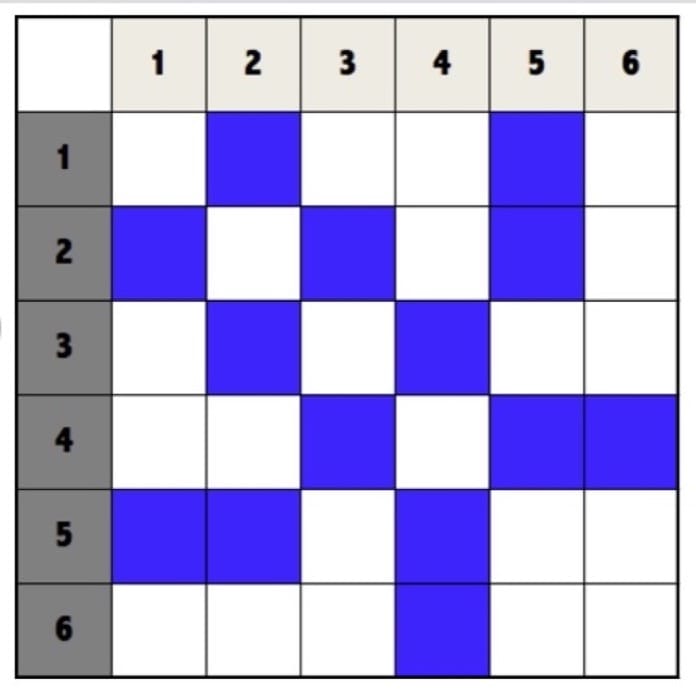
第二种是邻接表,比较简单粗暴,用的空间也比较少
MongoDB 介绍
MongoDB 可以看做是一个有诸多关系型数据库的 document-oriented 数据库,其中的数据以 Bson 格式存储(实际上是二进制的 json)。另外前面也提到的,支持索引(和 HBase 不一样)。
选择 BSON 格式的原因是:
- Space efficiency – BSON occupies much less space than does plain JSON, even in the worse case.
- Mobility – BSON sometimes introduces a small amount of overhead in the transferred data to ease transmission. For example, a size header is used in place of a terminating character to ease data modification.
- Performance – BSON encoding and decoding is fast in the context of many programming languages.
这个视频介绍了 MongoDB 在分布式应用时候的架构和策略
使用 MongoDB 也比较简单(给出的镜像已经配置好了相关环境)
- 先使用
mongod启动 MongoDB 服务 - 然后使用
mongo启动数据库 shell - 使用
mongoimport来导入数据,参考这个例子以及对应的文档 - 导入之后可以发现
_id会作为主键,这是自动完成的,暂时可以不去管它
我们同样可以使用 Mongo Shell 来操作数据库(使用 javascript),具体可以参考Mongo Shell Guide,这里只介绍一些基本操作
可以通过 use db_name 来创建或切换到一个数据库。插入 document 可以使用:
db.db_name.insert ({
    "name":"sample document"
})
db.db_name.insert({
    "name":"sample document", "user": {"uid": 123}
})
使用 find() 函数进行查找,也可以通过一些其他参数来给结果加一些限制:
db.db_name.find({“name”:”sample document”})
db.db_name.find().limit(30)
MongoDB 的 Java API 和上面介绍的很类似,具体参考 Mongo Java Guide
可以通过添加索引加快查询,具体可以参考这个文档
Graph Distance
这里我们使用有向图的距离度量来作为推荐的依据(就是判断谁更值得推荐)
- 令
d(A, v)表示从节点A到节点v的最小距离 - 令
S为A关注的人的集合,那么对于S中的每个s,有d(A, s) = 1 - 令
R为需要给A推荐的人的集合,那么对于R中的每个r,需要满足d(A, r) = 2 - 对于
R中的每个r,rate(r)表示从集合S中到r的边的数量 R中元素的排序,首先按照rate(r)(降序,大的在前面),然后按照 userid(升序)- 返回至多 10 个推荐结果
举个例子,假如有这样一些关系:
A follows {B, C, D}
Followee B follows {C, E, A}
followee C follows {F, G}
followee D follows {G, H}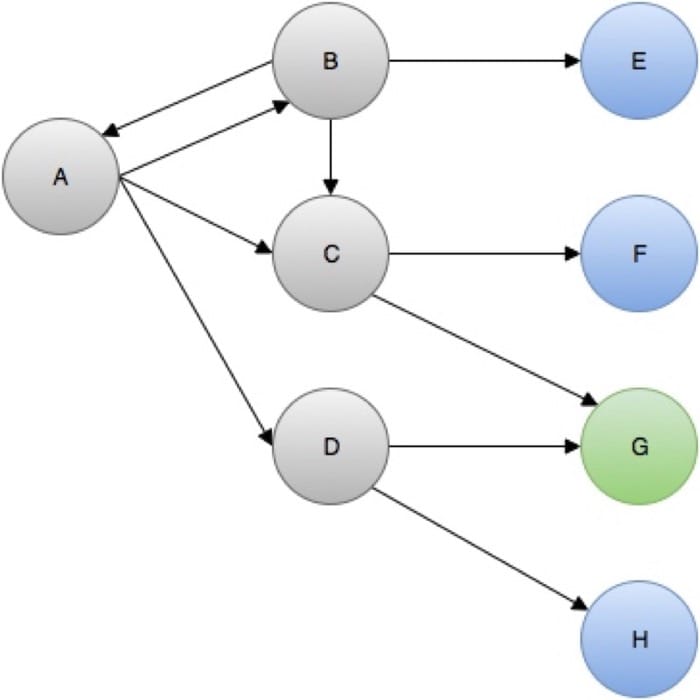
那么对应的分数为 {A:1, C:1, E:1, F:1, G:2, H:1},这里 C 已经在 A 的关注列表里,要去掉;A 本身就是自己,也要去掉,所以剩下的是 {G: 2, E: 1, F: 1, H: 1}。
然后需要按照分数的降序排列(大的在前面),如果有分数一样的,按照 userid 的数字升序排列(小的在前面)
任务介绍
- 标签:
Project:3.4 - 镜像
- 前端(FI):
m3.medium,ami-30f2c95a,全部流量 - 后端(BI):
m3.medium,ami-238c8a49,全部流量 - MongoDB:
m3.medium,ami-8f330ee5,全部流量
- 前端(FI):
- 数据集
- 登录信息:MySQL,
[UserID, Password],/home/ubuntu/users.csv - 用户信息:MySQL,
[UserID, Name, Profile Image URL],/home/ubuntu/userinfo.csv - 关系:HBase,
[Followee, Follower],/home/ubuntu/links.csv - 帖子:MongoDB,JSON 格式,
/home/ubuntu/posts.json(在 MongoDB 实例中) - 资料及图片:S3,后端系统只需要提供 URL 地址,地址在
userinfo.csv和posts.json中
- 登录信息:MySQL,
- 注意价格:EC2, EMR, RDS
前端
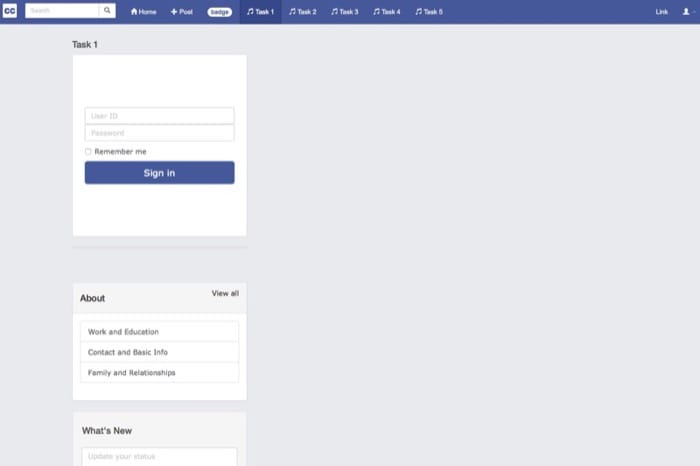
- 启动一个前端实例(FI),在
/home/ubuntu/SN2/routes/backend.js更新后端的地址 - 进入
/home/ubuntu/SN2文件夹,并用npm start命令启动服务器 - 在浏览器中访问
http://<frontend-public-dns>:3000,应该能够看到前端界面
一些我用到的命令:
ssh -i ../demo.pem ubuntu@ec2-52-201-238-55.compute-1.amazonaws.com- 服务器到本地
scp -i ../demo.pem ubuntu@ec2-52-201-238-55.compute-1.amazonaws.com:~/SN2/routes/backend.js ./ - 本地到服务器
scp -i ../demo.pem ./backend.js ubuntu@ec2-52-201-238-55.compute-1.amazonaws.com:~/SN2/routes/
后端
- 启动一个后端实例(BI),所有的实现都在后端完成
- 因为依赖关系比较多的缘故,这次使用 maven3 来完成各类工作。具体的依赖在
pom.xml文件中,如果没有添加额外的包,应该不需要改动 - Java 文件在
/home/ubuntu/Project3_4/src/main/java/cc/cmu/edu/minisite/中,我们需要完成 5 个 servlet,但注意不要改动MiniSite.java- 任务 1:ProfileServlet.java
- 任务 2:FollowerServlet.java
- 任务 3:HomepageServlet.java
- 任务 4:TimelineServlet.java
- Bonus:RecommendationServlet.java
- 在每个 servlet 的
doGet函数中完成操作(解析请求、连接后端数据库、发送查询请求、解析结果并且返回给前端) - 在每个 servlet 的构造器中初始化数据库连接
- 在
/home/ubuntu/Project3_4/src/main/java/cc/cmu/edu/minisite/中有submitter和references文件 - 运行服务需要进入
/home/ubuntu/Project3_4文件夹,并使用mvn exec:java命令(如果需要 clean 的话,命令是mvn clean package) - 可以在前端登录界面什么都不输入的前提下点击登录,如果能看到提示信息,说明后端启动成功
- 解析 JSON 文件可以用默认的
org.json,也可以使用google/gson,需要注意数据集中包括非 ASCII 字符,需要对应处理(就是使用 UTF8 编码) - 如果需要在
pom.xml中添加新的依赖,也很简单:- 在 Maven 库中寻找所需的包
- 在
<dependencies>项目中添加<dependency>标签 - 执行
mvn clean package即可
一些我用到的命令:
ssh -i ../demo.pem ubuntu@ec2-54-164-149-7.compute-1.amazonaws.comcd Project3_4/src/main/java/cc/cmu/edu/minisite/- 服务器到本地
scp -i ../demo.pem -r ubuntu@ec2-54-164-149-7.compute-1.amazonaws.com:~/Project3_4/src/main/java/cc/cmu/edu/minisite/*.java ./ - 本地到服务器1
scp -i ../demo.pem -r ./*.java ubuntu@ec2-54-164-149-7.compute-1.amazonaws.com:~/Project3_4/src/main/java/cc/cmu/edu/minisite/ - 本地到服务器2
scp -i ../demo.pem -r ./*.py ubuntu@ec2-54-164-149-7.compute-1.amazonaws.com:~/
配置 RDS
- 登录 AWS,并进入 RDS 页面
- 启动一个 MySQL 数据库,设置如下
- Production 选择 MySQL
- DB Engine Version -
5.6.27 - DB Instance Class -
db.t2.micro/db.t2.small - Multi AZ Deployment - No
- Storage type - General Purpose SSD
- Allocated Storage - 5GB
- VPC - default VPC
- Subnet Group - default group
- Publicly Accessible - Yes
- Availability Zone - Same as your backend instance
- Backup Retention Period: 0 days
- Leave the Monitoring and Maintenance sections as default
- Ensure that the security group allows port 3306.
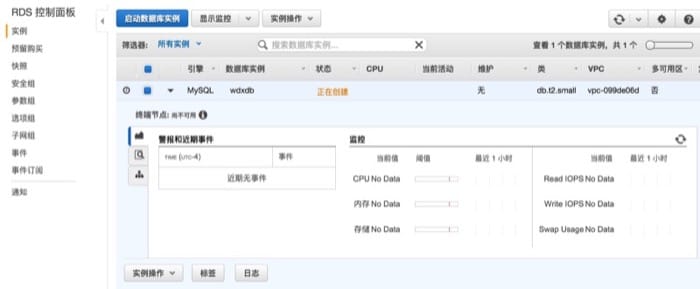
- 启动完成后记录下 endpoint 地址,包括 host 地址和端口号
- 我们需要建立自己的数据库来保存数据,使用
mysql -h <your_db_instance_dns> -u <user_name> -p<password>登录数据库,根据提供的数据来设计表,同时可能需要建立索引(假哭啊速度) - 载入数据需要使用
--local-infile,可能需要使用grant命令来给权限,具体参考 MySQL GRANT syntax 和 Access denied issue on Amazon RDS - 载入好数据之后,就可以使用 JDBC 来连接数据库(参考之前的代码)
创建好之后大概是这样的:
mysql -u wdxtub -pohnohaha -h wdxdb.cinhw8whkk4g.us-east-1.rds.amazonaws.com --port=3306 --local-infile wdxdbLOAD DATA LOCAL INFILE '/home/ubuntu/users.csv' INTO TABLE users CHARACTER SET utf8mb4 FIELDS TERMINATED BY ',' LINES TERMINATED BY '\n';load data local infile '/home/ubuntu/userinfo.csv' into table userinfos character set utf8mb4 fields terminated by ',' lines terminated by '\n';
CREATE TABLE users(
userid int primary key,
password varchar(255)
);

CREATE TABLE userinfos(
userid int primary key,
name varchar(255),
url varchar(255)
);

show tables;
+-----------------+
| Tables_in_users |
+-----------------+
| userinfos       |
| users           |
+-----------------+
2 rows in set (0.00 sec)

desc users;
+----------+--------------+------+-----+---------+-------+
| Field    | Type         | Null | Key | Default | Extra |
+----------+--------------+------+-----+---------+-------+
| userid   | int(11)      | NO   | PRI | NULL    |       |
| password | varchar(255) | YES  |     | NULL    |       |
+----------+--------------+------+-----+---------+-------+
2 rows in set (0.00 sec)

desc userinfos;
+--------+--------------+------+-----+---------+-------+
| Field  | Type         | Null | Key | Default | Extra |
+--------+--------------+------+-----+---------+-------+
| userid | int(11)      | NO   | PRI | NULL    |       |
| name   | varchar(255) | YES  |     | NULL    |       |
| url    | varchar(255) | YES  |     | NULL    |       |
+--------+--------------+------+-----+---------+-------+
3 rows in set (0.00 sec)

select * from users where userid=1;
+--------+----------+
| userid | password |
+--------+----------+
|      1 | yaihala  |
+--------+----------+
1 row in set (0.00 sec)

select * from userinfos where userid=1;
+--------+---------+-------------------------------------------------------------------------------------+
| userid | name    | url                                                                                 |
+--------+---------+-------------------------------------------------------------------------------------+
|      1 | Aaliyah | https://cmucloudsocial.s3.amazonaws.com/profiles/9cc1886c5af388976e959787fa810c.png |
+--------+---------+-------------------------------------------------------------------------------------+
1 row in set (0.00 sec)
任务 1:登录
相关信息:
- RDS 实例:1 台
db.t2.micro/db.t2.small - 登录信息:MySQL,
[UserID, Password],/home/ubuntu/users.csv - 用户信息:MySQL,
[UserID, Name, Profile Image URL],/home/ubuntu/userinfo.csv - 对应文件:ProfileServlet.java,
/home/ubuntu/Project3_4/src/main/java/cc/cmu/edu/minisite/ - 注意!不要在代码中保存 AWS 密码
具体要做的事情就是检查帐号存不存在,存在的话密码匹不匹配,具体细节看下面的 URL 就差不多了,所需的信息在上面两个数据集中可以找到。
- 请求格式:
GET /task1?id=[UserID]&pwd=[Password]- 例如:
http://backend-public-dns:8080/MiniSite/task1?id=2&pwd=oltaa
- 例如:
- 响应格式:
returnRes({"name":"my_name", "profile":"profile_image_url"})- 例如:
returnRes({"name":"Aalto","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/e8a7e982144ee3078f432d0d0b105a.png"}) - 验证失败时:
returnRes({"name":"Unauthorized","profile":"#"})
- 例如:
returnRes函数是给前端用的回调函数,主要关注 JSON 字符串就好
创建 JSON 响应的样例代码:
JSONObject result = new JSONObject();
result.put("name", "my_name");
result.put("profile", "profile_image_url");
PrintWriter writer = response.getWriter();
writer.write(String.format("returnRes(%s)", result.toString()));
writer.close();
可以通过下面步骤进行测试:
- 启动前端、后端服务器,然后访问
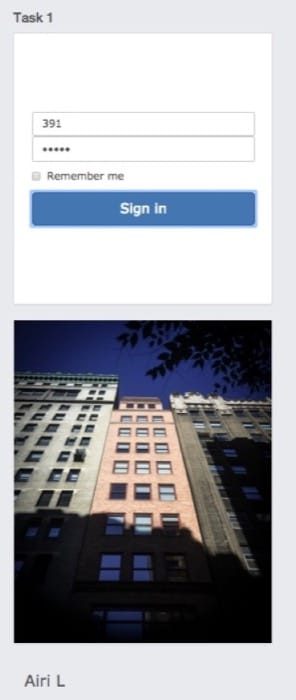
http://<your_front_end_dns>:3000 - 点击导航栏中的 Task1 按钮(注意需要在前端的
/home/ubuntu/SN2/routes/backend.js中设置好后端的地址) - 然后正常输入帐号密码登录测试即可
解题思路:
- 发送一次请求,获取
password,name,url- SQL:
select password, name, url from users, userinfos where users.userid=1 and userinfos.userid=1;
- SQL:
- 校验密码等信息,按照前面给出的要求进行返回即可
这一部分还是比较简单的,仔细一点即可
任务 2:存储社交图谱
简单来说,就是用 HBase 保存用户间的关系(具体可以看前面的背景知识)。我们需要从『邻接矩阵』和『邻接表』这两种方式选择一种,来保存具体的数据(原始数据是简单的 <Followee, Follower>)
相关信息:
- EMR Hadoop Version: Amazon 3.9.0
- EMR HBase Version: 0.94.18
- Master and Core Nodes Type: m3.xlarge(1)/m4.large(1)
- 关系:HBase,
[Followee, Follower],/home/ubuntu/links.csv - 对应文件:FollowerServlet.java,
/home/ubuntu/Project3_4/src/main/java/cc/cmu/edu/minisite/ - 注意!不要在代码中保存 AWS 密码
具体要做的事情就是返回给定 userid 的所有粉丝,粉丝需要按照名字的字典序升序排列(就是 A 在 B 前面),如果名字一样,就按照 URL 的升序排列(用同一个 Comparator 即可)。
一些提示:
- ETL 的时候就需要排好顺序(或者直接预处理好)
- HBase 和 Hadoop 的相关库都已经安装好
- 后端和 HBase 设置在同一个 subnet,就可以用私有 ip 来访问 HBase
- 一些 HBase API 的例子
可能会需要 import 的头文件:
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.client.Get;
import org.apache.hadoop.hbase.client.Result;
import org.apache.hadoop.hbase.client.ResultScanner;
import org.apache.hadoop.hbase.client.Scan;
import org.apache.hadoop.hbase.util.Bytes;
import org.apache.hadoop.hbase.client.HTablePool;
import org.apache.hadoop.hbase.client.HTableInterface;
import org.apache.hadoop.hbase.KeyValue;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.client.HConnection;
import org.apache.hadoop.hbase.client.HConnectionManager;- 请求格式:
GET /task2?id=[UserID]- 例如:
http://backend-public-dns:8080/MiniSite/task2?id=2
- 例如:
- 响应格式(JSON):
{"followers":[{"name":"follower_name_1", "profile":"profile_image_url_1"}, {"name":"follower_name_2", "profile":"profile_image_url_2"}, ...]}- 例如:
returnRes({"followers":[{"name":"Africando","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/0a552ed6273943ac7a9b81093014c9.png"},{"name":"Afrika Bambaataa","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/c43b0148a9c98a5d2baedd96be07a2.png"},{"name":"Alex Band","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/15d6a8647c411e1f16899893f031fa.png"},{"name":"Anthony B","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/bce126a97ca09c1b410e60ccd63af4.png"},{"name":"Apathy","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/53489fd2afc2e6242b98516f91098f.png"},{"name":"Arma Angelus","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/4227429669d2c063597153be8a21f5.png"}, ...]})
- 例如:
创建 JSON 响应的样例代码:
JSONArray followers = new JSONArray();
JSONObject follower = new JSONObject();

follower.put("name", "follower_name_1");
follower.put("profile", "profile_image_url");
followers.put(follower);
// 把所有的 follower 都添加进去再执行下面的
PrintWriter writer = response.getWriter();
writer.write(String.format("returnRes(%s)", followers.toString()));
writer.close();
可以通过下面步骤进行测试:
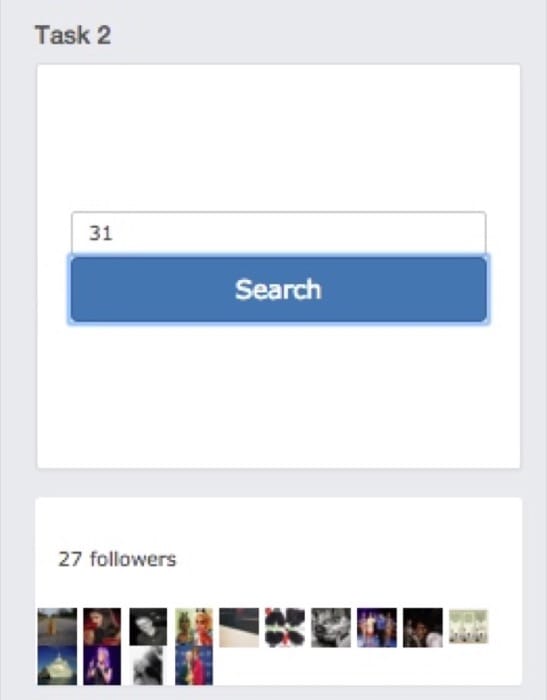
- 启动前端、后端服务器,然后访问
http://<your_front_end_dns>:3000 - 点击导航栏中的 Task2 按钮
- 然后正常输入 userid 进行测试即可(范围是 1-35919)
解题思路
- 首先需要排序,完全可以处理成
followee: follower1, follower2, follower3, ...这样的格式 - 因为需要排序,所以我们用命令行把顺序也排好(虽然看起来已经是排好顺序了的,不过还是保险起见,TA 恶意满满规矩我懂)
sort -t"," -nk1 links.csv > sorted.csv - Q2 和 Q4 排序是不一样的,所以这里要用另一个命令为 Q4 排序
sort -t"," -nk2 links.csv > sorted2.csv - 排好顺序我们需要合并
- 合并之后就可以导入到 HBase 了
一些会用到的命令:
ssh -i ../demo.pem hadoop@ec2-54-165-85-78.compute-1.amazonaws.commkdir q2; cd q2;- 下载排序后的 links.csv
scp -i ../demo.pem -r ubuntu@ec2-54-164-149-7.compute-1.amazonaws.com:~/q2.csv ./ - 上传到 HBase
scp -i ../demo.pem ./q2.csv hadoop@ec2-54-165-85-78.compute-1.amazonaws.com:~/q2/ - 创建文件夹
hadoop fs -mkdir /q2 - 移动文件
hadoop fs -put ./q2.csv /q2 - 查看文件
hadoop fs -ls /q2 - 进入
hbase shellcreate 'linkdata','data'exit
- 导入数据
hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.separator="," -Dimporttsv.bulk.output=/hfile_groupt -Dimporttsv.columns=HBASE_ROW_KEY,data:v linkdata /q2/q2.csv - 应用改动
hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /hfile_groupt linkdata
为任务 4 进行导入:
ssh -i ../demo.pem hadoop@ec2-54-165-85-78.compute-1.amazonaws.commkdir q4; cd q4;- 下载排序后的 links.csv
scp -i ../demo.pem -r ubuntu@ec2-54-164-149-7.compute-1.amazonaws.com:~/q4.csv ./ - 上传到 HBase
scp -i ../demo.pem ./q4.csv hadoop@ec2-54-165-85-78.compute-1.amazonaws.com:~/q4/ - 创建文件夹
hadoop fs -mkdir /q4 - 移动文件
hadoop fs -put ./q4.csv /q4 - 查看文件
hadoop fs -ls /q4 - 进入
hbase shellcreate 'linkdata2','data'exit
- 导入数据
hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.separator="," -Dimporttsv.bulk.output=/hfile_group -Dimporttsv.columns=HBASE_ROW_KEY,data:v linkdata2 /q4/q4.csv - 应用改动
hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /hfile_group linkdata2
任务 3:搭建主页
使用 MongoDB 来存储帖子,这里主要会查询某些特定的 field,所以需要对应建立索引来加速查询。
相关信息:
ami-8f330ee5,m3.medium- MongoDB version: 3.2.1
- EC2 Instance OS Type: Ubuntu 14.04 LTS (HVM)
- 帖子:MongoDB,JSON 格式,
/home/ubuntu/posts.json(在 MongoDB 实例中) - 对应文件:HomepageServlet.java,
/home/ubuntu/Project3_4/src/main/java/cc/cmu/edu/minisite/ - 注意!不要在代码中保存 AWS 密码
post.json 中的每一行都是一个 JSON 对象,具体如下:
{
    "pid":xxx,                                      // PostID
    "uid":xxx,                                      // UserID of poster
    "name":"xxx",                                   // User name of poster
    "profile":"xxx",                                // Poster profile image URL
    "timestamp":"YYYY-MM-DD HH:MM:SS",              // When post is posted
    "image":"xxx",                                  // Post image
    "content":"xxx",                                // Post text content
    "comments":[                                    // comments json array
        {
            "uid":xxx,                              // UserID of commenter
            "name":"xxx",                           // User name of commenter
            "profile":"xxx",                        // Commenter profile image URL
            "timestamp":"YYYY-MM-DD HH:MM:SS",      // When comment is made
            "content":"xxx"                         // Comment text content
        },
        {
            "uid":xxx,
            .......
        },
        ......
    ]
}
注意,我们不需要改变 json 文件中的任何内容,评论已经按照时间顺序排好了。每次会请求一个 userid 的所有帖子,我们需要做的是利用时间戳来排个序(旧的在前面,新的在后面)。
可以通过添加索引加快查询,具体可以参考这个文档
- 请求格式:
GET /task3?id=[UserID]- 例如:
http://backend-public-dns:8080/MiniSite/task3?id=1
- 例如:
- 响应格式(JSON):
{"posts":[{post1_json}, {post2_json}, ...]}- 例如:
returnRes({"posts":[{"content":"Wow, just experienced Barrio Cuba","timestamp":"2010-05-25 06:18:11","uid":1,"name":"Aaliyah","image":"http://cmucloudsocial.s3.amazonaws.com/posts/Barrio_Cuba.png","pid":49138,"comments":[{"uid":16779,"timestamp":"2010-07-18 01:03:49","content":"This award-winning film from Havana follows the struggles of three multi-generational families. Sweltering heat, dilapidated buildings, a dysfunctional economy, and a spartan diet ('We're having beans and rice again because that's what the grocery had') are only the beginning of their deeply human struggles. Magalis bikes to her job as a nurse and attracts all the wrong sort of men-- an aging carpenter who's hopelessly in love with her, a no-good cheater, and a rich Italian, but her real challenge is the fight between her dictatorial father and her gay brother. When Maria dies in childbirth her husband Santos flees, leaving the grandmother to raise the boy and to salvage the son's image of his absent father. In the third story, the engineer Chino and his pharmacist wife Vivian suffer a miscarriage, and with it the expectations of their parents for a grandchild, both of which are aggravated by a sibling who flees with his family from Cuba. The three stories are not connected in the film, except for a common theme -- people who flee their problems then face the challenge to return for reconciliation. The problems are real, but their resolutions are contrived.","name":"Kostia","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/24afc9707d42cc756b02efae729a2d.png"},...(Some comments are omitted here)...],"profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/9cc1886c5af388976e959787fa810c.png"},{"content":"Wow, just experienced American Gun [VHS]","timestamp":"2015-05-26 01:02:18","uid":1,"name":"Aaliyah","image":"http://cmucloudsocial.s3.amazonaws.com/posts/American_Gun_VHS_.png","pid":89533,"comments":[...(Some comments are omitted here)]}
- 例如:
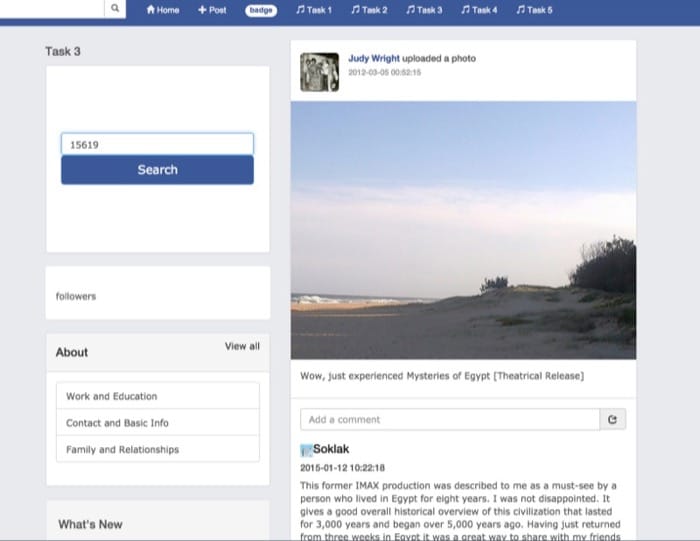
具体的测试方法和之前非常类似,输入 userid 即可,如下图所示:
用到的命令:
ssh -i ../demo.pem ubuntu@ec2-54-172-46-200.compute-1.amazonaws.com- 启用服务
mongod - 启动 mongo shell
mongo - 创建/切换数据库
use posts - 导入数据
mongoimport --db posts --collection post --drop --file posts.json - 查找记录
db.post.find({"uid":33152})(注意这里是调用 collection 的名字) - 会发现比较慢,我们创建索引
db.post.createIndex({uid:1}),再次执行上面的命令就会发现快了很多 - 需要给检索结果排序:
db.post.find({"uid":33152}).sort({"timestamp":1}) - 调用 Java API 进行检索并返回即可
任务 4:中路一波
简单来说,就是把之前的东西全凑到一起。也就是说,给出一个 userid,需要返回 Name, Profile Image URL, 粉丝列表(要排序)以及用户关注的人的 30 条最新的帖子。
粉丝需要按照名字的字典序升序排列(就是 A 在 B 前面),如果名字一样,就按照 URL 的升序排列(用同一个 Comparator 即可)
关注的人的帖子需要按照时间戳来排序(旧的在前面),如果时间戳相同,那么就按照 PID(PostID) 来排序(升序,小的在前面)
- 请求格式:
GET /task4?id=[UserID]- 例如:
http://backend-public-dns:8080/MiniSite/task4?id=29964
- 例如:
- 响应格式(JSON):
{"name":"my_name", "profile":"my_profile_image_url", "followers":[{"name":"follower_name_1", "profile":"profile_image_url_1"}, {"name":"follower_name_2", "profile":"profile_image_url_2"}, ...], "posts":[{post1_json, post2_json, ...}]}- 例如:
returnRes({"name":"Mrigesh","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/1fd04396b266de0fa03bb63166966e.png"},"followers":[{"name":"Anshima","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/701235433e5338d0da521cf8f11e14.png"}, ...(Some followers are omitted here)...,{"name":"Zichang","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/1b1b2afd761166258b074a1c44c415.png"}],"posts":[{"content":"Wow, just experienced Cooperstown Baseball's Main Street [VHS] (1995)","timestamp":"2014-01-30 00:08:13","uid":35915,"name":"Suhail","image":"http://cmucloudsocial.s3.amazonaws.com/posts/Cooperstown_Baseball_s_Main_Street_VHS_1995_.png","pid":19143,"comments":[{"uid":35900,"timestamp":"2015-03-26 14:05:47","content":"This is a great video. You get the Hall, Double Day Field and a feel for this great town. Cooperstown has that old time feel. Something everyone can appreciate. It's baseball heaven. This isn't one of those tapes you watch annually. I have always wanted to go. After seeing this, I am making plans to go asap. My only gripe is the length. It should have been longer than (approx.) twenty-eight minutes. Still, a must have for every baseball fan.","name":"Debjani","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/af7ad2ca674c46b5799593c447b99b.png"},...(Some comments are omitted here)...],"profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/0d8642e4fb42c8cc61eb1c16cf88ba.png"},...(Some posts are omitted here)...,{"content":"Wow, just experienced Walker, Texas Ranger: Seasons 1-5 and the Final Season","timestamp":"2015-10-08 08:14:18","uid":35907,"name":"Mengyu","image":"http://cmucloudsocial.s3.amazonaws.com/posts/Walker_Texas_Ranger_Seasons_1_5_and_the_Final_Season.png","pid":103646,"comments":[{"uid":35910,"timestamp":"2015-10-21 02:39:01","content":"Walker, Texas Ranger is an awesome show! For years I've watched reruns on TV and now I can watch the whole dang thing again with no commercials. if you are a fan of karate or Indians or Chuck himself, this is a must watch. Kudos to all his co-stars. great DVDs!","name":"Prajwal","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/7c5889fadc362e815d8ceef234b1ae.png"},...(Some comments are omitted here)...,{"uid":35914,"timestamp":"2015-10-25 08:30:59","content":"I watch it over and over. His shows I can't get enough of. It has inspirited me to do kick boxing as an good work out.","name":"Siyuan","profile":"https://cmucloudsocial.s3.amazonaws.com/profiles/5c6661092d81b393473bda2ca9669a.png"}]})
- 例如:
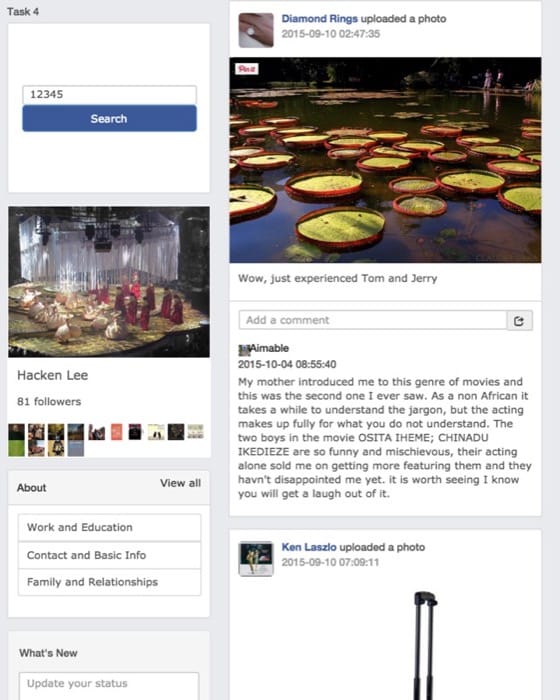
如果后端没有办法正确接收前端发来的请求,试着重启前端的应用
解题思路:
- 这里需要给 HBase 插入另一个表,因为这里需要看关注的人,具体的步骤我们在前面已经完成(参加任务 2)
- 找到给定 userid 关注的人的列表
- 在 MongoDB 中找到对应的 post,用优先队列存起来
- 全部完成后输出前 30 个(如果超过 30 个的话)
支线任务:简单推荐
简单来说就是做个推荐系统,具体推荐系统的介绍会专门写一篇来介绍(推荐系统我还是有比较多经验的)。这里我们只需要做一个协同过滤(Collaborative filtering)的推荐系统,利用『朋友的朋友』策略来推荐新朋友。
相关信息:
- 数据集:
User,UserInfo和之前 HBase 中的关系数据 - 对应的数据库:RDS 与 HBase
- 对应文件:RecommendationServlet.java,
/home/ubuntu/Project3_4/src/main/java/cc/cmu/edu/minisite/ - 注意!不要在代码中保存 AWS 密码
这里我们使用有向图的距离度量来作为推荐的依据(就是判断谁更值得推荐),具体的算法可以参考前面『背景知识』部分。
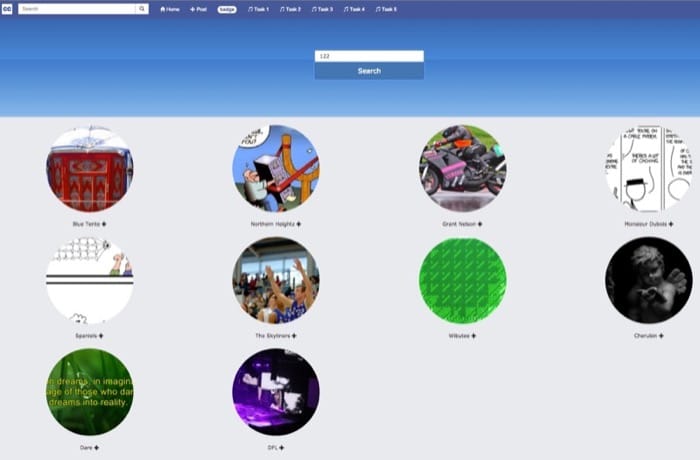
- 请求格式:
http://backend-public-dns:8080/MiniSite/task5?id=<user_id> - 响应格式(JSON):
returnRes({"recommendation":[{name:<name1>, profile:<profile1>},{name:<name2>, profile:<profile2>},...,{name:<name10>, profile:<profile10>]})
解题思路:
- 找到给定 userid 关注的人的集合
S - 对于集合
S中的元素s,把每个s关注的人都添加到新集合R中- 第一次出现的,值为 1
- 之后再出现的,值为原来的值加 1
- 统计完成之后可以遍历一次加入到另一个优先队列中(包括 userid,以及分值),并且需要注意 userid 本身和在集合
S中出现的元素都不应该添加到队列中 - 选取队列的前十个返回
- 最后从 MySQL 中取出这 10 个 userid 对应的 name 和 url,并返回
提交
- 复制 ETL 的命令、代码到
/home/ubuntu/Project3_4/src/main/java/cc/cmu/edu/minisite/ - 确保在
/home/ubuntu/Project3_4/src/main/java/cc/cmu/edu/minisite/中有以下文件:ProfileServlet.java,FollowerServlet.java,HomepageServlet.java,TimelineServlet.java,RecommendationServlet.java,MiniSite.java,references和其他自己创建的 Java 文件 - 保持后端运行,执行
./submitter -a <andrewid>,如果服务器太慢,可能会被认为是『无响应』