概率与统计:数据判断、统计推断与泊松分布
本页目录
更新历史
- 2016.11.27: 完成初稿
任务目标
- 复习概率和统计的基本知识
- 熟悉并掌握各种分布
- 意识到统计分析的数字是具有欺骗性
- 阅读推荐书籍
两类专家
开始复习之前,我们先来看看两类专家的对比(出自《信号与噪声》):
| 狐狸型专家的想法 | 刺猬型专家的想法 |
|---|---|
| 千伎百俩:汇聚不同学科的思想,忽略最初的政治派别 | 一技之长:把大部分精力投入到一两个重大问题上,以怀疑的眼光看待『局外人』的观点 |
| 适应力强:最初的方法失效后,试图找到新的方法,或同时寻求多种方法 | 坚持力强:坚持『总揽一切』的方法,新数据只能用来改善原始模式 |
| 严于律己:有时会愿意(或是欣于)承认预测中的错误并接受谴责 | 固执己见:错误归咎到坏运气或特殊情况上——好模式没有赶上好时机 |
| 承认复杂性:承认宇宙的复杂性,认为许多基本问题不可解决或本身就是不可预测的 | 寻找秩序:一旦从噪声中找到信号,便期望世界遵循某种相对简单的支配关系 |
| 谨慎:用概率术语表达预测结论,并且证明自己的观点是正确的 | 自信:很少对自己的预测进行正面回复,并且不愿改变自己的预测 |
| 经验主义:更多地依赖观察而非理论 | 意识形态:期待日常的问题正是宏伟理论或斗争的体现 |
| 较好的预测家 | 较差的预测家 |
我们学习数据挖掘,自然是希望自己能够成为『好』的预测家!而数据挖掘中很重要的一个意识就是:统计分析中陷阱重重。
统计分析中的陷阱
概率和统计是一种观察世界的角度,统计思维从某种程度上来说和读写能力一样重要。回顾自己常犯的错误,很多时候不是因为那些我不知道的事情,而是我知道的是错误答案的事情,这种错误的『正确感』最终导致了错误发生。而概率和统计其实是利用数据对我们已有的偏见进行纠正,这个过程中会有很多看似『反常』的结论出现。至于是相信感觉还是相信数字,啊这真是一个令人头疼的问题。下面是摘录自《统计陷阱》中的只言片语,大家可以先感受一下:
- 有三种谎言:谎言,糟糕透顶的谎言和统计资料
- 整数总是不完善的
- 单凭某一数据很难反应实情
- 一条河永远不可能高于它的源头,同理,对样本研究后得到的结论不会好于样本本身
- 一个以抽样为基础的报告如果要有价值,就必须使用具有代表性的样本,这种样本排除了各种误差
- 无形的误差与有形的误差一样容易破坏样本的可信度
- 普查工作者一般都具有足够的统计知识、技术以及调查费用以确保抽样的精确度。他们并非居心叵测之徒。但并不是所有能见到的数据都产生于这样良好的环境,也并不是所有的数据都会有附有类似的精确度说明
- 如果某条信息提供了显著性程度,你将对它有更深的了解。显著程度通常用概率表示
- 将『正常的』与『期望的』混为一谈导致事情变得更糟
- 这些没有透露的数据其欺骗性在于人们经常忽略了它们的不存在,这当然也是使用这些数据的人获取成功的奥秘
- 当一个平均数、一张图表或者某种趋势遗漏了这些重要的数据,请对它们保留一些怀疑
- 你的样本以多大的精度代表总体是可以用数据来衡量的,那就是:可能误差和标准误差
- 只有当差别有意义时才能称之为差别
- 注意比例尺和起始标尺,这可能会产生极大的误导性
- 利用一维图形的信息不对称,可以营造出非常夸张的视觉效果
- 如果你想证明某事,却发现没有能力办到,那么试着解释其他事情并假装它们是同一回事
- 相关并不等于因果,一定要注意这里的区别
- 扭曲统计数据的最巧妙方法是利用地图
- 百分数也给误解提供了肥沃的土壤。和小数一样,它也能为不确切的事物蒙上精确的面纱
- 将一些看似能直接相加却不能这样操作的事情加在一起会产生大量的欺骗和隐瞒
- 对统计资料提出的五个问题
- 谁说的?有意识的偏差和无意识的偏差
- 他是如何知道的?注意样本的有偏,数值是否足够大
- 遗漏了什么?
- 是否有人偷换了概念?
- 这个资料有意义吗?
- 我们以为自己可以控制很多风险,但结果并非如此,也许这才是更大的威胁
- 贪婪和恐惧是两个非常不稳定的因素,只有两者保持平衡,经济才能顺利发展。若贪婪在经济体系中占上风,就会产生经济泡沫;若恐惧因素压过贪婪,经济又会陷入恐慌
- 狐狸型预测方法
- 用概率的方法思考问题
- 今天的预测是你以后人生的第一个预测
- 寻求共识
- 信息是决定预测成败的关键,并不是信息越多,预测就越成功
- 经济是一个动态系统,不是一个方程式
- 运气和技能通常被视为两个极端,但两者之间的关系其实更复杂一些
- 若想做出更准确的预测,就必须承认我们的判断是不可靠的
是不是有点感觉了?那么现在复习课开始!
概率与统计基础知识
概率论主要研究随机事件,既然是研究,我们就不能用『可能/很可能/不太可能』这样的字眼了,要学会如何去量化这种可能性。
统计学主要是根据样本去推测总体情况,大部分的统计分析都是基于概率的,所以概率与统计经常会被放在一起。
那么概率与统计要如何复习呢?最简单粗暴的方法就是把一份我见过最完整的 Cheat Sheet 过一次(在这里),当然,这一讲也不会这么水,还是会把重要概念串讲一次的(部分内容来自《统计思维:程序员数学之概率统计》)。
假设我们要统计之前美国大选各个州各个城市的投票倾向,使用专业的统计学手段应该有如下几个步骤,才更可能绕过各种陷阱,得到更可能正确的结论(注意这里我一直在用可能,因为统计分析中,很少有东西是确定的):
- 收集数据 - 使用可靠来源的数据
- 描述性统计 - 计算能总结数据的统计量,并评测各种数据可视化的方法
- 探索性数据分析 - 寻找模式、差异和其他能解答我们问题的特征。同时,我们会检查不一致性,并确认其局限性
- 假设检验 - 在发现明显的影响时,我们需要评判这种影响是否真实,也就是说是否是因为随机因素造成的
- 估计 - 我们会用样本数据推断全部人口的特征
描述性统计量
当我们拿到一组数据,在别人问起『这组数据怎么样』这样的问题的时候,我们肯定不能把这组数据一个一个读出来,而是需要用一些数值来简单描述这组数据的特征,是为『描述性统计量』。
常见的描述性统计量包括均值、中位数、分位数、方差和标准差。它们回答不同的问题:均值描述位置,方差描述离散程度;同样的均值和方差,仍可能对应不同形状的分布。
直方图帮助观察样本分布,概率质量函数描述离散随机变量各取值的概率,条件概率则描述给定信息后的概率。后三者并不都是描述性统计量,也不是前一种方法无法使用后才出现的替代品。
连续分布
比较常用的连续分布是指数分布、帕累托分布、正态分布和对数正态分布,之所以称为『连续』,是因为它们的 CDF 是一个连续函数,而很多实际现象都近似于连续分布。
跟所有模型一样,连续分布也是一种抽象。换言之,就是会舍弃一些无关紧要的细节。例如,真实观察到的分布中可能会有测量误差或是对样本来说很奇怪的数据,而连续模型会消除这些无关紧要的细节。 连续模型也是一种数据压缩。如果模型能很好地拟合数据集,那么少量参数就可以描述大量数据。 有时候,我们会惊讶地发现某种自然现象服从某个连续分布,观察这些现象可以让我们深入理解真实的系统。
- 指数分布:齐次泊松过程中,相邻事件的等待时间服从指数分布;需要恒定发生率和独立增量等假设
- 帕累托分布:最初用来描述财富分布状况,后来广泛用于描述自然界和社会科学中的各种现象,包括城镇大小、砂粒和陨石、森林火灾和地震等
- 正态分布:也称为高斯分布,因其可以近似描述很多现象而成为最常用的分布
概率
概率可以认为是一个零到一之间的值,用于定量描述一件事情发生的可能性大小。如果 E 表示一个事件,那么 P(E) 就表示该事件发生的概率。检测 E 发生情况的过程就叫做试验(trial)。
虽然说关于概率本身的哲学意义还有一些争议,不过我们不妨暂时不去想它,来看看可能是历史上最富争议的概率问题 —— 蒙提霍尔问题(The Monty Hall problem)。
蒙提·霍尔原本是美国电视游戏节目 Let's Make a Deal 的主持人,蒙提霍尔问题就是源自该节目中的一个游戏。如果你是参赛者,以下是节目现场的情况。 你会看到三扇关闭的门,蒙提会告诉你每扇门后的奖励:其中有一扇门后面是一辆车,而另外两扇门后面则是诸如花生酱或假指甲之类不太值钱的东西。奖品的摆放是随机的。 你的目标就是要猜出哪扇门后是汽车。如果猜对,汽车就归你了。 我们把你选择的门称为 A 门,其他两扇门分别是 B 门和 C 门。 在打开你所选择的 A 门之前,蒙提往往会打开 B 门或 C 门扰乱你的选择。(如果汽车确实是在 A 门后面,那蒙提随机打开 B 门或 C 门都没有问题。) 接下来,蒙提会给你一个机会:你是坚持原来的选择,还是选择另一扇未打开的门。 问题是,坚持原来的选择或选择另一扇门,会有什么不同吗?
这里假定主持人知道奖品位置,总会打开一扇未被选中且没有汽车的门,并总给换门机会。这个看起来很简单的问题因为与人们的直觉完全不同而变得复杂了起来,一个靠谱的解释是:
大部分人凭直觉觉得这没有区别。因为,还剩下两扇门,所以汽车在A门后面的概率是50%。但这就错了。实际上,坚持选择A门,获胜的机会就只有 1/3;而如果选择另一扇门,获胜的机会就是 2/3。 其中的关键在于要明白,这里有三种可能的情况:汽车可能会在 A 门后,也可能在 B 门或 C 门后面。因为奖品是随机摆放的,所以每种情况的概率都是 1/3。 如果坚持选择 A 门,那么就只有在一开始汽车就在 A 门后面的情况下才能获胜,获胜的概率是 1/3。 但如果选择另一扇没打开的门,那么在 B 或 C 后面有车这两种情况下都会获胜,总体的获胜概率就是 2/3。
最后提一下聚类错觉(clustering illusion),指看上去好像有某种特点的聚类实际上是随机的。如何去验证呢?可以看看在随机情况下是否会产生类似聚类的概率,若类似聚集在随机模型下也很常见,就不能仅凭外观认定它有特殊含义,这个过程叫做蒙特卡罗模拟(Monte Carlo simulation)。
进阶知识
接下来的部分涉及到更加多的数学知识,因为篇幅所限,这里不再一一介绍,但是感兴趣的同学可以根据这些关键词按图索骥,一定会有不一样的收获。
- 分布的运算:偏度、随机变量、概率密度函数、卷积、正态分布性质、中心极限定理
- 假设检验:卡方检验、t 检验;模型评估另包括交叉验证
- 估计:方差估计、误差、置信区间、贝叶斯估计
- 相关性:协方差、最小二乘拟合、因果关系
术语表
术语表是很好的自查列表(内容来自《统计思维:程序员数学之概率统计》),如果有不明白的,可以去维基百科看看,或者一劳永逸找一本教材过一遍即可:
基本概念
- 经验之谈(anecdotal evidence): 个人随意收集的证据,而不是通过精心设计并经过研究得到的
- 直观效应(apparent effect): 表示发生了某种有意思的事情的度量或汇总统计量
- 人为(artifact): 由于偏差、测量错误或其他错误导致的直观效应
- 队列(cohort): 一组被调查者
- 横断面研究(cross-sectional study): 收集群体在特定时间点的数据的研究
- 字段(field): 数据库中组成记录的变量名称
- 纵贯研究(longitudinal study): 跟踪群体,随着时间推移对同一组人反复采集数据的研究
- 过采样(oversampling): 为了避免样本量过少,而增加某个子群体代表的数量
- 总体(population): 要研究的一组事物,通常是一群人,但这个术语也可用于动物、蔬菜和矿产
- 原始数据(raw data): 未经或只经过很少的检查、计算或解读而采集和重编码的值
- 重编码(recode): 通过对原始数据进行计算或是其他逻辑处理得到的值
- 记录(record): 数据库中关于一个人或其他对象的信息的集合
- 代表性(representative): 样本在研究关心的方面能反映目标总体;随机抽样有助于减少选择偏差,但不能保证单个样本完全代表总体
- 被调查者(respondent): 参与调查的人
- 样本(sample): 总体的一个子集,用于收集数据。
- 统计显著(statistically significant): 在指定原假设和检验方法下,p 值低于预设显著性水平;这不等于效应很大或已证明因果关系
- 汇总统计量(summary statistic): 通过计算将一个数据集归结到一个数字(或者是少量的几个数字),而这个数字能表示数据的某些特点
- 表(table): 数据库中若干记录的集合
描述性统计量
- 区间(bin): 将相近数值进行分组的范围
- 集中趋势(central tendency): 样本或总体的一种特征,直观来说就是最能代表平均水平的值
- 临床上有重要意义(clinically significant): 分组间差异等跟实践操作有关的结果
- 条件概率(conditional probability): 某些条件成立的情况下计算出的概率
- 分布(distribution): 对样本中的各个值及其频数或概率的总结
- 频数(frequency): 样本中某个值的出现次数
- 直方图(histogram): 从值到频数的映射,或者表示这种映射关系的图形
- 众数(mode): 样本中频数最高的值
- 归一化(normalization): 将频数除以样本大小得到概率的过程
- 异常值(outlier): 远离集中趋势的值
- 概率(probability): 描述事件发生可能性的数值;频数除以样本大小得到相对频率,可用于估计概率
- 概率质量函数(Probability Mass Function,PMF): 以函数的形式表示分布,该函数将值映射到概率
- 相对风险(relative risk): 两个概率的比值,通常用于衡量两个分布的差异
- 分散(spread): 样本或总体的特征,直观来说就是数据的变动有多大
- 标准差(standard deviation): 方差的平方根,也是分散的一种度量
- 修剪(trim): 删除数据集中的异常值
- 方差(variance): 用于量化分散程度的汇总统计量
累积分布函数
- 条件分布(conditional distribution): 在满足一定前提条件下计算出的分布
- 累积分布函数(Cumulative Distribution Function,CDF): 函数
- 四分差(interquartile range): 表示总体分散情况的值,等于75和25百分等级之间的差
- 百分位(percentile): 与百分等级相关联的数值
- 百分等级(percentile rank): 分布中小于或等于给定值的值在全部值中所占的百分比
- 放回(replacement): 在抽样过程中,“有放回”表示对于每次抽样,总体都是不变的。“无放回”表示每个元素只能选择一次
- 再抽样(resampling): 根据由样本计算得到的分布重新生成新的随机样本的过程
连续分布
- 连续分布(continuous distribution): 累积分布函数连续的分布;本文讨论的常见连续分布都有概率密度函数
- 语料库(corpus): 特定语言中用做样本的正文文本
- 经验分布(empirical distribution): 样本中值的分布
- 误差函数(error function): 一种特殊的数学函数,因源自误差度量研究而得名
- 一次频词(hapaxlegomenon): 表示语料库中只出现一次的词。这个单词在本书中迄今出现了两次
- 间隔时间(interarrival time): 两个事件的时间间隔
- 模型(model): 一种有效的简化。对于很多复杂的经验分布,连续分布是不错的模型
- 正态概率图(normal probability plot): 一种统计图形,用于表示样本中排序后的值与其服从正态分布时的期望值之间的关系
- 秩变换(rankit): 元素的期望值,该元素位于服从正态分布的已排序列表中。
概率
- 贝叶斯认识论(Bayesianism): 一种对概率更泛化的解释,用概率表示可信的程度
- 变异系数(coefficient of variation): 度量数据分散程度的统计量,按集中趋势归一化,用于比较不同均值的分布
- 事件(event): 按一定概率发生的事情
- 失败(failure): 事件没有发生的试验
- 频率论(frequentism): 对概率的一种严格解读,认为概率只能用于一系列完全相同的试验
- 独立(independent): 若两个事件之间相互没有影响,就称这两个事件是独立的
- 证据的似然值(likelihood of the evidence): 贝叶斯定理中的一个概念,表示假设成立的情况下看到该证据的概率
- 蒙特卡罗模拟(Monte Carlo simulation): 通过模拟随机过程计算概率的方法
- 归一化常量(normalizing constant): 贝叶斯定理中的分母,用于将计算结果归一化为概率
- 后验(posterior): 贝叶斯更新后计算出的概率
- 先验(prior): 贝叶斯更新前计算出的概率
- 成功(success): 事件发生了的试验
- 试验(trial): 对一系列事件是否可能发生的尝试
- 更新(update): 用数据修改概率的过程。
分布的运算
- 中心极限定理(Central Limit Theorem): 早期的统计学家弗朗西斯·高尔顿爵士认为中心极限定理是“The supreme law of Unreason”
- 卷积(convolution): 一种运算,可用于计算两个独立随机变量之和的分布
- 虚幻的优越性(illusory superiority): 心理学概念,是指人们普遍存在的将自己高估的一种心理
- 概率密度函数(probability density function): 连续型累积分布函数的导数
- 随机变量(random variable): 一个能代表一种随机过程的客体
- 随机数(random variate): 随机变量的实现
- 鲁棒性(robust): 如果一个统计量不容易受到异常值的影响,我们说它是鲁棒的
- 偏度(skewness): 分布函数的一种特征,它度量的是分布函数的不对称程度
假设检验
- 单元格(cell): 在卡方检验中,将观测按一定的标准分到各个单元格里,每个单元格代表一种分类
- 卡方检验(chi-square test): 用卡方统计量做统计量的统计检验
- 交叉验证(cross-validation): 交叉验证使用一个数据集进行探索性数据分析,然后用另一个数据集进行测试
- 假阴性(false negative): 在效应真实存在的情况下,我们认为这个效应是由偶然因素引起的
- 假阳性(false positive): 在原假设为真的情况下,我们拒绝了原假设的结论
- 假设检验(hypothesis testing): 判定出现的效应是否具有统计显著性的过程
- 似然比(likelihood ratio): 一种概率的比值, P(E|A)/P(E|B),这里A和B是两种假设。似然比不依赖于先验概率,可以用来报道贝叶斯统计推断的结果
- 原假设(null hypothesis): 一种基于以下假设的模型系统:我们观测到的效应只是由偶然因素引起的
- 单边检验(one-sided test): 一种检验类型,关注的是出现比观测到的效应更大(或小)的效应的概率
- p值(p-value): 在原假设成立的情况下,得到当前检验统计量或更极端结果的概率
- 功效(power): 在原假设为假的情况下,检验推翻原假设的概率
- 显著性(significant): 我们说某个效应具有统计显著性指的是这种情况不大可能是由偶然因素引起的
- 检验统计量(test statistic): 衡量观测到的效应与原假设下期望的结果之间偏差的统计量
- 测试集(testing set): 用做测试的数据集
- 训练集(training set): 用做训练的数据集
- 双边检验(two-sided test): 一种检验类型,关注的是出现比观测到的效应更大的效应的概率,不考虑正负
估计
- 有偏性(bias): 在平均多次试验的结果后,一个估计量倾向于高估或者低估真实的参数值
- 删失数据(censored data): 一种数据集,数据来源于某种采集方式,但是这种采集方式会系统性地排除某些数据
- 置信区间(confidence interval): 一种区间估计程序;重复抽样时,按同一方法构造的区间有指定比例覆盖真实参数
- 可信区间(credible interval): 给定数据和先验后,包含指定后验概率质量的参数区间
- 估计(estimation): 用样本信息估计分布中未知参数的过程
- 估计量(estimator): 用于估计参数的统计量
- 极大似然估计量(maximum likelihood estimator): 使得似然函数最大化的估计
- 均方误差(mean squared error): 一种衡量估计误差的值
- 点估计(point estimate): 用单一的值估计某个参数
相关性
- 确定系数(coefficient of determination): 衡量模型拟合结果好坏的指标
- 对照组(control group): 对照试验中没有接受处理的组,或受到已知效应处理的组
- 相关性(correlation): 对两个变量关系的一种描述
- 协方差(covariance): 衡量两个变量变化方向是否一致的统计量
- 因变量(dependent variable): 我们想要解释或者预测的变量
- 自变量(independent variable): 用于预测因变量的变量,也称解释变量
- 最小二乘拟合(least squares fit): 最小化残差平方和的数据拟合方法
- 自然试验(natural experiment): 一种试验设计的方法,就是利用自然形成的界限将受试者分成几个分组,并且大体上使得分组结果接近随机分组
- 标准化(standardize): 将一组数据进行转换,使其均值为 0,方差为 1(原始方差需非零)
- 随机对照试验(randomized controlled trial): 一种试验设计的方法,将受试者随机分成几个分组,并对不同的分组实施不同的处理
- 秩(rank): 将一个序列按大小排序后,序列中的某个元素所处的位置
- 残差(residual): 衡量模型预测结果与真实值离差的值
- 标准分数(standard score): 归一化后的值
- 处理(treatment): 对照试验中对一个分组所做的干预或改变
推荐书籍
- Statistics for business and economics
- Data Mining: concepts and technologies
- 数据挖掘导论
- Python for Data Analysis
- Web Analysis
- 深入浅出数据分析
- 增长黑客
- 网站分析实战
- 精益数据分析
- 统计陷阱
- 统计思维:程序员数学之概率统计
试一试
- 找个朋友问一下蒙提霍尔问题,看看最后你能解释清楚没有
- 试着用概率统计的思维去观察一下,有没有什么新发现?
总结
概率与统计既提供计算工具,也要求我们持续检查数据和推断的前提。接下来可以阅读互联网数据挖掘导论。
统计学傻瓜指南
- 统计学是搜集、整理、总结、分析数据以及依据数据进行推断的科学
- 统计数据,包括搜集数据、整理数据、总结数据、分析数据以及将数据呈现出来
- 统计推断,包括进行推测、假设检验、确定关系然后作出预测
变量
- 定量的(Quantitative)
- 离散的(Discrete)
- 连续的(Continuous)
- 定性的(Qualitative)
- 有序的(Ordinal)
- 分类的(Categorical)
参数检验与非参数检验
- 参数检验:需要知道样本统计量的分布才能作出决断
- 非参数检验:不要求总体属于某个特定参数分布族,但仍有独立性、可交换性等适用条件
t-检验
在样本中比较连续变量的平均数,以检验两个均值之间的差异是否大于能被机遇所解释的差异。
均值有差异,概率是多少?
应用条件
- 观测值(变量)相互独立
- 从正态分布的总体中抽样得到
- 总体方差未知时常使用 t 检验,不以样本量 30 为硬分界;z 检验不是二项检验。两独立样本方差不等时可考虑 Welch t 检验
t- 检验的类型
- 单样本 t 检验:某个变量的样本均数与给定总体的已知均数相比,其差异是否有意义
- 非配对或独立 t 检验:检验由两个独立估计的总体均数之间的差异是否有意义(如男性群体和女性群体)
- 配对 t 检验:检验由相关样本估计的总体均数之间的差异是否有意义(如给同一组病人施加处理前后测量值的均数)
卡方检验
- 可检验定性变量是否独立,或观测频数是否符合给定分布;统计显著不直接等于关联强度
- 用于分类数据
应用条件
- 数据应以频数的形式呈现
- 观测应独立,且期望频数不能过小;稀疏列联表可考虑精确检验,不能仅用总样本量判断是否适用
相关与回归
研究两个或两个以上变量之间的关联的强度以及函数关系的方法
- 相关:指明变量间关联的强度
- 回归
- 提示一个因变量与一个或多个自变量间数学关系的方法
- 简单线性回归和多重回归适用于连续变量如血压、体重
- Logistic 回归适用于二值响应,如生/死
方差分析(ANOVA)
用来揭示作用于一个因变量的几个分类自变量(称为因素)的主效应和交互效应
- 单因素方差分析(One-way ANOVA): 检验一个因变量在一个分类自变量两组、三组或多组类别间的差异
- 两因素方差分析(Two-way ANOVA): 分析一个因变量在两个自变量所形成的组间的差异,其中一个自变量可以看作处理变量
- 多因素方差分析(n-way ANOVA): 简言之,多因素方差分析处理多个自变量。应当注意,自变量的个数越多,可能的交互作用的数量也随之增多
参考链接
泊松分布:从事件计数到备货问题
本节整理自 2019 年 4 月 30 日的《泊松分布的理解》。
定义
泊松分布(Poisson distribution)用于描述固定区间内的事件计数。下面以齐次泊松过程为例,假设不相交区间的计数独立、事件发生率恒定,极短时间内多次事件的概率可忽略。广告点击等实际数据是否满足这些条件,需要另外检查。
泊松分布的概率函数为:
泊松分布的参数 是单位时间(或单位面积)内随机事件的平均发生次数。 泊松分布适合于描述单位时间内随机事件发生的次数。
实例说明
前面看公式还是非常不直观,现在来举一个例子:已知平均每小时出生3个婴儿,请问下一个小时,会出生几个?具体的数字肯定谁都说不清楚,但冥冥之中肯定是有一定的规律的,而这个规律就可以用泊松分布来描述。
我们再看一次公式:
P 表示概率,N(t) 表示 t 时间内的事件数,n 表示数量,那么 1 个小时内出生 3 个婴儿的概率就是 P(N(1)=3),而 表示单位时间的平均发生率(在这个例子中,因为每个小时出生 3 个婴儿,所以 )
那么接下两个小时(t=2),一个婴儿(n=0)都不出生的概率是多少呢:
计算出来概率是 0.25%,是一个较小但非零的概率。那么接下来一个小时,至少出生两个婴儿的概率是多少呢?计算方法就是 1 减去 一个小时生 1 个的概率再减去一个小时生 0 个的概率。
也就是说接下来一小时至少出生两个婴儿的概率是 80%。如果我们把图画出来,大概是这样:
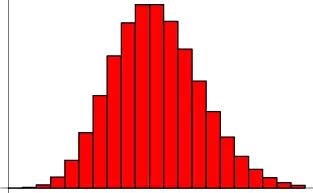
泊松分布一般并不对称。参数为 3 时,2 和 3 都是众数;参数较大时,形状才逐渐接近对称。在齐次泊松过程中,事件数服从泊松分布,等待时间服从指数分布。仅有“事件独立”还不够,需要满足前面列出的过程假设。
深入理解
那么为什么泊松分布可以描述单位时间内独立事件发生次数的概率分布呢?公式是如何推导的呢?我们这一节来了解一下。
假如我开了一家煎饼果子店,生意不错,但是因为每天都有不一样的行情,问题来了,我每天要准备多少料,才不会浪费并且又满足客户的需求呢?
我统计了一下上一周每天卖出去煎饼果子的数量(参考 如何通俗理解泊松分布?)
| 时间 | 销售量 |
|---|---|
| 周一 | 3 |
| 周二 | 7 |
| 周三 | 4 |
| 周四 | 6 |
| 周五 | 5 |
平均值为 ,如果按平均值来准备的话,周二和周四都不够卖,那么有没有办法降低这个比例?于是我拿起了纸,开始进行计算
对于周一来说,卖出了 3 个,把周一的时间平均分为 4 份的话,相当于每个时间段内要么卖出了一个,要么没有卖出,相当于抛了四次硬币,并且 3 次正面(卖出 3 个),这个概率用二项分布来计算就是(p 表示卖出的概率):
好了,你可能会说,可能在一个时间段内不止卖出一个,那么这个公式就说不过去了,比如第一个时间段里就卖出了 2 个呢?
不要紧张,没有问题,现在我们只分成了 4 份,如果我们分成 4000 份甚至无限份,那么在上述过程假设下,每小段内出现多个事件的概率会变得可忽略,用公式表示就是:
好,那现在剩下的问题就是,这个概率 p 要如何确定,因为卖不卖得出煎饼果子已经被转化为二项分布,那么期望为 ,所以 ,我们把这个带入到前面的公式中这里的 p 表示事件发生的概率,n 表示总分数(求极限),k 表示事件发生的次数:
计算一下
其中
所以,在 T 时间内卖出 k 个煎饼果子的概率就是(一般我们这里把 记为 )
那么最后的问题就是, 如何确定,我们可以用样本均值来近似,于是
那么如何确定每天准备多少个?计算 ,即准备 8 份在该模型下约有 93.2% 的概率满足需求。实际备货还需考虑参数估计误差、缺货与浪费成本。
注意,当二项分布的 p 很小的时候,二项分布和泊松分布是非常接近的
参考资料
相关文章
- 机器学习平台设计:让实验能够交付2026-11-06
- 【机器学习与数据科学之旅】1 Numpy 实例指南2020-06-16
- 【机器学习与数据科学之旅】2 Pandas 实例指南2020-06-16
- 基于场景的新闻分析分享2018-12-29