推荐系统快速入门
本页目录
任务目标
- 了解推荐系统的基本原理及常见方法
- 阅读相关博客与书籍
从产品出发
推荐方法有内容推荐、协同过滤、关联规则、效用、知识和混合推荐等。选择方法之前,先明确用户在什么位置看到结果、能提供什么反馈,以及产品希望改善什么。
单个卡片、长列表和首页入口,对多样性、相关性和反馈速度的要求不同。算法在离线数据上的分数只是一个方面,还需要考虑呈现方式、用户满意度和长期留存。理解数据和业务,比追逐模型名称更重要。
从两次旧项目讨论中补充
2014 年的《聊聊推荐系统(一)》从书籍推荐的体验出发,《再聊推荐算法》则记录了服装图像检索项目中的困惑。把当时的产品猜测与尚未验证的设想分开后,有几件事值得留下。
推荐理由也是结果的一部分
书籍的封面和标题不足以让我判断是否想读。我还想知道:推荐来自哪本已读书、哪种兴趣,还是哪类相似读者?这不是要求把复杂模型全部展示出来,而是给出真实、能够帮助判断的线索。界面上的标签或字号并不能证明后台采用了某一种算法,也不能凭自己的不满意断言系统“只了解书,不了解人”。
当时我提出从阅读习惯相近的人出发建立联系。这可以作为用户协同过滤或用户表示的思路,但还需要数据和实验验证。用户在不同时间的阅读目的也可能不同,不能只靠一个固定的性格标签解释全部兴趣。
商品更新快,数据流程就要跟上
服装检索项目让我意识到,静态数据集上的结果无法直接回答新增商品、下架商品和偏好变化的问题。这里的差异不意味着研究算法不能使用,而是部署时还要考虑更新频率、特征生成、索引刷新和冷启动。评价数据也应该反映这些变化,不能把测试集里的未来行为泄漏进训练过程。
原稿用“一维”和“升维”比喻引入更多信息,容易与向量的数学维度混淆。更准确地说,当时想结合图像相似度、商品属性和用户行为等不同信号。例如先用图像检索得到候选,再结合尺码、品类、库存等约束和偏好排序。这是一个待验证的组合方案,不保证加了信号就会更好。
把可维护性和评价一起设计
当时测试代码直接访问底层数据,存储一变,多个模块都要跟着改。我想要的是稳定的数据访问与索引接口,让检索逻辑不必知道文件具体放在哪里,而不是为了抽象再造一个庞大的虚拟文件系统。
同样重要的是先决定怎样判断变化有没有帮助:检索相关性是否提高,延迟和更新成本是否可接受,用户是否更容易找到合适商品。把数据与索引更新自动化,记录实验版本,再在同样的输入和指标下比较,才有可能区分算法变化和数据变化的影响。
主要推荐方法的对比
| 推荐方法 | 优点 | 缺点 |
|---|---|---|
| 基于内容推荐 | 推荐结果直观,容易解释;不需要领域知识 | 稀疏问题;新用户问题;复杂属性不好处理;要有足够数据构造分类器 |
| 协同过滤推荐 | 新异兴趣发现、不需要领域知识;随着时间推移性能提高;推荐个性化、自动化程度高;能处理复杂的非结构化对象 | 稀疏问题;可扩展性问题;新用户问题;质量取决于历史数据集;系统开始时推荐质量差; |
| 基于规则推荐 | 能发现新兴趣点;不要领域知识 | 规则抽取难、耗时;产品名同义性问题;个性化程度低; |
| 基于效用推荐 | 无冷开始和稀疏问题;对用户偏好变化敏感;能考虑非产品特性 | 用户必须输入效用函数;推荐是静态的,灵活性差;属性重叠问题; |
| 基于知识推荐 | 能把用户需求映射到产品上;能考虑非产品属性 | 知识难获得;推荐是静态的 |
冷启动问题
- 用户冷启动
- 提供 热门排行榜/热销榜/热搜榜,引导用户
- 利用客户提交的年龄,性别做粗粒度的个性化
- 物品冷启动
- 精准推荐/模糊推荐
- 推荐给喜欢该商品的用户/商品相似度的用户
- 提供非个性化的推荐
- 利用社交网站授权,导入好友关系,给用户推荐好友喜欢的物品
- 登录时根据用户的反馈,收集用户兴趣,给用户推荐和反馈的相似的物品(ItemCF)
- 利用用户注册信息
- 人口统计学信息(年龄/性别/职业/学历/居住地)
- 用户兴趣的描述
- 导入站外行为数据(社交网络的数据)
- 流程
- 获取用户注册信息
- 将注册的用户分类
- 给用户推荐所属分类中用户喜欢的物品
- 选择合适的物品启动用户兴趣
- 热门
- 具有代表性和区分性 电影:卖票并且受欢迎的
- 启动物品集合需要多样性 Nadav Golbandi
- 利用物品的内容信息
- 关键词向量(文本-分词-实体检测-关键词排名-关键词向量)
- 发挥专家的作用
- Pandora(个性化电台)组织专家项目组,对歌曲维度进行标注
- Jinni(电影基因系统)
- 半人工-专家总结电影基因,创建基因库
- 半自动-文本分析
A/B 测试与评价
产品改变不一定意味着进步。在线实验需要确定随机分流单位、核心指标、样本量和观察周期,再比较不同方案。可以测试单个因素,也可以比较完整方案;后者只能说明整体效果,不能自动归因到某个细节。
例如,A 的转化率为 6.5%,B 为 7.5%,还需要样本量与不确定性才能判断差异。应分析两组差值的区间和实际收益,而不是只看单组区间是否重叠。频率学派的置信水平不等于“B 胜出的概率”;多次查看并提前结束实验也会影响错误率控制。
离线评价同样要对应任务:评分预测可看误差,Top-N 推荐可看 Precision、Recall、MRR 或 NDCG。训练测试划分应避免未来信息泄漏;点击多不一定代表用户满意。
实践中值得记住的事
- 先确定是否真的需要推荐系统,以及要解决什么用户问题。
- 平衡商业目标和用户体验,观察长期影响。
- 选择团队能够维护的实现,先建立可比较的基线。
- 冷启动需要设计:热门内容、用户主动选择的兴趣和物品内容都可提供初始信息。
- 理解数据如何产生,区分未曝光、未点击与明确不喜欢。
- 相关的物品不一定适合在任何时机推荐,呈现方式同样重要。
- 社交关系可作为信号,但不能代替兴趣相似性。
- 同时考虑延迟、规模和更新频率。
- 选择合适的反馈方式,避免把所有行为都视为同一种偏好。
- 保留可靠的评价流程,知道何时值得继续优化模型。
基于内容推荐
基于内容的推荐(Content-based Recommendation)是信息过滤技术的延续与发展,它是建立在项目的内容信息上作出推荐的,而不需要依据用户对项目的评价意见,更多地需要用机 器学习的方法从关于内容的特征描述的事例中得到用户的兴趣资料。在基于内容的推荐系统中,项目或对象是通过相关的特征的属性来定义,系统基于用户评价对象 的特征,学习用户的兴趣,考察用户资料与待预测项目的相匹配程度。用户的资料模型取决于所用学习方法,常用的有决策树、神经网络和基于向量的表示方法等。 基于内容的用户资料是需要有用户的历史数据,用户资料模型可能随着用户的偏好改变而发生变化。
基于内容推荐方法的优点是:
- 不依赖其他用户的交互数据,能缓解协同过滤中的部分稀疏问题;新用户缺少偏好信息时仍有冷启动问题。
- 能为具有特殊兴趣爱好的用户进行推荐。
- 能推荐新的或不是很流行的项目,没有新项目问题。
- 通过列出推荐项目的内容特征,可以解释为什么推荐那些项目。
- 已有比较好的技术,如关于分类学习方面的技术已相当成熟。
缺点是要求内容能容易抽取成有意义的特征,要求特征内容有良好的结构性,并且用户的口味必须能够用内容特征形式来表达,不能显式地得到其它用户的判断情况。
协同过滤推荐
协同过滤推荐(Collaborative Filtering Recommendation)技术是推荐系统中应用最早和最为成功的技术之一。它一般采用最近邻技术,利用用户的历史喜好信息计算用户之间的距离,然后 利用目标用户的最近邻居用户对商品评价的加权评价值来预测目标用户对特定商品的喜好程度,系统从而根据这一喜好程度来对目标用户进行推荐。协同过滤最大优 点是对推荐对象没有特殊的要求,能处理非结构化的复杂对象,如音乐、电影。
协同过滤是基于这样的假设:为一用户找到他真正感兴趣的内容的好方法是首先找到与此用户有相似兴趣的其他用户,然后将他们感兴趣的内容推荐给此用户。其基本 思想非常易于理解,在日常生活中,我们往往会利用好朋友的推荐来进行一些选择。协同过滤正是把这一思想运用到电子商务推荐系统中来,基于其他用户对某一内 容的评价来向目标用户进行推荐。
基于协同过滤的推荐系统可以说是从用户的角度来进行相应推荐的,而且是自动的,即用户获得的推荐是系统从购买模式或浏览行为等隐式获得的,不需要用户努力地找到适合自己兴趣的推荐信息,如填写一些调查表格等。
和基于内容的过滤方法相比,协同过滤具有如下的优点:
- 能够过滤难以进行机器自动内容分析的信息,如艺术品,音乐等。
- 共享其他人的经验,避免了内容分析的不完全和不精确,并且能够基于一些复杂的,难以表述的概念(如信息质量、个人品味)进行过滤。
- 有推荐新信息的能力。可以发现内容上完全不相似的信息,用户对推荐信息的内容事先是预料不到的。这也是协同过滤和基于内容的过滤一个较大的差别,基于内容的过滤推荐很多都是用户本来就熟悉的内容,而协同过滤可以发现用户潜在的但自己尚未发现的兴趣偏好。
- 能够有效的使用其他相似用户的反馈信息,减少所需的用户反馈量,加快个性化学习的速度。 虽然协同过滤作为一种典型的推荐技术有其相当的应用,但协同过滤仍有许多的问题需要解决。最典型的问题有稀疏问题(Sparsity)和可扩展问题(Scalability)。
协同过滤(CF)可以看做是一个分类问题,也可以看做是矩阵分解问题。协同滤波主要是基于每个人自己的喜好都类似这一特征,它不依赖于个人的基本信息。比如刚刚那个电影评分的例子中,预测那些没有被评分的电影的分数只依赖于已经打分的那些分数,并不需要去学习那些电影的特征。
SVD将矩阵分解为三个矩阵的乘积,公式如下所示:
中间的矩阵sigma为对角矩阵,对角元素的值为Data矩阵的奇异值(注意奇异值和特征值是不同的),且已经从大到小排列好了。即使去掉奇异值较小的方向,依然可以很好的重构出原始矩阵。
截断 SVD 保留较大的奇异值,可近似重构完整矩阵。但推荐数据中的“未评分”不是零分,不能不加处理就对稀疏评分矩阵套用普通 SVD。实际矩阵分解通常只在观测项上优化误差,并加入正则化;用户向量与物品向量的内积用于估计偏好。
基于关联规则推荐
基于关联规则的推荐(Association Rule-based Recommendation)是以关联规则为基础,把已购商品作为规则头,规则体为推荐对象。关联规则挖掘可以发现不同商品在销售过程中的相关性,在零 售业中已经得到了成功的应用。管理规则就是在一个交易数据库中统计购买了商品集X的交易中有多大比例的交易同时购买了商品集Y,其直观的意义就是用户在购 买某些商品的时候有多大倾向去购买另外一些商品。比如购买牛奶的同时很多人会同时购买面包。
算法的第一步关联规则的发现最为关键且最耗时,是算法的瓶颈,但可以离线进行。其次,商品名称的同义性问题也是关联规则的一个难点。
基于效用推荐
基于效用的推荐(Utility-based Recommendation)是建立在对用户使用项目的效用情况上计算的,其核心问题是怎么样为每一个用户去创建一个效用函数,因此,用户资料模型很大 程度上是由系统所采用的效用函数决定的。基于效用推荐的好处是它能把非产品的属性,如提供商的可靠性(Vendor Reliability)和产品的可得性(Product Availability)等考虑到效用计算中。
基于知识推荐
基于知识的推荐(Knowledge-based Recommendation)在某种程度是可以看成是一种推理(Inference)技术,它可通过显式需求、领域知识和约束进行推理,不一定依赖大量历史评分。基于知识的方法因它们所用的功能知识不同而有明显区别。效用知识(Functional Knowledge)是一种关于一个项目如何满足某一特定用户的知识,因此能解释需要和推荐的关系,所以用户资料可以是任何能支持推理的知识结构,它可以是用户已经规范化的查询,也可以是一个更详细的用户需要的表示。
组合推荐
由于各种推荐方法都有优缺点,所以在实际中,组合推荐(Hybrid Recommendation)经常被采用。研究和应用最多的是内容推荐和协同过滤推荐的组合。最简单的做法就是分别用基于内容的方法和协同过滤推荐方法 去产生一个推荐预测结果,然后用某方法组合其结果。尽管从理论上有很多种推荐组合方法,但在某一具体问题中并不见得都有效,组合推荐一个最重要原则就是通 过组合后要能避免或弥补各自推荐技术的弱点。
在组合方式上,有研究人员提出了七种组合思路:
- 加权(Weight):加权多种推荐技术结果。
- 变换(Switch):根据问题背景和实际情况或要求决定变换采用不同的推荐技术。
- 混合(Mixed):同时采用多种推荐技术给出多种推荐结果为用户提供参考。
- 特征组合(Feature combination):组合来自不同推荐数据源的特征被另一种推荐算法所采用。
- 层叠(Cascade):先用一种推荐技术产生一种粗糙的推荐结果,第二种推荐技术在此推荐结果的基础上进一步作出更精确的推荐。
- 特征扩充(Feature augmentation):一种技术产生附加的特征信息嵌入到另一种推荐技术的特征输入中。
- 元级别(Meta-level):用一种推荐方法产生的模型作为另一种推荐方法的输入。
推荐书籍
- 《推荐系统实践》
- 一些发表的综述论文
信息推荐
推荐技术
- 基于内容的过滤/推荐(Content-based Filtering/Recommendation)
- 基于用户的历史推荐物品
- 基于内容特征描述来预测用户的偏好
- 协同过滤/推荐(Collaborative Filtering/Recommendation)
- 基于用户群体行为
- 基于其他具有相似行为的用户为给定用户推荐物品
- 混合式
基于内容的推荐
- 主要思想:为一个用户推荐与该用户之前感兴趣的物品相似的物品
- 电影推荐:推荐具有相同演员、导演、类型的电影
- 新闻推荐:推荐具有相似话题的新闻
- 用户配置档案(User Profiling)是关键
- 用户画像
- 基于用户的历史推荐物品
- 从样例内容特征描述中基于机器学习与数据挖掘算法获得关于用户兴趣爱好的配置档案
- 物品表示(Item Representation)
- 物品一般存储在数据库表中
- 结构化数据
- 一定数量的属性
- 每个物品由同样的属性集所描述
- 属性的取值范围一般明确
- 非结构化数据
- 自由文本,可转为结构化表达
- 每个词可看做一个属性
- 用户配置档案(User Profile)
- 包含两类信息
- 用户兴趣模型,例如,一个能预测用户对某个物品感兴趣可能性的函数表达(可以机器学习建模)
- 用户交互历史,例如,用户浏览的物品,用户购买的物品等
- 用户交互历史可用作训练数据,基于该训练数据采用机器学习算法创建用户兴趣模型
- 可由用户人工创建
- 提供选项界面供用户构建
- 简单数据库查询可找到满足用户条件的物品并推荐给用户
- 不足
- 耗费用户精力
- 不能及时反映兴趣爱好的变化
- 不能对推荐物品进行排序
- 基于机器学习的用户建模
- 基于分类学习从用户历史中对用户兴趣建模
- 应用分类函数能够获得用户对某物品感兴趣的概率
- 多种分类学习算法可以应用
- 决策树:构建一颗决策树表示用户兴趣爱好
- 最近邻:将所有训练样例存储于内存中,为新的物品找到 K 个最近邻的物品,从用户对这些最近邻物品的偏好计算用户对新物品的偏好
- 基于分类学习从用户历史中对用户兴趣建模
- 包含两类信息
协同推荐
- 基于用户群体
- 方法
- 对于给定的用户,找到相似的用户
- 为给定用户推荐被相似用户高度评分的物品(未被给定用户评分)
- 优势
- 不需要分析内容
- 能够捕捉微妙的线索、关系
- 三类主要的协同推荐
- 基于用户
- 思想:在过去对物品购买、评分一致的用户很可能再次一致
- 使用相似用户的意见预测特定用户对于一个物品的意见
- 用户相似性通过用户对其他物品的意见吻合程度来衡量
- 算法1:使用整个矩阵
- 算法2:K 近邻
- 用户冷启动(cold-start)问题
- 不足以确定新用户的相似用户
- 数据稀疏(sparsity)问题
- 当物品数量很多时,用户通常只评价了极少一部分物品,同样难以找到相似用户
- 扩展性问题
- 当有百万用户和物品时,计算很慢
- 物品冷启动问题
- 不能为新物品预测用户评分,除非已有相似用户对该物品进行评分(注:基于内容的推荐中不存在该问题)
- 基于物品
- 一个用户很可能对相似的物品具有相同的评分(类似基于内容的推荐)
- 物品相似性通过其他用户对物品的评分意见吻合程度来衡量(与基于内容的推荐不同)
- 相比于基于用户协同推荐的优势
- 更好地处理用户冷启动问题
- 提高稳定性(物品相似性要比用户相似性更稳定)
- 基于矩阵分解
- 将评分矩阵分解为两个矩阵(也可以是多个),基于分解结果可计算获得用户对物品的评分(该评分在原始矩阵中不存在)
- 求解方法
- Alternating least squares
- Stochastic gradient descent
- 基于用户
- 需要一个评分矩阵
- 矩阵每个元素表示一个用户针对一个物品的评分
- 显式反馈:用户主动评分、喜欢或不喜欢
- 隐式反馈:购买、点击、页面浏览和停留时间等
推荐结果的评估准则
- 根据不同的推荐问题和具体需求而选择
- Precision, Recall, MRR, Mean absolute error
更多推荐技术
- 基于社交网络的推荐
- 基于地理位置的推荐
- 多模态内容综合推荐
- 集合推荐/组合推荐
补记:DCN 与显式特征交叉
以下整理自 2019 年 6 月 13 日的 DCN 笔记,讨论 2017 年提出的原始 Deep & Cross Network。它是点击率预测的一种模型结构,而不是推荐系统的全部流程。
类别特征经嵌入后,与数值特征一起组成输入向量,再并行进入 Cross Network 和 Deep Network,最后组合两条分支的表示来预测。Deep 分支通过非线性层学习隐式交互,Cross 分支则显式构造有限阶特征交叉。
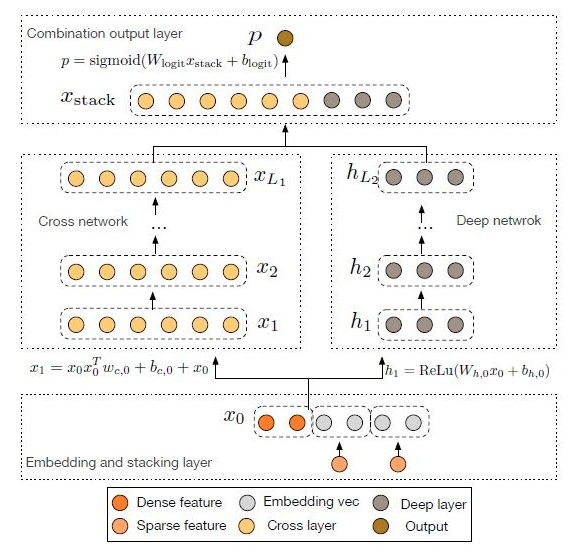
原始交叉层可以写成:
其中输入和各层输出维度相同,括号内是标量。每一层都与原始输入交互,叠加 个交叉层可以表达最高 阶的交叉项;这不代表任意多项式系数都可以独立学习。向量参数化让每层的参数量与输入维度线性相关。
原稿所说“不需要人工特征工程”,应理解为减少手工枚举交叉组合。数据清洗、类别编码、样本构造和数据泄漏检查仍然必要。论文中的精度和内存优势来自其特定实验,不能据此保证所有业务数据上都优于其他模型。
参考原论文:Deep & Cross Network for Ad Click Predictions。原笔记的第三方实现仅作为历史代码入口,运行前需要另行核对依赖与实现细节。
延伸阅读与数据集
以下合并自 2018 年的《推荐系统相关资源》,保留研究入口,省略当时的学者任职信息和工具版本比较。
- ACM RecSys:推荐系统研究;也可以关注 KDD、SIGIR、WSDM 中的相关工作。
- 《推荐系统实践》(项亮):结合工程思路学习经典推荐方法。
- Matrix Factorization Techniques for Recommender Systems:矩阵分解的基本思路。
- Item-Based Collaborative Filtering Recommendation Algorithms:基于物品的协同过滤。
- Collaborative Filtering with Temporal Dynamics:考虑偏好随时间变化。
- Hybrid Recommender Systems: Survey and Experiments:混合推荐方法。
- Neural Collaborative Filtering:用神经网络建模交互。
- MovieLens 数据集:用于评分预测等实验,具体字段和使用条件以所选版本的 README 为准。
可以先用一个明确的数据划分,对比热门推荐、邻域协同过滤和矩阵分解,再分析误差来自哪些用户或物品。进一步可读PU Learning,理解为什么未点击不自动等于负例。
相关文章
- 机器学习平台设计:让实验能够交付2026-11-06
- 【机器学习与数据科学之旅】B2 《算法与数据中台》读书笔记2020-12-07
- 【机器学习与数据科学之旅】B1 《深入理解 AutoML 和 AutoDL》读书笔记2020-10-28
- 【机器学习与数据科学之旅】1 Numpy 实例指南2020-06-16