基于场景的新闻分析分享
本页目录
- 2018 年12月29日 周六下午2:10,
- 分享人:毛可智教授
分享题目:Situation Awareness based on News Analytics
报告人简介:
毛可智,新加坡南洋理工大学电气与电子工程学院副教授。1998年在英国谢菲尔德大学(University of Sheffield)获博士学位,自1998年4月任教于新加坡南洋理工大学。其主要研究领域:机器学习,文本分析,自然语言处理和信息融合,在这些研究方向拥有20多年的经验,并在这些领域发表了约100篇科学论文,成功地为政府机构和各行业开发并提供了多种智能系统和工具。
方向:机器学习、自然语言处理、图像处理、信息融合、认知科学
在做的项目
- intelligent Information Manager for Target Recognition
- 知识图谱自动构建
- Cognitive Fusion and Sense Making of Heterogeneous Sensor Networks
- Situation Awareness Based on News Analytic 新闻分析,了解事件,预测事件发展
- Social Media Analytics for Social Resilience 通过社交媒体分析,了解社会的韧性,比如是否能够承受巨大的灾难变故(这个项目非常有趣,我也很感兴趣)
- Text-aided Image Classification
- Harvest Loss and Damage Information of Natural Disasters from News
Situation Awareness Based on News Analytic
Situation Awareness 了解周围发生什么事情的能力,主要用于军事,有三个组件
- Level1 Perception 感知
- Level2 Comprehension 理解
- Level3 Projection
最终转化为 决策 和 行动。被认为是成功决策的基础,广泛应用于军事、应急响应、交通和健康。
从硬性的传感器转化为软性的传感器。全世界的新闻相当于不同的传感器,我们可以通过这些新闻来了解到底发生了什么。
系统框架:News -> Event Detection(Fake News Detection, Event Signal Detection, Event Signals Fusion) -> Event Information Extraction(Soft Facts Extraction 比如情感, Hard Facts Extraction, Event Data Repository) -> Event Modeling and Forecasting(Visualization, Data Stream Information, Modeling and Forecasting)
前置条件是知识图谱的构建与信息的提取。
系统特性:
- Adaptive and Fast Response 快速响应
- Acquiring training data from open sources 自动获取相关的数据
- Automatic labelling of training data 自动打标签,通过 wikipedia
- Wikipedia 的 infobox 可以作为结构
- Fusion of data and open knowledge 融合,充分利用公开信息
- Open source knowledge
- Flexible and multi-way fusion of data and knowledge
- End-to-End System
- Automatic scanning of the Internet
- Event status and forecasting as the outcome
模块功能
- News Scanning 新闻抓取
- 每个小时扫描
- 30 多个新闻机构
- 多语言(英文,马来语,印度尼西亚语)
- 通过 RSS feeds(经常更新,包含干净链接)
- 也通过抓取网站
- Event Classification 事件分类,只关注坏事,这部分内容保险公司会关注
- Earthquake Typhoon Flood 传染病 Riot暴乱 Terror Attack 恐袭 Others
- 多分类训练 - 有监督
- 聚类 - 发现事件个数
- Event Recognition 事件识别
- 可能一天有多起地震,需要区分开
- Information Extraction
- 从网上抽取属性,比如死亡个数,受伤个数,武器等等
- 针对不同的属性建立不同的特征分类器
- 自动抽取、自动标签
问题和解决方案
问题一:Inadequate sampling of the negative class
正样本只占一小部分,负样本的比较稀疏,采样不足够,忽视了负样本的重要性
问题二:Open-boundary classifiers
开放边界的分类器,比如 Linear classifiers, Neural network + softmax, KNN, Decision-tree 容易使 negative class 也分布在我们关注的分类中(因为负样本很稀疏,分布广泛,不容易区分,也不被注意)
尽量要对负样本分类,覆盖尽可能多的类别,就会有很大的帮助
解法:建立闭合边界的分类器,比如 One-Class SVM,Learn representation with compact distribution,比如 CNN
数据集
以下数值来自当时听讲记录,缺少完整实验设置,不能用于与其他模型直接比较。
关注的类别,非关注的类别有 25 类,来覆盖负样本(这样能有效提高准确率)
- 恐怖袭击,文章数目 832
- 疾病,579
- 地震,511
- 洪水
- 暴乱
常规方法:MLP+Softmax(77%), CNN+Softmax(79%), MLP+1-SVM(69%), CNN+1-SVM(89%)
他们的方法:93%
Fusion of Knowledge and Data 数据与知识融合
- Experiences = Data
- Teacher = Knowledge(Visit Domain Expert, Use open source knowledge)
- 人的感知模型:Soar Cognitive Architecture。
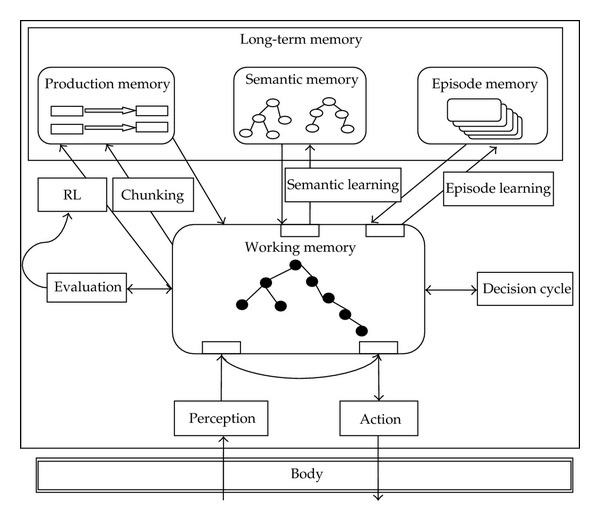
机器学习需要结合数据与知识,需要确定的:
- 用什么知识 Causal words
- 从哪里搞到这个知识 FrameNet WordNet
- 如何与数据结合 Knowledge-Data Integrative CNN: Knowledge-driven CNN + Data-driven CNN,训练的时候只对 Data-driven 的部分进行学习更新(小规模)
Word Embedding -> Input Representation -> CNN Model
FrameNet - Causal Frames - Causal Words - WordNet - Extended Causal words - Knowledge Embedding(知识库的表达)
- Knowledge-driven CNN 是通用的,泛化能力好
- Data-driven CNN 关注训练数据,保证在训练集的领域上表现好,因为规模不大,所以参数比较好,也更不容易过拟合
结论
开源工具降低了 AI 的门槛,but optimal performance needs dedication
- Open-boundary classifiers
- Inadequate sampling of negative class
AI 仍旧处于早期阶段,认知科学是通向高级 AI 的必需品
- Data + knowledge framework is a human way of learning
- It is worthy of further exploration
- 机器通过知识学知识很难
相关文章
- 机器学习平台设计:让实验能够交付2026-11-06
- 【机器学习与数据科学之旅】1 Numpy 实例指南2020-06-16
- 【机器学习与数据科学之旅】2 Pandas 实例指南2020-06-16
- KBP2017 实体发现与链接比赛分享2018-05-09