Fast Unfolding:用模块度发现社群
本页目录
更新历史
- 2018.09.16:完成初稿
在社交网络中,用户相当于每一个点,用户之间通过互相的关注关系构成了整个网络的结构,在这样的网络中,有的用户之间的连接较为紧密,有的用户之间的连接关系较为稀疏,在这样的网络中,连接较为紧密的部分可以被看成一个社区,其内部的节点之间有较为紧密的连接,而在两个社区间则相对连接较为稀疏,这便称为社团结构。
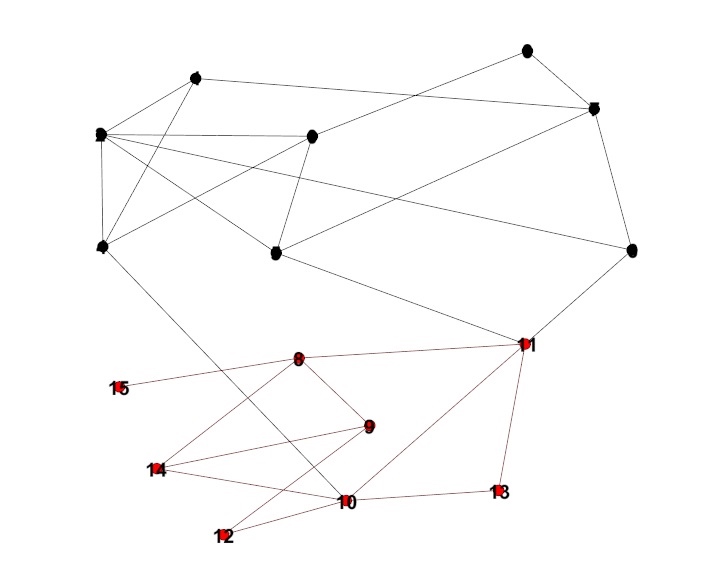
用红色的点和黑色的点对其进行标注,整个网络被划分成了两个部分,其中,这两个部分的内部连接较为紧密,而这两个社区之间的连接则较为稀疏。如何去划分上述的社区便称为社区划分的问题。
在社区划分问题中,存在着很多的算法,如由Girvan 和 Newman提出的GN算法,标签传播算法(Label Propagation Algorithm, LPA),这些算法都能一定程度的解决社区划分的问题,但是性能则是各不相同。总的来说,在社区划分中,可以从凝聚与分裂两类经典思路理解,此外还有标签传播等方法
- 凝聚方法(agglomerative method):添加边
- 分裂方法(divisive method):移除边
在后续的文章中,我们会继续关注不同的社区划分的算法,在这篇文章中,主要关注Fast Unfolding算法。
社区划分的目标是使得划分后的社区内部的连接较为紧密,而在社区之间的连接较为稀疏,通过模块度可以刻画这样的划分的优劣,模块度越大,则社区划分的效果越好 ,模块度的公式如下所示:
其中
- 表示的是网络中的所有权重
- 表示的是节点 i 和节点 j 之间的权重
- 是与顶点 i 连接的边的权重
- 表示的是顶点被分配到的社区
- 用于判断顶点 i 与顶点 j 是否被划分在同一个社区中,若是,则返回1,否则,返回0
上述的模块度的计算可以得到以下的简化形式:
其中
- 表示社区 c 内部边权的两倍(按邻接矩阵求和的约定)
- 是社区 c 内节点的加权度之和;内部边计两次、连接外部的边计一次。
模块度(modularity)指的是网络中连接社区结构内部顶点的边所占的比例,减去在同样的社团结构下任意连接这两个节点的比例的期望值。
模块度成为度量社区划分优劣的重要标准,划分后的网络模块度值越大,说明社区划分的效果越好,Fast Unfolding算法便是基于模块度对社区划分的算法,Fast Unfolding算法是一种迭代的算法,主要目标是不断划分社区使得划分后的整个网络的模块度不断增大。
Fast Unfolding算法主要包括两个阶段,如下图所示
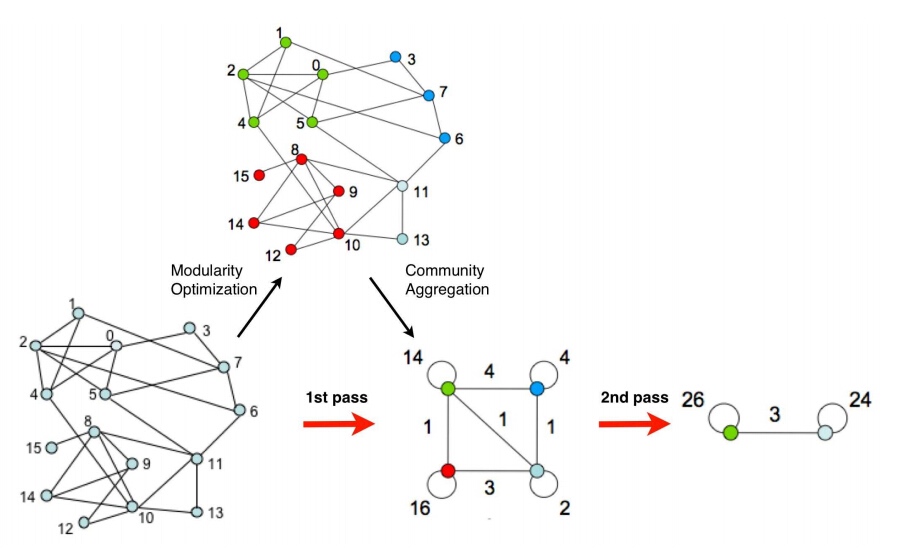
第一阶段称为Modularity Optimization,主要是将每个节点划分到与其邻接的节点所在的社区中,以使得模块度的值不断变大;第二阶段称为Community Aggregation,主要是将第一步划分出来的社区聚合成为一个点,即根据上一步生成的社区结构重新构造网络。重复以上的过程,直到网络中的结构不再改变为止。
具体的算法过程如下所示:
- 初始化,将每个点划分在不同的社区中;
- 对每个节点,将每个点尝试划分到与其邻接的点所在的社区中,计算此时的模块度,比较所有候选移动的模块度增益,选择正增益最大的移动;没有正增益则保持不动;
- 重复以上的过程,直到不能再增大模块度为止;
- 构造新图,新图中的每个点代表的是步骤3中划出来的每个社区,继续执行步骤2和步骤3,直到社区的结构不再改变为止。
注意:节点访问顺序可能影响最终划分和模块度。该算法进行贪心优化,不保证全局最优;模块度也有分辨率限制,不能把较高分数直接等同于唯一正确的社群划分。
参考链接
原始论文:Blondel 等,Fast unfolding of communities in large networks(2008)。该方法通常称为 Louvain 方法。
相关文章
- 机器学习平台设计:让实验能够交付2026-11-06
- 【机器学习与数据科学之旅】B2 《算法与数据中台》读书笔记2020-12-07
- 【机器学习与数据科学之旅】B1 《深入理解 AutoML 和 AutoDL》读书笔记2020-10-28
- 【机器学习与数据科学之旅】1 Numpy 实例指南2020-06-16