随机森林与孤立森林:预测和异常检测
本页目录
随机森林与孤立森林都由多棵树组成,但它们解决的问题和构造树的方法不同。本文合并整理 2018 年 9 月 16 日的两份学习笔记。
随机森林:用多棵树做预测
随机森林,指的是利用多棵树对样本进行训练并预测的一种集成学习方法,可用于分类与回归。该分类器最早由Leo Breiman和Adele Cutler提出,并被注册成了商标。简单来说,随机森林就是由多棵CART(Classification And Regression Tree)构成的。对于每棵树,它们使用的训练集是从总的训练集中有放回采样出来的,这意味着,总的训练集中的有些样本可能多次出现在一棵树的训练集中,也可能从未出现在一棵树的训练集中。在训练每棵树的节点时,使用的特征是从所有特征中按照一定比例随机地无放回的抽取的。每个节点考虑多少特征是可调参数,需用验证数据选择。
因此,随机森林的训练过程可以总结如下:
- 给定训练集S,测试集T,特征维数F。确定参数:使用到的CART的数量t,每棵树的深度d,每个节点使用到的特征数量f,终止条件:节点上最少样本数s,节点上最少的信息增益m。对于第1-t棵树,i=1-t:
- 从S中有放回的抽取大小和S一样的训练集S(i),作为根节点的样本,从根节点开始训练
- 如果当前节点上达到终止条件,则设置当前节点为叶子节点,如果是分类问题,该叶子节点的预测输出为当前节点样本集合中数量最多的那一类c(j),概率p为c(j)占当前样本集的比例;如果是回归问题,预测输出为当前节点样本集各个样本值的平均值。然后继续训练其他节点。如果当前节点没有达到终止条件,则从F维特征中无放回的随机选取f维特征。利用这f维特征,寻找分类效果最好的一维特征k及其阈值th,当前节点上样本第k维特征小于th的样本被划分到左节点,其余的被划分到右节点。继续训练其他节点。有关分类效果的评判标准在后面会讲。
- 重复(2)(3)直到所有节点都训练过了或者被标记为叶子节点。
- 重复(2),(3),(4)直到所有CART都被训练过。
利用随机森林的预测过程如下:
对于第1-t棵树,i=1-t:
- 从当前树的根节点开始,根据当前节点的阈值th,判断是进入左节点(<th)还是进入右节点(>=th),直到到达,某个叶子节点,并输出预测值
- 重复执行(1)直到所有t棵树都输出了预测值。如果是分类问题,则输出为所有树中预测概率总和最大的那一个类,即对每个c(j)的p进行累计;如果是回归问题,则输出为所有树的输出的平均值。
注:有关分类效果的评判标准,因为使用的是CART,因此使用的也是CART的评判标准,与 ID3、C4.5 的常见划分准则不同。
对于分类问题(将某个样本划分到某一类),也就是离散变量问题,CART使用Gini值作为评判标准。定义为Gini=1-∑(P(i)*P(i)),P(i)为当前节点上数据集中第i类样本的比例。例如:分为2类,当前节点上有100个样本,属于第一类的样本有70个,属于第二类的样本有30个,则Gini=1-0.7×0.7-0.3×0.3=0.42,可以看出,类别分布越平均,Gini值越大,类分布越不均匀,Gini值越小。在寻找最佳的分类特征和阈值时,评判标准为:最大化加权不纯度下降 ,即寻找最佳的特征f和阈值th,使得当前节点的Gini值减去按样本数加权的左右子节点 Gini 值后,差值最大。
一个简单的描述, 设有N个样本,M个变量(维度)个数,该算法具体流程如下:
- 确定一个值m,它用来表示每个树分类器选取多少个变量。(注意这也是随机的体现之一)
- 从数据集中有放回的抽取 k 个样本集,用它们创建 k 个树分类器。另外还伴随生成了 k 个袋外数据,用来后面做检测。
- 输入待分类样本之后,每个树分类器都会对它进行分类,然后所有分类器按照少数服从多数原则,确定分类结果。
性能制约
- 单棵树的预测能力和树之间的误差相关性共同影响集成效果,树更深不保证泛化更好。
- 随机采样与特征子集有助于降低树之间的相关性。
重要参数
- 预选变量个数 (即框架流程中的m);
- 随机森林中树的个数。
这两个参数的调优非常关键,尤其是在做分类或回归的时候。
孤立森林:用随机切分找异常
孤立森林(Isolation Forest)是另外一种高效的异常检测算法,它和随机森林类似,但每次选择划分属性和划分点(值)时都是随机的,而不是根据信息增益或者基尼指数来选择。在建树过程中,如果一些样本很快就到达了叶子节点(即叶子到根的距离d很短),那么就被认为很有可能是异常点。因为那些路径d比较短的样本,往往更少见,且在特征取值上更容易被随机切分隔离;这并不等价于离全局中心更远。也就是说,可以通过计算样本在所有树中的平均路径长度来寻找异常点。
sklearn提供了ensemble.IsolationForest模块可用于Isolation Forest算法。
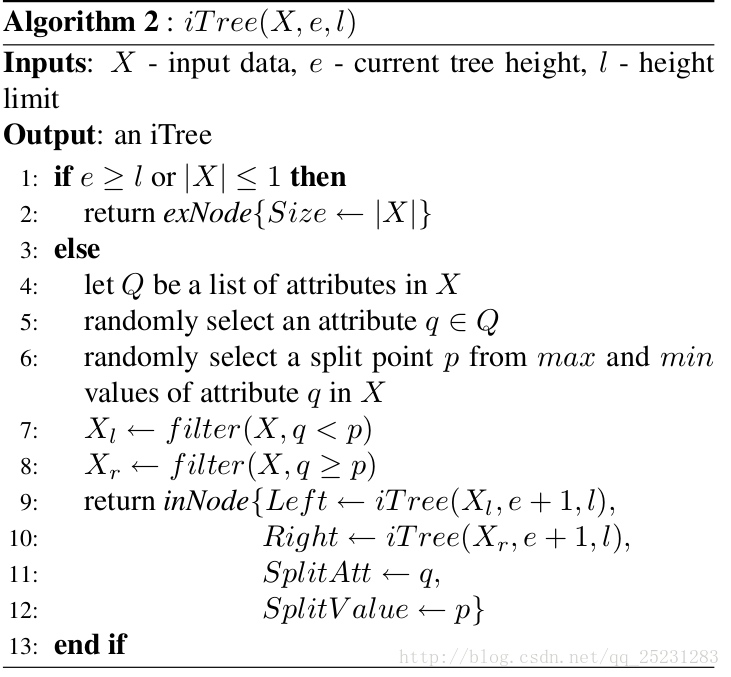
主要参数包括树的数量 n_estimators、每棵树的样本数量 max_samples 和特征数量 max_features。contamination 用于确定异常判定阈值,可指定预期异常比例或使用 'auto',不应把旧版本的默认值当作固定标准。完整参数见 scikit-learn 官方 API。
函数
- fit(X) - Fit estimator.(无监督)
- predict(X) - 返回值:+1 表示正常样本, -1表示异常样本。
- decision_function(X) - 返回样本的异常评分。 值越小表示越有可能是异常样本。
参考链接
怎么选择
有目标标签、需要分类或回归时,可以考虑随机森林;没有异常标签、需要寻找容易被隔离的样本时,可以考虑孤立森林。异常分数并不等于业务上的欺诈概率,仍需结合样本复查和业务代价确定阈值。
相关文章
- 机器学习平台设计:让实验能够交付2026-11-06
- 【机器学习与数据科学之旅】B2 《算法与数据中台》读书笔记2020-12-07
- 【机器学习与数据科学之旅】B1 《深入理解 AutoML 和 AutoDL》读书笔记2020-10-28
- 【机器学习与数据科学之旅】1 Numpy 实例指南2020-06-16