深入理解计算机系统 第 4 课 Machine Basics
本页目录
从这一讲开始,我们接触到更多机器相关的内容,这次要说的是基础知识,为之后更深入讲解打下基础。
Intel 处理器简史
这一讲的部分内容在我之前上过的 18640 Foundation of Computer Architecture 中也有涉及,但是重点不同,这里会结合这两门课的内容做一个简单的介绍。
首先介绍的就是处理器,作为计算机的大脑,虽然有很多种,这里只介绍 Intel x86 架构的处理器。课堂上介绍了 Intel 处理器的大致发展历史和特点,我简要说明一下。
作为统治笔记本桌面电脑服务器市场的处理器,x86 处理器是一个一直在进化的产品,甚至兼容 1978年的 8086 的指令集。值得注意的是,x86 采用的是 Complex instruction set computer(CISC),之所以称为复杂指令,是因为有许许多多不同格式的不同指令(对应的是 RISC)
整个 Intel x86 的发展史很长,这里提几个关键的时间节点和对应产品:
- 1978 年:8086,第一个 16 位处理器,主要为 IBM PC 和 DOS 设计,有 1MB 的地址空间
- 1985 年:386,第一个 32 位 Intel 处理器(IA32),添加了 flat addressing,使得可以运行 Unix
- 2004 年:Pentium 4E,第一个 64 位 Intel 处理器(x86-64)
- 2006 年:Core 2,第一个 多核 Intel 处理器
- 2008 年:Core i7,四核(也就是我们做实验用的机器)
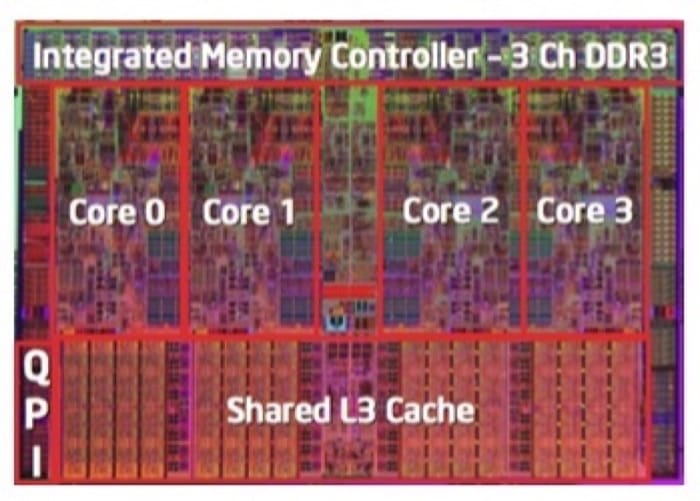
随着时代和科技的发展,除了最基本的运算指令集,还有一些其他的特性:
- 增加了支持多媒体操作处理的指令
- 启用了更加高效的执行条件操作的指令
- 从 32 位迁移的 64 位
- 更多的运算核心
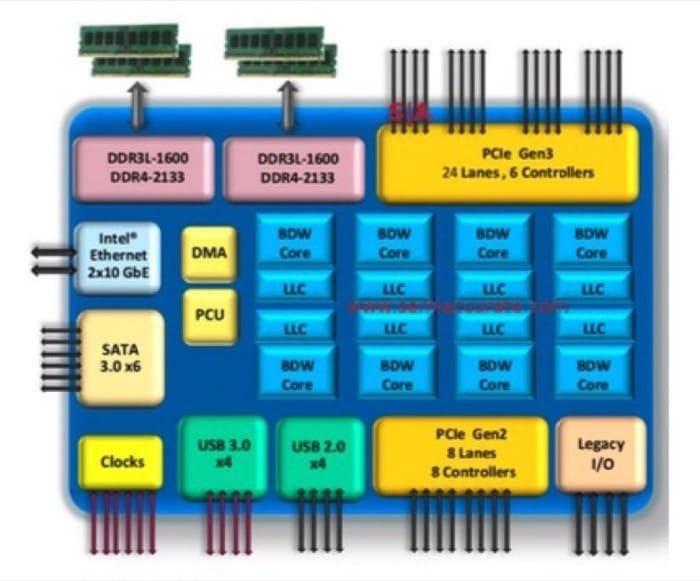
一个另外的趋势是集成,比如说 2015 年的 Core i7 Broadwell,可以从下图看到处理器芯片中加入了原来主板才有的许多部件,如 PCIe, SATA, DDR3 等等。
顺带说一下千年老二 AMD,主打性价比,研发的 Opteron 系列是 Pentium 4 的强劲对手,并且开发了自己的 64 位拓展 x86-64。但是近年来 Intel 重新找回厂子,AMD 开始打酱油。
Intel 在 64 位处理器的发展并不算顺风顺水,2001 年本打算使用全新的架构快速从 IA32 转换到 IA64,但是糟糕的性能反倒给了 AMD 机会。后者在 2003 年发布的 x86-64(现在叫 AMD64) 架构明显更厉害,搞得 Intel 疲于应战,最后在 2004 年搞出来一个叫 EM64T 的东西,其实几乎和 AMD64 一样。现在除了某些低端的处理器,几乎都支持 x86-64,这也是这门课主要要讲的内容。
C 语言,汇编和机器代码
先介绍一些定义:
Architecture: (also ISA, instruction set architecture) The parts of a processor design that one needs to understand or write assembly/machine code. (Examples: instruction set specification, registers)
Microarchitecture: Implementation of the architecture. (Examples: cache sizes and core frequency)
- Code Forms:
- Machine Code: The byte-level programs that a processor executes
- Assembly Code: A text prepresentation of machine code
- Example ISAs:
- Intel: x86, IA32, Itanium, x86-64
- ARM: Used in almost all mobile phones
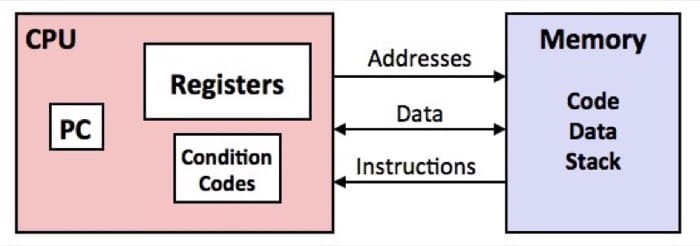
现在简单介绍下几个比较重要的部分:
- PC: Program counter,里面存着下一条指令的地址,在 x86-64 中称为 RIP
- Register: 寄存器,用来存储数据以便操作
- Codition codes: 条件代码,通常保存最近的算术或逻辑操作的信息,用来做条件跳转
- Memory: 内存,有地址数组,代码和用户数据,以及栈
我们知道机器只能执行机器代码,我们写的 C 语言代码是如何成为机器代码的呢?可以参见下图:
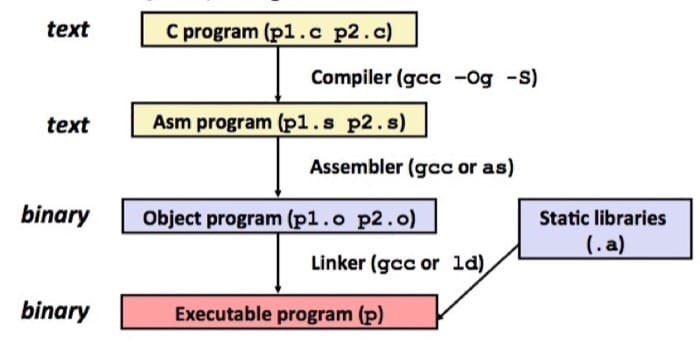
这里的 -Og -S 是编译器的参数,意思是进行不那么优化的优化(这样我们才能看得懂编译出来的汇编语言)以及汇编完输出汇编结果。
我们有如左图所示的代码,使用命令 gcc -Og -S sum.c 就可以产生 sum.s 文件,我们来对比看一下。(注意不同的平台不同的编译器不同的参数会有不同的结果,和下图可能差别很大)
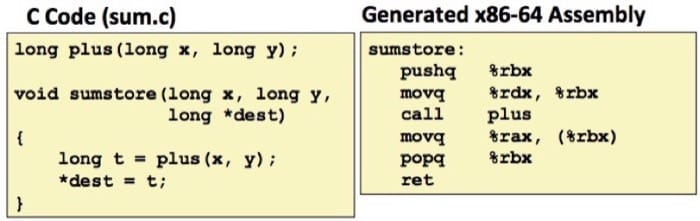
这里先不展开讲每条指令是做什么的,先来说说汇编语言的数据类型
- 整型:有 1,2,4,8 个字节,可以存数据,也可以存地址(地址是无类型的指针)
- 浮点数:有 4,8,10 个字节,和整型分不同的寄存器
- 代码:由一系列指令编码而成的字节序列
- 注意,是没有类似数组和结构体这种组合的,这些其实都只是在内存中连续分配的字节
能够执行的操作也很有限:
- 对寄存器或者内存中的数据执行算术运算
- 在内存和寄存器之间传输数据
- 传输控制(非条件跳转和条件分支)
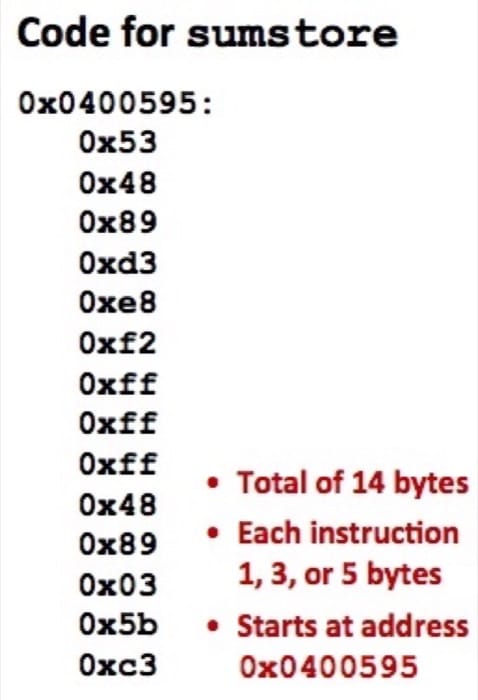
汇编器会把 .s 文件转换成 .o,把每条指令转换成二进制代码,基本上就是可以执行的代码了,除了不同文件的连接之外。
连接器会把不同文件之间的引用处理好,顺带也会吧静态库给连接进去(例如 malloc printf 的代码),注意,有些代码是动态连接的,也就是在执行时才连接,这样就可以减少一些编译出来的文件大小。
举个例子
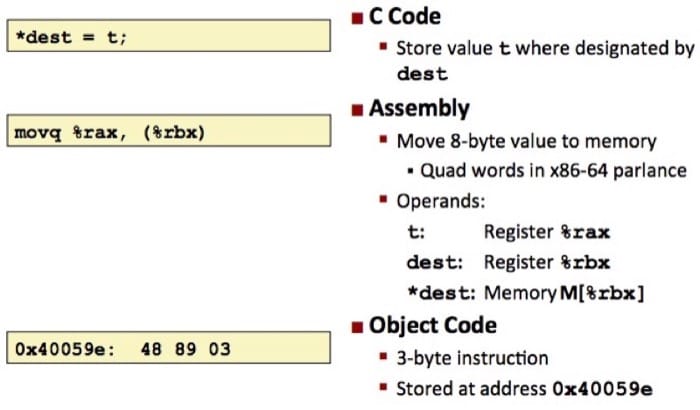
除了汇编,还可以反汇编,objdum -d sum 比如:
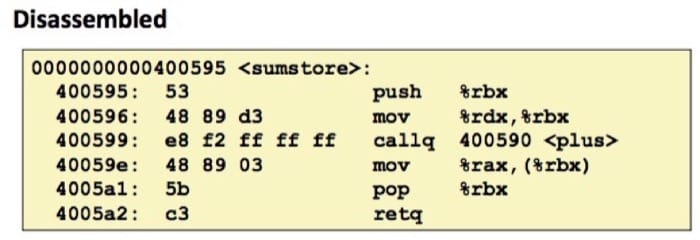
反汇编有什么用呢:
- 检查代码
- 分析指令的结构模式
- 生成近似的汇编代码
- 可以对
a.out或者.o文件进行反汇编 - 注意,有些软件的用户协议里说明是不能反编译的,例如:windows
汇编基础
先来看看 x86-64 的整型寄存器
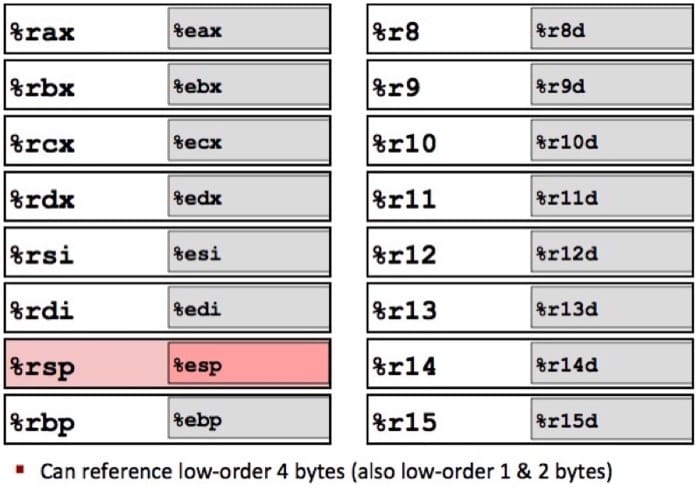
发现其实大的里面还包含小的(灰色部分),为什么呢?看看 IA32 的架构就明白了
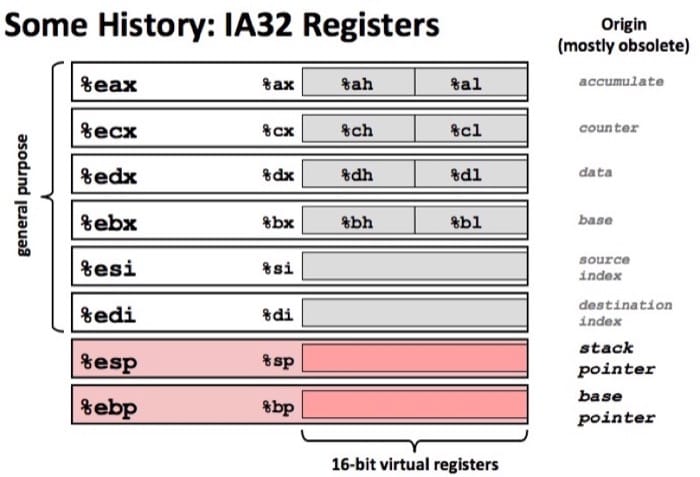
发现没有?%rsp 里面包含 %esp,%esp 里面又包含 %sp,这样就保证了可以从 64 位兼容 32 位再到最初的 16 位,是不是很精妙的设计?
移动数据
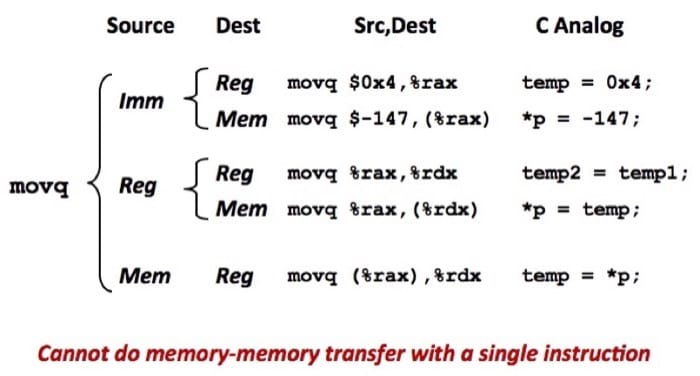
操作数主要有三种类型,一种是立即数,也就是直接给的一个数字,第二种是寄存器,第三种是内存
寻址
普通模式,(R),相当于 Mem[Reg[R]],也就是说寄存器 R 指定内存地址,类似于 C 语言中的指针,语法为:movq (%rcx), %rax 也就是说以 %rcx 寄存器中存储的地址去内存里找对应的数据,存到寄存器 %rax 中
移位模式,D(R),相当于 Mem[Reg[R]+D],寄存器 R 给出起始的内存地址,然后 D 是偏移量,语法为:movq 8(%rbp),%rdx 也就是说以 %rbp 寄存器中存储的地址再加上 8 个偏移量去内存里找对应的数据,存到寄存器 %rdx 中
举个交换两个数字的例子
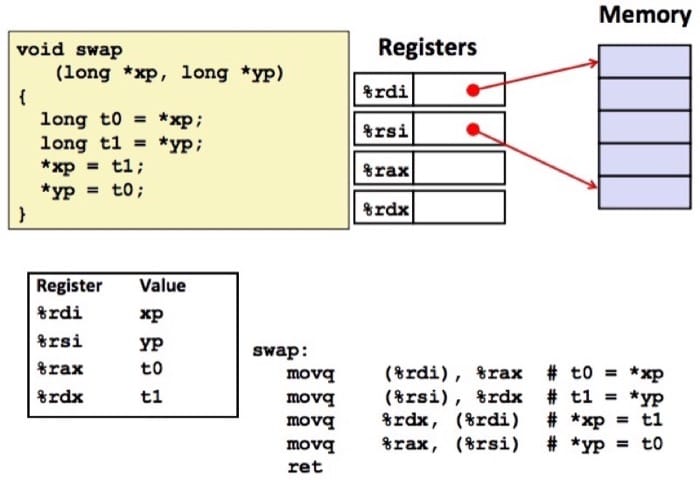
前面的两种属于简单模式,完整的更通用的模式是这样的:
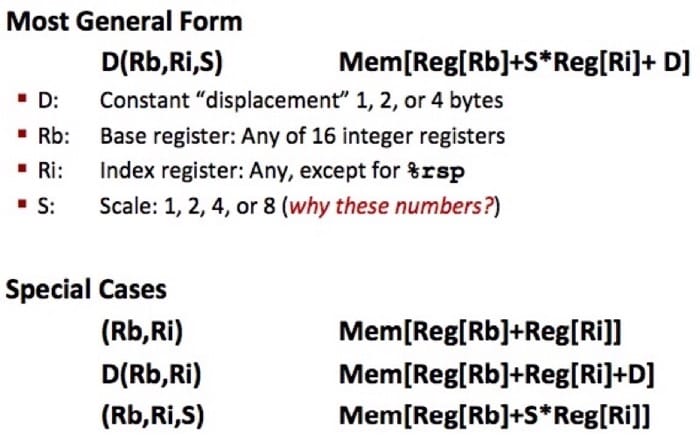
举个例子:%rdx 的存着的地址是 0xf000;%rcx 的存着的地址是 0x0100,那么有:
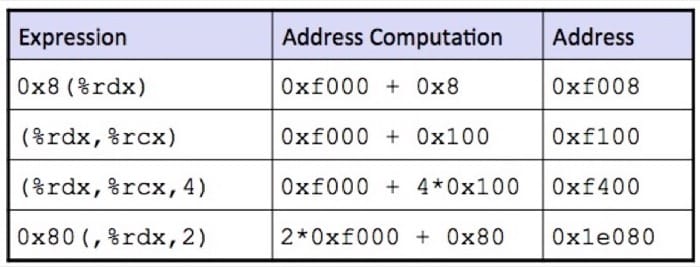
算术运算与逻辑运算
一条比较重要的指令是 leaq Src, Dst,其中 Src 是地址的表达式,然后把计算的值存入 Dst 指定的寄存器,也就是说,无须内存引用就可以计算,类似于 p = &x[i];
举个例子:
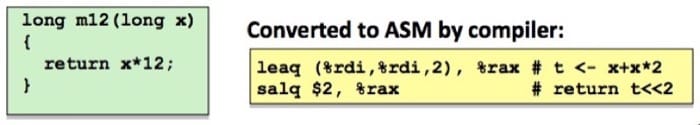
可以看到是直接对 %rdi 寄存器中存的地址所对应的内存里的数据进行操作。
一些常见的算术运算指令如下,注意参数的顺序,而且对于有符号和无符号数都是一样的:
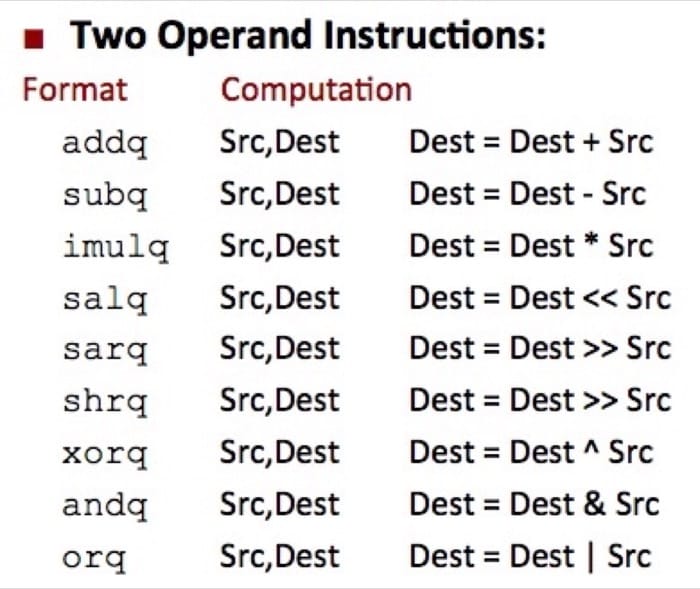
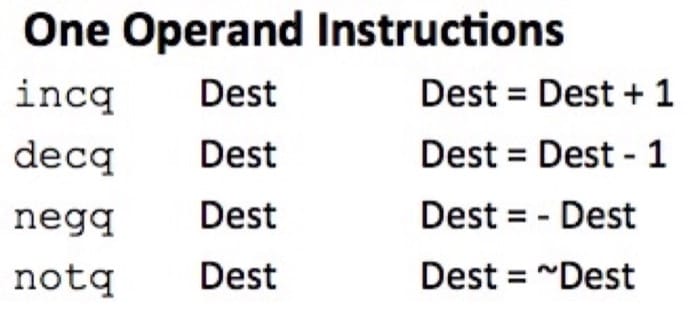
更多的信息可以参考书籍和对应的文档。
再来看一个例子:
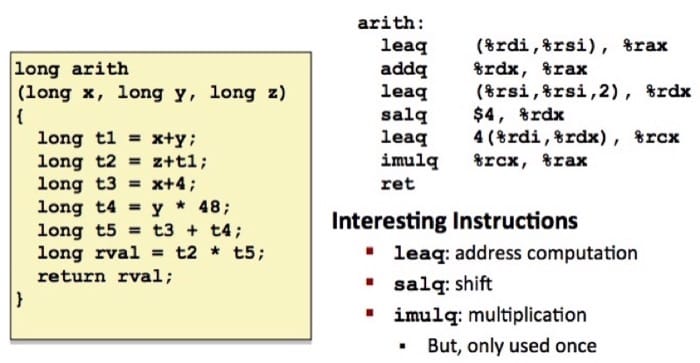
对应的语句和寄存器的值如下(确保弄明白整个过程):
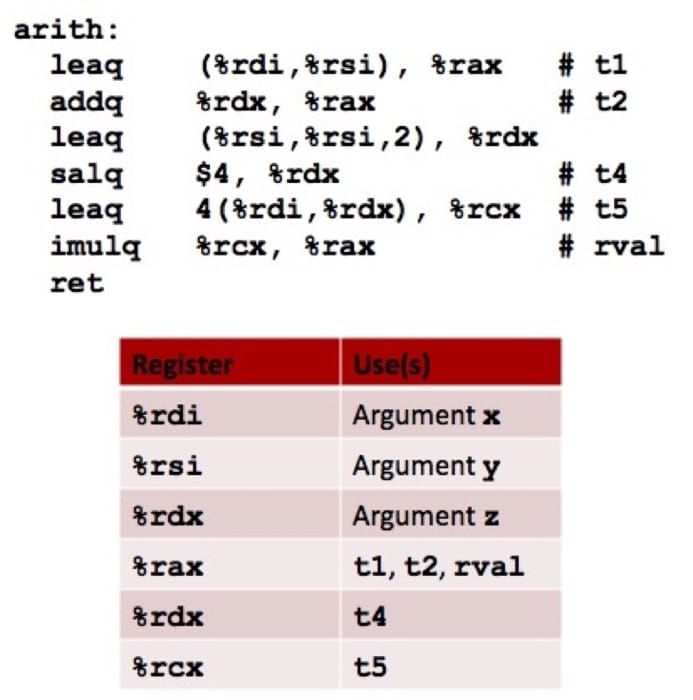
这一讲的内容到这里就这么多,其实还是需要比较多基础知识才好理解,尤其是汇编这部分,可以去网上找一下可视化的寄存器及内存数据交换过程看看,增加了解。