深入理解计算机系统 第 3 课 Floating Point
本页目录
了解了数据在内存中的基本存储形式,同时也知道了整型的表达方法,这一讲我们来看看另一大类别的数字——浮点数——是如何在计算机中表示的。
二进制浮点数的表示,其实和我们日常生活中常见的十进制的方式是一致的,都是相当于每一位的系数,乘以每一位的数值,然后把结果加起来,如下图所示:
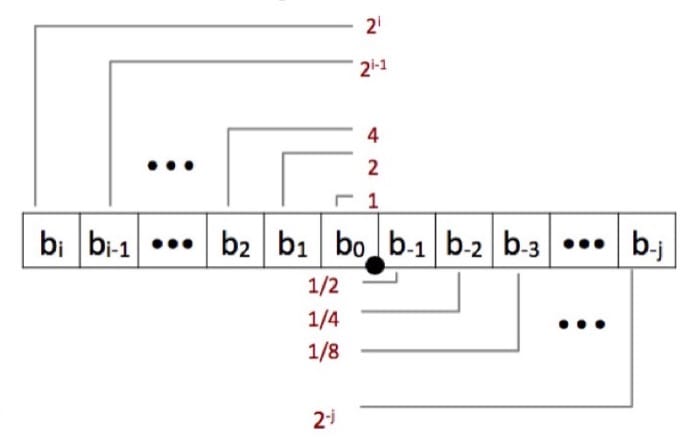
所以我们其实可以用一个统一的公式来表达:
例如
可以看到除以二就相当于右移,并且可以横跨小数点。注意 非常接近于 1,因为
通常用 来表示这个值。
细心的同学就会发现,这种表达方式其实是比较明显的限制的,比如说,只有形为 的小数部分可以被精确表示,其他的数字会变成循环的小数,例如:。
除此之外,另一个问题在于,如果给定了 w 个比特,能够表达的数字其实是有限的。
IEEE Floating Point
实话说,这个标准更多是从数值角度来建立的,对于舍入,上溢出和下溢出都有比较好的处理方法,但与此同时,给硬件优化带来了比较大的困难。从理解的角度来看,也不够直观,但是好在主流的 CPU 都支持浮点数,所以我们不必过多涉及这方面的细节,但是了解定义本身还是很重要的。
我们用下面的公式来表达浮点数:
其中 s 是符号位,决定正负;M 通常是一个值在 [1.0, 2.0) 的小数;E 是次方数。具体编码的时候是这样的:
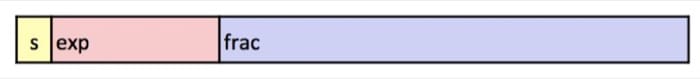
其中 s 对应着符号位,exp 对应着 E(注意,不一定等于 E,因为位数限制表达能力有限),frac 对应着 M(注意,不一定等于 M,因为位数限制表达能力有限)。
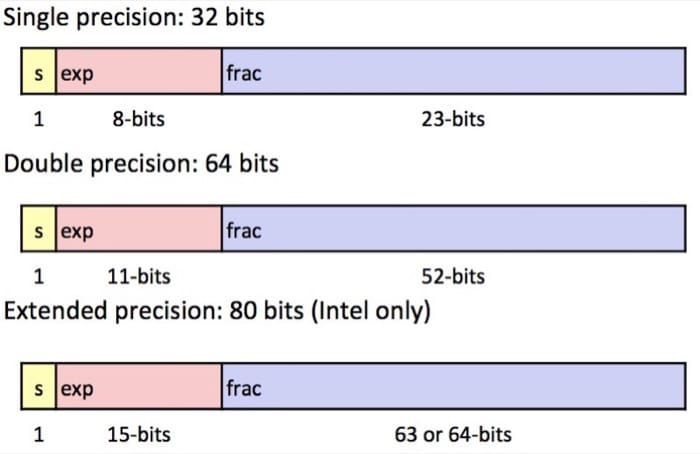
不同的位数就代表了不同的表示能力,也就是单精度,双精度,扩展精度的来源,具体的位数表示如下:
Normalized Values
在 和 时,表示的其实都是规范化的值,为什么说是规范化呢?这里只需要大概知道因为实数轴上原来连续的值会被规范到有限的定值上并且这些定值之间的间距也是不一样的,具体可以通过后面给出的例子来理解(所以现在不明白也不用担心)
这里的 E 是一个偏移的值 ,其中
- Exp: 是 exp 编码区域的无符号数值
- Bias:值为 的偏移量,其中 k 是 exp 编码的位数,也就是说
- 单精度:127(Exp: 1...254, E: -126...127)
- 双精度:1023(Exp: 1...2046, E: -1022...1023)
之所以需要采用一个偏移量,是为了保证 exp 编码只需要以无符号数来处理。
而对于 M,一定是以 1 开头的:也就是 。其中 xxx 的部分就是 frac 的编码部分,当 frac=000.00 的时候值最小(),当 frac=111。。。1 的时候值最大(),也就是说开头的 1 是『免费附送的』,并不需要实际的编码位。
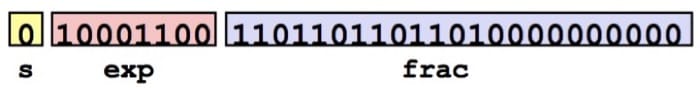
举个例子,float F = 15213.0;,那么
于是 frac 部分的值就是小数点后面的数值,而 Exp = E + Bias = 13 + 127 = 140 = ,于是编码出来的浮点数是这样的:
Denormalized Values
当 的时候,值是非规范化的,意思是,虽然实数轴上原来连续的值会被规范到有限的定值上,但是并些定值之间的间距也是一样的,具体可以通过后面给出的例子来理解(所以现在不明白也不用担心)
和前面不同的是
而且 ,不是以 1 开头了。
当 exp=000...0 且 frac = 000...0 时,表示 0,而且因为符号位的缘故,实际上是有 +0 和 -0 两种的。
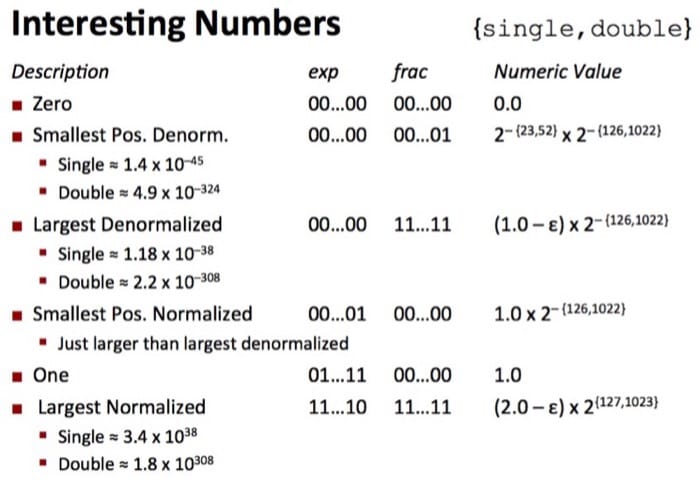
而在 exp=000..0 且 时,数值是接近 0 的,并且间距是一致的
Special Values
还有一种特殊情况,就是 时,表示一些特殊值。
当 exp=111...1 且 frac = 000...0 时,表示 ,而且因为符号位的缘故,实际上是有 和 两种的。那些会溢出的操作就会用这个来表示,比如
而在 exp=111...1 且 时,我们认为这不是一个数值(Not-a-Number,NaN),用来表示那些没办法确定的值,比如
小结
可能通过文字描述还是不够清晰,我们来看看上面各种情况对应到数轴中是怎么样的:
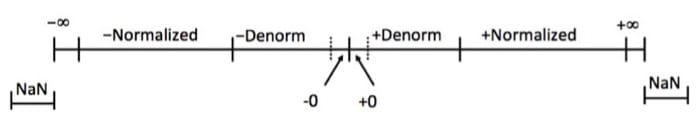 (对应理解一下上面所说的内容)
接下来举一个实际的例子,我们的编码形式是这样的:
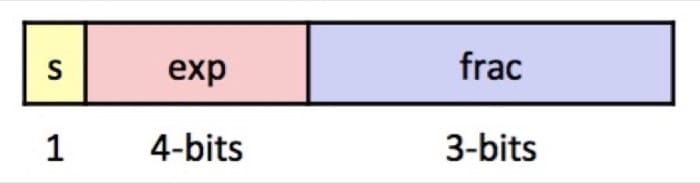
简单起见,我们用 8 个 bit 来做演示,exp 部分是 4 位,所以 bias=7,后三位用来编码小数。下面列出正数部分的表格:
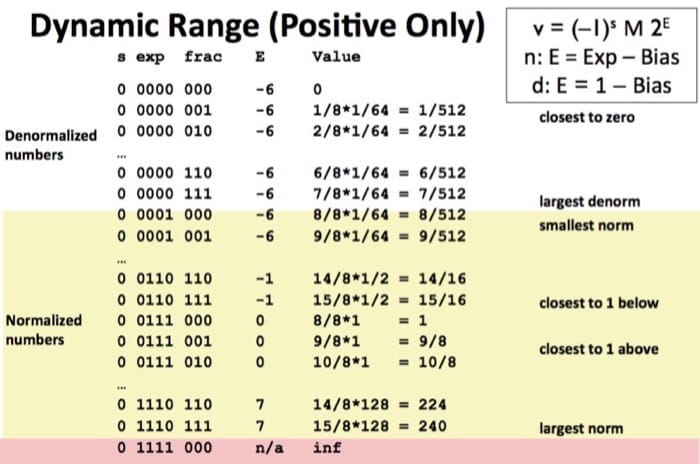
观察上表,我们可以发现如下一些比较有意思的规律:
- 在 exp=0000 时,也就是 denorm 的情况,间距是一致的,都是 1/8
- 因为位数的限制,从零到一之间的数字只能以 1/8 为最小单位来表示,且相邻数字间间距一样
- 在 norm 的部分,可以发现由于 exp 部分的不同,所以相邻数字间的间隔也是不同的,比方说最接近 1 的数字是 15/16 和 9/8,分别相差 1/16 和 1/8,这也是由于 IEEE 浮点数表示法的公式决定的
从上面的例子大概了解了值的范围,我们再缩小一点,用 6-bit,来看看具体数值的分布
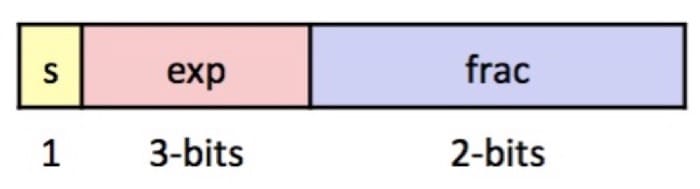
这里因为 exp 有 3 位,所以 Bias = 3,分布如下
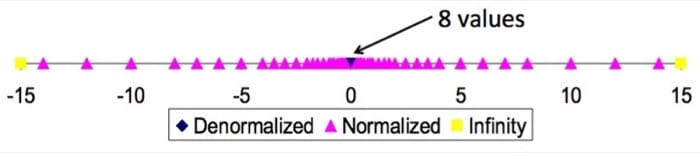
拉近一点(主要是 0 附近)
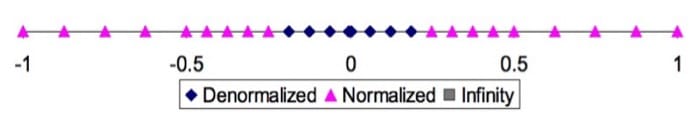
总结起来,IEEE 编码有以下一些需要注意的性质
- 浮点数的 0 和整型的 0 一样,所有位都是 0
- 可以使用无符号整型的比较方法来比较大小
- 必须先比较符号位
- 必须考虑 -0=0 的情况
- 注意 NaN 的情况
- 其他时候都是没有问题的
Rounding
对于浮点数的加法和乘法来说,基本的思路如下:
- 先计算出准确值
- 然后转换到合适的精度
- 可能会溢出
- 可能需要舍入来满足 frac 的精度
舍入的方式有很多种,举个例子:
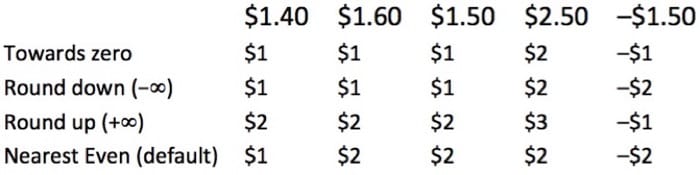
舍入到最近的偶数比较特别,中心思想是:舍入之后最右边的值要是偶数,从下面一个例子就可以明白:
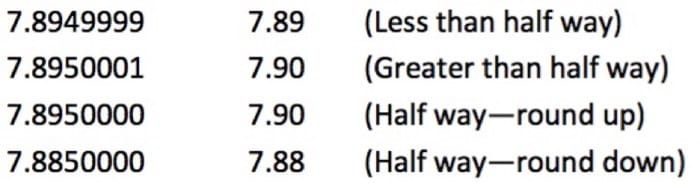
对于二进制数也是类似的
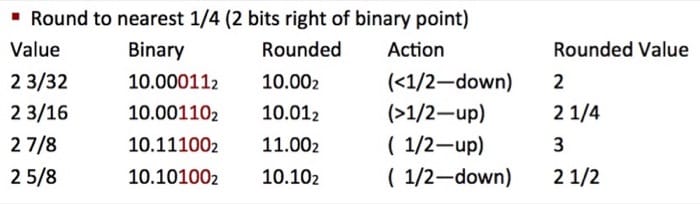
浮点数乘法
结果是 ,其中 s= s1 ^ s2, M = M1 * M2, E = E1 + E2
- 如果 M 大于等于 2,那么把 M 右移,并增加 E 的值。
- 如果 E 超出了可以表示的范围,溢出
- 把 M 舍入到 frac 的精度
基本性质
- 相乘可能产生 infinity 或者 NaN
- 满足交换率
- 不满足结合律(因为舍入会造成精度损失)
- 乘以 1 等于原来的数
- 不满足分配率
1e20*(1e20-1e20)=0.0但1e20*1e20-1e20*1e20=NaN - 除了 infinity 和 NaN,满足单调性,即
浮点数加法
,这里假设 E1 > E2
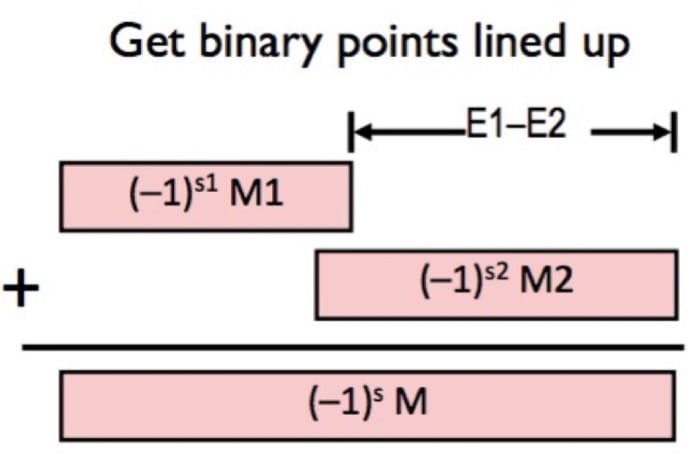
结果是 ,其中 s= s1 ^ s2, M = M1 + M2, E = E1
- 如果 M 大于等于 2,那么把 M 右移,并增加 E 的值
- 如果 M 小于 1,把 M 左移 k 位,E 减少 k
- 如果 E 超出了可以表示的范围,溢出
- 把 M 舍入到 frac 的精度
基本性质
- 相加可能产生 infinity 或者 NaN
- 满足交换率
- 不满足结合律(因为舍入会造成精度损失,如
3.14+1e10)-1e10=0,但3.14+(1e10-1e10)=3.14) - 加上 0 等于原来的数
- 除了 infinity 和 NaN,每个元素都有对应的倒数
- 除了 infinity 和 NaN,满足单调性,即
C 语言中的浮点数
保证两种精度:float(单精度),double(双精度)
在 int, float, double 间转换会改变其 bit
- double/float 到 int
- 去掉小数部分
- 类似与向 0 舍入
- 当值是 NaN 时没有定义,一般来说会设置为 TMin
- int 到 double
- 精确转换,只要 int 的字长不超过 53 bit
- int 到 float
- 可能需要舍入
Puzzles
声明下面变量
int x = ...;
float f = ...;
double d = ...;
判断下面的表达式是否正确
x == (int)(float)x错误,可能会损失精度,因为 float 的位数不足以表达所有可能的 intx == (int)(double)x正确,int 到 double 是精确转换f == (float)(double)f正确d == (double)(float)d错误,可能会损失精度f == -(-f)正确,只是改变符号位2/3 == 2/3.0错误,前面会舍入到 0,后面是一个小数d < 0.0推出(d*2) < 0.0正确,即使溢出,也是负无穷d > f推出-f > -d正确d * d >= 0.0正确(d+f)-d == f错误,可能会因为舍入损失精度
总结
- IEEE 浮点数有明确的数学性质
- 使用 的形式来表达数值
- 操作实际上是与实现方式无关的,因为需要满足同样的数学规律,具体怎么实现不重要
- 和实际的数学有一些不同
- 不满足结合律和分配率
- 给编译器和需要高精度的运算程序带来了很大困扰
相关文章
- 深入理解计算机系统 第 25 课 Thread-Level Parallelism2016-04-08
- 深入理解计算机系统 第 26 课 Future of Computing2016-04-08
- 深入理解计算机系统 第 27 课 总结2016-04-08
- 深入理解计算机系统 第 23 课 Synchronization - Basics2016-04-07