深入理解计算机系统 第 2 课 Bits, Bytes 和 Integers
本页目录
这一部分的内容比较多,所以分了两节课来讲,为了保证内容的一致性和连贯性,这里把两讲合为一讲。主要介绍的是基本的计算性质以及计算机如何表示数字和地址,对之后理解指针有很大的帮助。
Representing information as bits
研究问题有两种方法,一种是自顶向下,另一种是自底向上。对于设计来说,很多时候是自顶向下的,从一个整体想法出发,然后慢慢细化;而在学习化学的时候,往往是自底向上的,比方说先去了解组成元素的基本粒子,然后在这些粒子的基础上进行更加抽象的研究。从这个角度看,学习计算机系统,自底向上可能是一个好的方向。
在计算机中,我们看到的一切,归根到底,都是 bits,每个 bit 不是 0 就是 1。计算机就是通过对 bits 进行不同方式的编码和描述,来完成执行不同的任务。那么问题来了,为什么是 bits 而不是其他呢?这就要从模拟电路讲起,一言以蔽之就是,bit 这种描述方式很好存储,并且在有噪声或者传输不那么准确的情况下,也能保持比较高的可靠度(电压值有一定的容错范围)。
在这样的物理基础上,计算机就是一个二进制系统(当然也有八进制和十六进制,不过其实是二进制的方便描述形式),这里简单列一个表格,就比较清楚了:
| Hex | Decimal | Binary | Hex | Decimal | Binary |
|---|---|---|---|---|---|
| 0 | 0 | 0000 | 8 | 8 | 1000 |
| 1 | 1 | 0001 | 9 | 9 | 1001 |
| 2 | 2 | 0010 | A | 10 | 1010 |
| 3 | 3 | 0011 | B | 11 | 1011 |
| 4 | 4 | 0100 | C | 12 | 1100 |
| 5 | 5 | 0101 | D | 13 | 1101 |
| 6 | 6 | 0110 | E | 14 | 1110 |
| 7 | 7 | 0111 | F | 15 | 1111 |
Bit-level manipulations
首先我们需要了解布尔代数(Boolean Algebra)的基本知识,非常简单,只有四个操作:
- 与 And:
A=1且B=1时,A&B = 1 - 或 Or:
A=1或B=1时,A|B = 1 - 非 Not:
A=1时,~A=0;A=0时,~A=1 - 异或 Exclusive-Or(Xor):
A=1或B=1时,A^B = 1;A=1且B=1时,A^B = 0
布尔运算也可以看做是集合操作,举个例子:
集合 A
01101001 {0, 3, 5, 6}
76543210
集合 B
01010101 {0, 2, 4, 6}
76543210
那么不同的布尔运算就代表:
&交集 Intersection01000001{0, 6}|并集 Union01111101{0, 2, 3, 4, 5, 6}^差集 Symmetric difference00111100{2, 3, 4, 5}~补集 Complement10101010{1, 3, 5, 7}
以上这四种运算 C 语言都支持,只要是『数值型』即可:long, int, short, char, unsigned。每个参数都会被看做是位向量。
注意要与逻辑操作符区分开来:&&, ||, !,在这里会把 0 作为 false,非 0 作为 true,并且只可能返回 0 或 1 的一个,通常可以用于 early termination(多个条件判断情况)
一个有用的例子:p && *p,可以避免空指针访问。
接下来是左移或者右移操作。左移比较简单,在右边补 0 即可。右移的话有两种类型,一种是逻辑右移(左边补 0),另一种是算术右移(左边补 1)。为什么会有这两种,因为对应无符号数和有符号数的运算,有符号数的最高位(最左边)是符号位在负数的时候需要进行算术右移。
注意:不支持小于 0 或者大于 word size 的操作。
Integers
Representation: unsigned and signed
针对有符号数和无符号数,有两种不同的形式,这里的 w 表示 word size:
- 无符号数:
- 有符号数:
在 C 语言中 short 是 2 字节长度的,并且最高位是符号位,0 表示非负数,1 表示负数
short int x = 15213;
short int y = -15213;
对应下表
| \ | Decimal | Hex | Binary |
|---|---|---|---|
| x | 15213 | 3B 6D | 00111011 01101101 |
| y | -15213 | C4 93 | 11000100 10010011 |
为了方便讲解,下面定义几个常量,这里 w 是 word size:
- UMin = 0 即 000...0
- UMax = 即 111...1
Two's Complement 值
- TMin = 即 100...0
- TMax = 即 011...1
其他值
- Minus 1 即 111...1
对于 word size w=16,有
| \ | Decimal | Hex | Binary |
|---|---|---|---|
| UMax | 65535 | FF FF | 11111111 11111111 |
| TMax | 32767 | 7F FF | 01111111 11111111 |
| TMin | -32768 | 80 00 | 10000000 00000000 |
| -1 | -1 | FF FF | 11111111 11111111 |
| 0 | 0 | 00 00 | 00000000 00000000 |
对于不同的 word size,数值也会有很大的变化
| w | 8 | 16 | 32 | 64 |
|---|---|---|---|---|
| UMax | 255 | 65,535 | 4,294,967,295 | 18,446,744,073,709,551,615 |
| TMax | 127 | 32,767 | 2,147,483,647 | 9,223,372,036,854,775,807 |
| TMin | -128 | -32,768 | -2,147,483,648 | -9223,372,036,854,775,808 |
观察可以得知两个很重要的特性
- |TMin| = TMax + 1 (范围并不是对称的)
- UMax = 2*TMax + 1
有符号数和无符号数在非负数的编码是一样的,每一个数字的编码是唯一的,这两者可以互换:
Conversion, casting
有符号数和无符号数的区别其实就在于最高位是表示正还是负,下图就很清晰地描述了这种转换
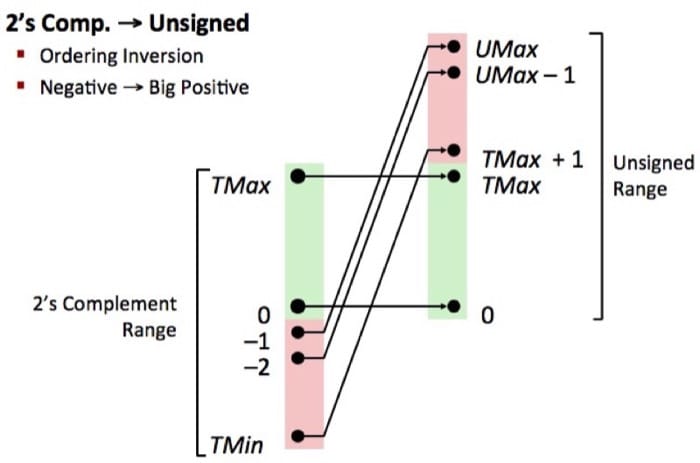
在 C 语言中,默认是有符号数。无符号数的话需要在数字后面加 U: 0U, 4294967259U。
进行类型转换的时候,有一些规则:
- 如果一个表达式中包含有符号数和无符号数,那么有符号数会被隐式转换成无符号数
- 包括比较运算:
<,>,==,<=,>=
下面用字长 w = 32 为例,这里 TMin = -2,147,483,648 TMax = 2,147,483,647
| 常量 1 | 常量 2 | 关系 | 比较对象 |
|---|---|---|---|
| 0 | 0U | == | unsigned |
| -1 | 0 | < | signed |
| -1 | 0U | > | unsigned |
| 2147483647 | -2147483647-1 | > | signed |
| 2147483647U | -2147483647-1 | < | unsigned |
| -1 | -2 | > | signed |
| (unsigned)-1 | -2 | > | unsigned |
| 2147483647 | 2147483648U | < | unsigned |
| 2147483647 | (int)2147483648U | > | signed |
总结一下,在进行有符号和无符号数的互相转换时:
- 具体的 bit 不会改变
- 但是计算机解释的方式变化
- 可能会导致预期外的结果:加或减 (w 是 word size)
- 如果一个表达式既包含有符号也包含无符号数,那么会被隐式转换成无符号数
Expanding, truncating
有的时候我们需要扩展一个变量的位数,比如说从 32 位扩展到 64 位。更通用一点的话,给定一个 w 位的有符号整数 x,要把它转换成 w+k 位的整数(保持值不变),只需要在左边添加 k 个与符号位相同的数值即可,如下图:
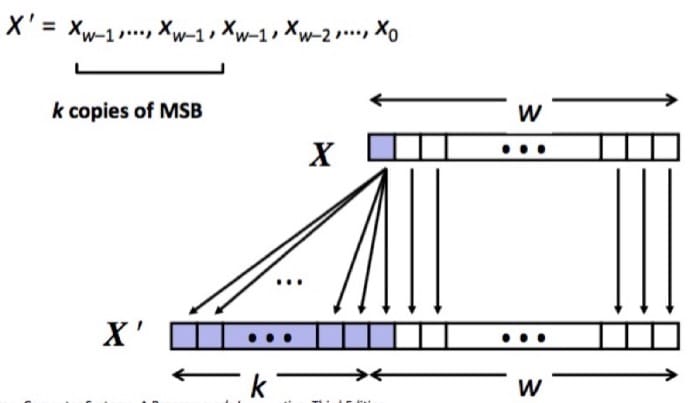
举个例子
short int x = 15213;
int ix = (int) x;
short int y = -15213;
int iy = (int) y;
C 语言会自动做符号拓展,把小的数据类型转换成大的,如下表所示
| \ | Decimal | Hex | Binary |
|---|---|---|---|
| x | 15213 | 3B 6D | 00111011 01101101 |
| ix | 15213 | 00 00 3B 6D | 00000000 00000000 00111011 01101101 |
| y | -15213 | C4 93 | 11000100 10010011 |
| iy | -15213 | FF FF C4 93 | 11111111 11111111 11000100 10010011 |
总结一下
- 扩展(例如从
short int到int)- 无符号数:加 0
- 有符号数:加符号位
- 都可以得到预期的结果
- 截取(例如
unsigned到unsigned short)- 均会截取
- 无符号数:mod 操作
- 有符号数:近似 mod 操作
- 对于小的数字可以得到预期的结果
Addiction, negation, multiplication, shifting
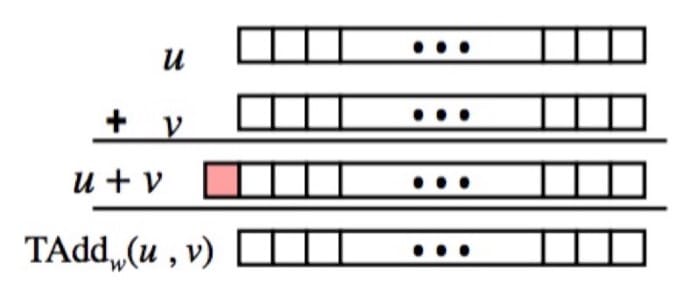
对于无符号加法,操作数是 w 位的话,真实的结果是 w+1 位的,但是会丢弃掉第 w 位,实际上就是做了一个 mod 操作(),如下图所示
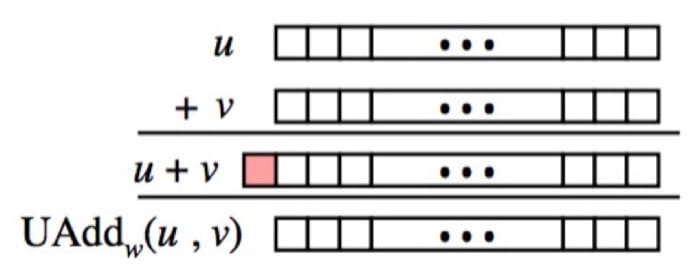
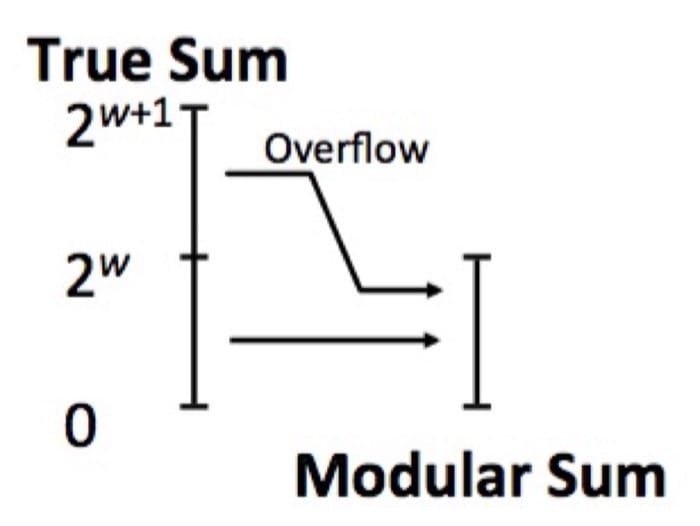
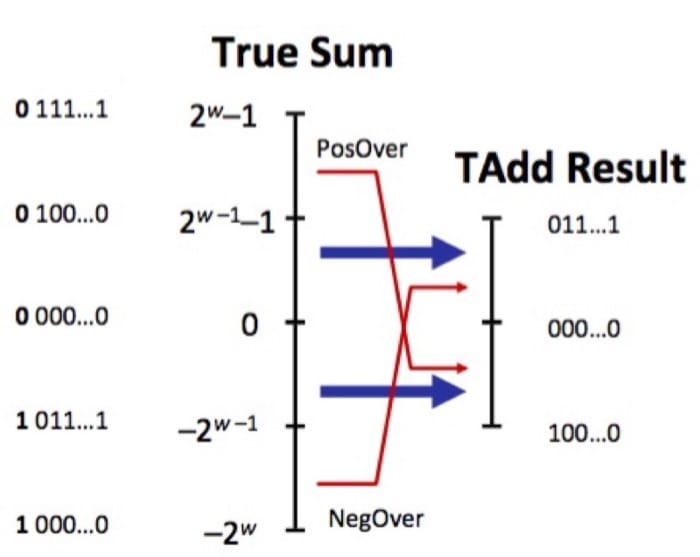
对于有符号的加法(Two's Complement Addition),操作过程和无符号加法一样,只是解释的时候会有不同,因此会得到 positive overflow 和 negative overflow 两种,如下图所示:
对于乘法来说,值的范围会大很多,这里分情况讨论一下,假设两个乘数是 x,y 并且都是 w 位的:
- 无符号数:至多 2w 位
- 范围
- 有符号数,最小的负数:至多 2w - 1 位
- 范围
- 有符号数,最大的正数:至多 2w 位,只有 一种情况
- 范围
如果需要保证精度,就需要用软件来实现了。
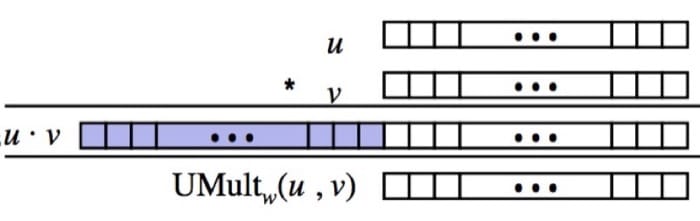
计算的无符号乘法的时候,会忽略最高的 w 位,相当于
有符号数以及左移右移比较类似,这里略过。
Summary
这里有一个问题,就是使用无符号数有些情况很容易导致错误,举两个例子:
// 例1
unsigned i;
for (i = cnt-2; i >= 0; i--)
	a[i] += a[i+1];

// 例2
#define DELTA sizeof(int)
int i;
for (i = cnt; i-DELTA >= 0; i-= DELTA)
	...
在上面这两个情况下,循环都不会停止,因为无符号数永远非负。如果一定要用无符号数来做循环计数,那么应该用下面的形式:
unsigned i;
for (i = cnt - 2; i < cnt; i--)
a[i] += a[i+1]在这里:0-1 -> UMax
或者更好的方式是
size_t i;
for (i = cnt - 2; i < cnt; i--)
	a[i] += a[i+1]
这样就可以适应不同的字长。
还有一些情况使用无符号数比较好:
- 执行 Modular Arithmetic 的时候
- 用 bits 来表示集合的时候,会使用逻辑右移,保证一致性
Representations in memory, pointers, strings
一些基本概念
- 程序通过地址来引用数据
- 概念上可以当作是一个非常大的字节数组
- 实际上并不是,但是这么认为也是可以的
- 一个地址相当于是这个数组的索引
- 一个指针变量存储的是一个地址
- 系统会给每个进程提供私有的地址空间
- 可以把进程看作是正在被执行的程序
- 一个程序可以访问自己的数据,但是不能访问别人的数据
- 每台计算机都有一个字长 word size
- 通常来说是一个整型数据的长度(同时也是地址的长度)
- 之前大部分机器用 32 位(4 字节)作为字长,这也限制了寻址空间,最多是 4GB(字节)
- 现在的机器采用 64 位字长,理论上来说支持 18EB(exabytes) 寻址空间,也就是
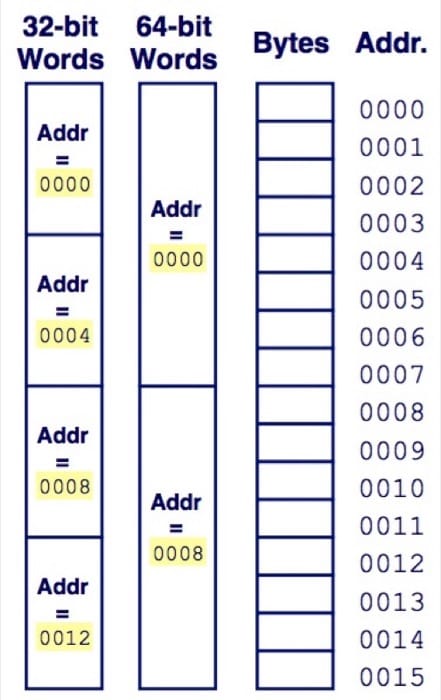
内存中地址是连续的,根据字长的不同,有不同的间隔:
下面是一些常见的数据表示,单位是 byte
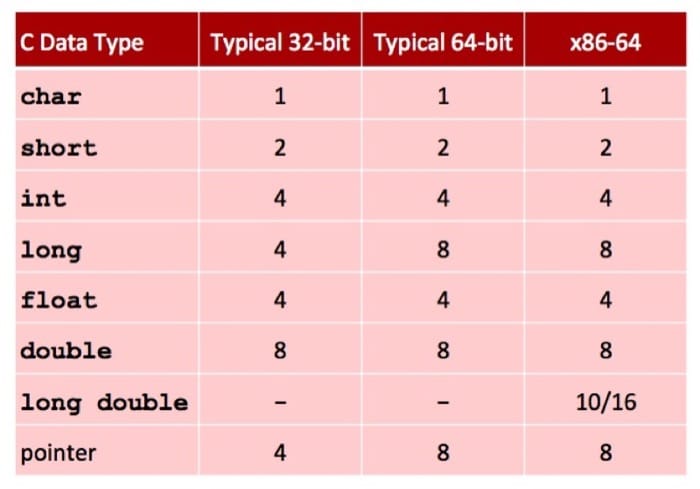
字节在内存中用两种排列顺序:
- Big Endian: Sun, PPC Mac, Internet
- Least significant byte has highest address
- Little Endian: x86, ARM processors
- Least significant byte has lowest address
举个例子,假如变量 x 是 4 字节,值为 0x01234567。用 &x 索引的地址是 0x100
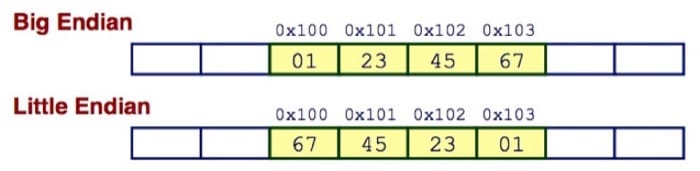
如何检查数据的表示呢,可以用下面的代码
typedef unsigned char *pointer;

void show_bytes(pointer start, size_t len) {
	size_t i;
	for (i = 0; i < len; i++)
		printf("%p\t0x%.2x\n", start+i, start[i]);
	printf("\n");
}
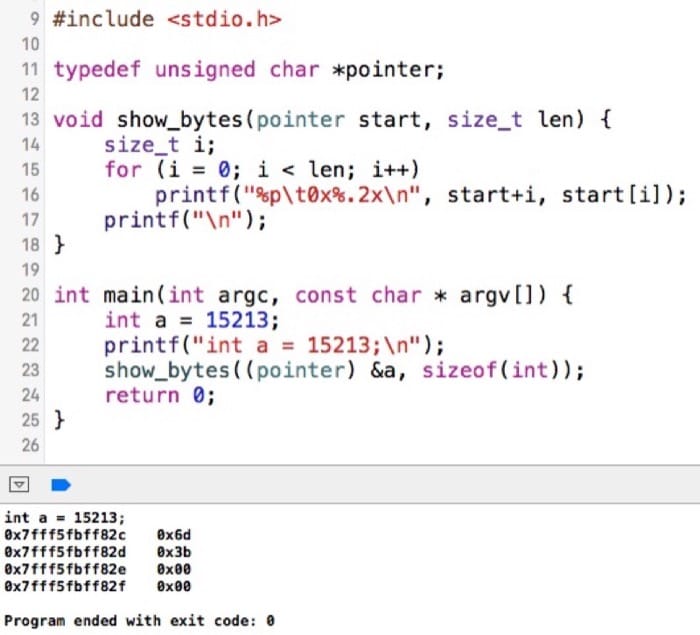
这里 %p 用来输出指针,%x 用来输出 16 进制数据。执行可用:
int a = 15213;
printf("int a = 15213;\n");
show_bytes((pointer) &a, sizeof(int));
在我的电脑上,测试如下:
C 语言中表示字符串只要记得最后会加一个 0 即可,例如:char S[6]="15213";
额外内容
老师在课上还给出了一些题目,这里也列出来供大家思考。
初始化条件
int x = foo();
int y = bar();
unsigned ux = x;
unsigned uy = y;
判断下面的式子是否成立:
x < 0 -> (x*2) < 0不成立,TMin 就是一个反例ux >= 0成立x & 7 == 7 -> (x << 30) < 0成立ux > -1不成立,因为 -1 会被转为无符号数,就变成最大的无符号数,ux 无论如何不能大于它x > y -> -x > -y不成立,TMin 就是一个反例x * x >= 0不成立,只要溢出一点点就会变成负数x > 0 && y > 0 -> x + y > 0不成立,理由同上x >= 0 -> -x <= 0成立x <= 0 -> -x >= 0不成立,因为负数比正数多一个(x|-x) >> 31 == -1不成立,当 x 等于 0 的时候,但是其他时候都是成立的ux >> 3 == ux / 8成立,不受符号位影响x >> 3 == x / 8不成立,受符号位影响x & (x-1) != 0不成立,2的次幂都是反例
另外介绍一些代码安全问题,举个例子,在 FreeBSD 的 getpeername 函数例,大概是如下类似的实现:
/* Kernel memory region holding user-accessible data */
#define KSIZE 1024
char kbuf[KSIZE];

/* Copy at most maxlen bytes from kernel region to user buffer */
int copy_from_kernel(void *user_dest, int maxlen) {
	/* Byte count len is minimum of buffer size of maxlen */
	int len = KSIZE < maxlen ? KSIZE : maxlen;
	memcpy(user_dest, kbuf, len);
	return len;
}
通常的用法是
#define MSIZE 528

char mybuf[MSIZE];
copy_from_kernel(mybuf, MSIZE);
但是可以通过这个函数访问到内存的其他部分,例如
#define MSIZE 528

char mybuf[MSIZE];
copy_from_kernel(mybuf, -MSIZE);
通过这个负号,就可以访问指定位置之前的内存数据了,这很可能导致出问题。
相关文章
- 深入理解计算机系统 第 25 课 Thread-Level Parallelism2016-04-08
- 深入理解计算机系统 第 26 课 Future of Computing2016-04-08
- 深入理解计算机系统 第 27 课 总结2016-04-08
- 深入理解计算机系统 第 23 课 Synchronization - Basics2016-04-07