深入理解计算机系统 第 5 课 Machine Control
本页目录
上一讲我们了解了关于机器代码,汇编和 CPU 相关的基础知识,这一讲要来说一下具体机器是怎么实现代码中常见的流程控制的。这一部分涉及的代码和思路稍微有些不容易理解,我会尽量写得详细一些。
我们先来回顾一下 x86-64 处理器中不同的寄存器,这一部分很重要,务必要弄明白:
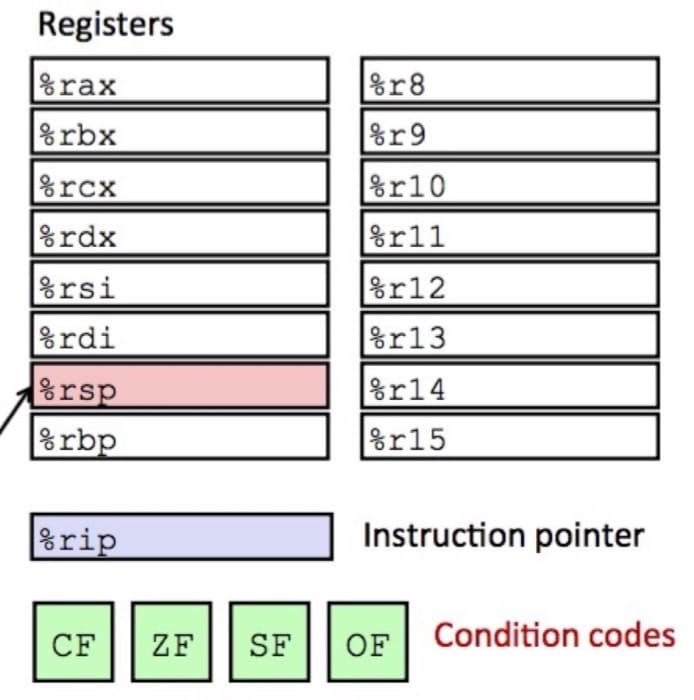
首先要理解的是,寄存器中存储着当前正在执行的程序的相关信息:
- 临时数据存放在 (%rax, ...)
- 运行时栈的地址存储在 (%rsp) 中
- 目前的代码控制点存储在 (%rip, ...) 中
- 目前测试的状态放在 CF, ZF, SF, OF 中
Condition Codes
最后的四个寄存器(CF, ZF, SF, OF)就是用来辅助程序的流程控制的,意思是:
- CF: Carry Flag (for unsigned)
- ZF: Zero Flag
- SF: Sign Flag (for signed)
- OF: Overflow Flag (for signed)
可以看到以上这四个寄存器,表示四种不同的状态,举个例子,假如我们有一条诸如 t = a + b 的语句,汇编之后假设用的是 addq Src, Dest,那么根据这个操作结果的不同,会相应设置上面提到的四个寄存器,而因为这个是执行类似操作时顺带尽心设置的,称为隐式设置,例如:
- 如果两个数相加,在最高位还需要进位(也就是溢出了),那么 CF 寄存器就会被设置
- 如果 t 等于 0,那么 ZF 寄存器会被设置
- 如果 t 小于 0,那么 SF 寄存器会被设置
- 如果 2's complement 溢出,那么 OF 寄存器会被设置为 1(溢出的情况是
(a>0 && b > 0 && t <0) || (a<0 && b<0 && t>=0))
这就发现了,其实这四个条件代码,是用来标记上一条命令的结果的各种可能的,是自动会进行设置的。注意,使用 leaq 指令的话不会进行设置。
除了隐形设置,还可以显式进行设置,具体的方法是使用 cmpq 指令,这里的 q 指的是 64 位的地址。具体来说 cmpq Src2(b), Src1(a) 等同于计算 a-b(注意 a b 顺序是颠倒的),然后利用 a-b 的结果来对应进行条件代码的设置:
- 如果在最高位还需要进位(也就是溢出了),那么 CF 寄存器就会被设置
- a 和 b 相等时,也就是
a-b等于零时,ZF 寄存器会被设置 - 如果 a < b,也就是
(a-b)<0时,那么 SF 寄存器会被设置 - 如果 2's complement 溢出,那么 OF 寄存器会被设置(溢出的情况是
(a>0 && b > 0 && t <0) || (a<0 && b<0 && t>=0))
另一种进行显式设置的方法是使用 testq 指令,具体来说 testq Src2(b), Src1(a) 等同于计算 a&b(注意 a b 顺序是颠倒的),然后利用 a-b 的结果来对应进行条件代码的设置,通常来说会把其中一个操作数作为 mask:
- 当
a&b == 0时,ZF 寄存器会被设置 - 当
a&b < 0时,SF 寄存器会被设置
有了这四个条件码,就可以通过不同的组合方式,来产生不同的条件判断,例如:
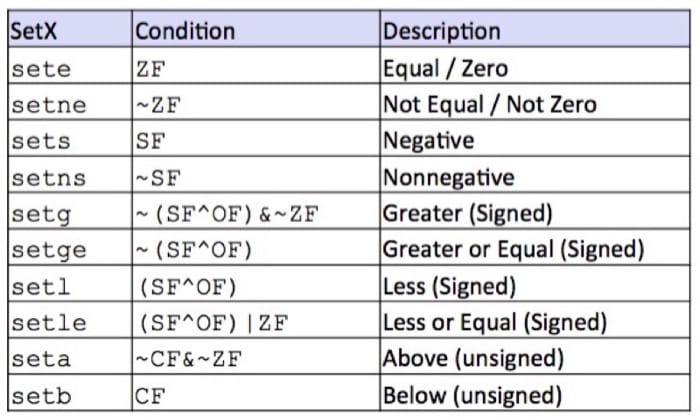
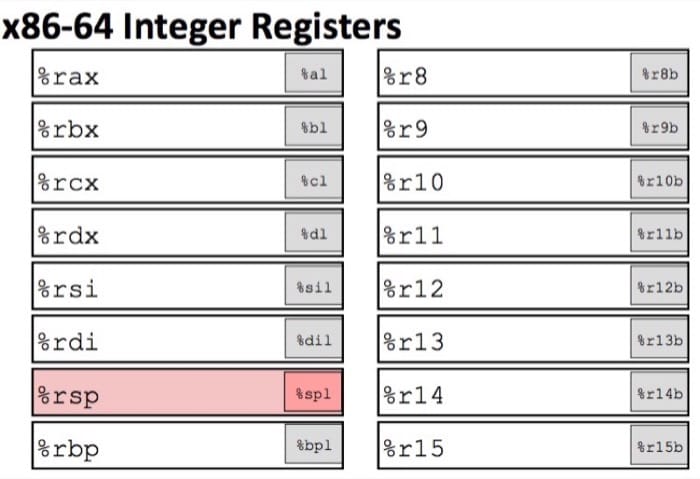
具体来说只会设置最右边的一个 byte(也就是 %al 的部分),其他的都不会改变(通过下面的例子会更清晰)
举个例子,假设我们有一条这样的语句,用来判断 x 和 y 的大小,转换成汇编之后,有几个需要注意的地方,一是 %rsi 存的是 y,%rdi 存的是 x,这个就是前面说的顺序问题。然后我们设置最右边的一个 byte(也就是 %al 的部分,见上图),最后利用 movzbl 指令把返回值复制到 %eax 寄存器中。
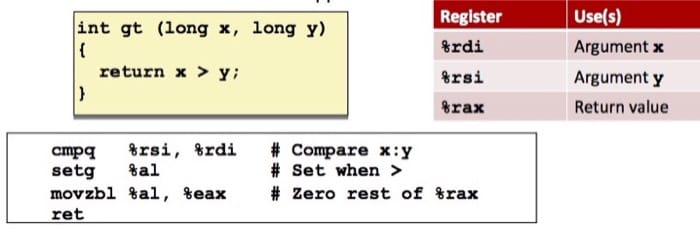
这里有一点要进行说明,到底 %eax 寄存器在哪里呢?图上怎么没有?其实 %eax 就是 %rax 寄存器的后 32 位的名称。
那为什么我们要用 32 位的指令呢,剩下的高位怎么办?这是因为在 x86-64 的架构设计中有一条规则『如果对 64 位寄存器设置 32 位数据,那么高位会被设置为 0』,所以可以通过 32 位的指令对 %eax 进行操作处理(如果忽略这个很容易让人困惑),相当于是处理好了 64 位的 %rax 寄存器。
Condition Branch
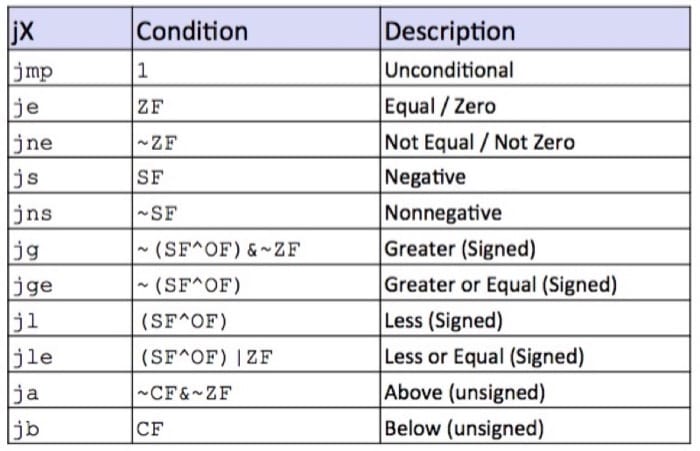
介绍完了条件代码,就可以来看看具体的跳转了,跳转实际上就是根据条件代码的不同,来进行跳转,具体如下:
我们先来看一个比较原始的例子(编译器没有进行主要优化):
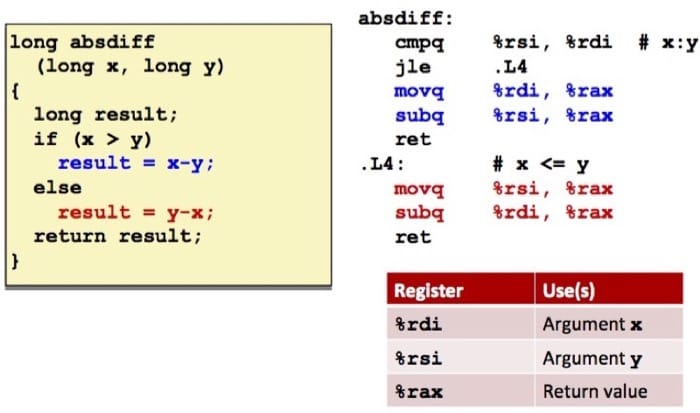
这里我们是要给出两个数的绝对值的差,所以需要判断谁大谁小,蓝色和红色的部分就分别代表两条分支。考虑到汇编不算特别直观,这里我们用 goto 语句重写一次,基本上就和汇编出来的代码逻辑类似了,方便之后的讲解:
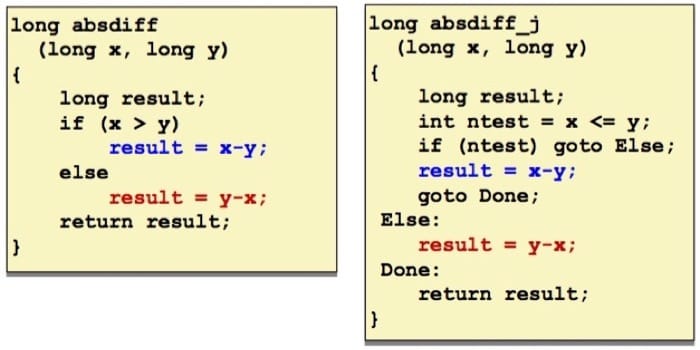
我们再看另一种条件语句要如何翻译,比如 val = Test ? Then_Expr : Else_Expr;,重写上面的函数就是:val = x>y ? x-y : y-x;
转换成 goto 形式就是:
	ntest = !Test;
	if (ntest) goto Else;
	value = Then_Expr;
	goto Done;
Else:
	val = Else_Expr;
Done:
	...
但是实际上汇编出来的代码,并不是这样的,会采用另一种方法来加速分支语句的执行。现在我们先来说一说,为什么分支语句会对性能造成很大的影响。
我们知道现在的 CPU 都是依靠流水线工作的,比方说执行一系列操作需要 ABCDE 五个步骤,那么在执行 A 的时候,实际上执行 B 所需的数据会在执行 A 的同时加载到寄存器中,这样运算器执行外 A,就可以立刻执行 B 而无须等待数据载入。如果程序一直是顺序的,那么这个过程就可以一直进行下去,效率会很高。但是一旦遇到分支,那么可能执行完 A 下一步要执行的是 C,但是载入的数据是 B,这时候就要把流水线清空(因为后面载入的东西都错了),然后重新载入 C 所需要的数据,这就带来了很大的性能影响。为此人们常常用『分支预测』这一技术来解决(分支预测是另一个话题这里不展开),但是对于这类只需要判断一次的条件语句来说,其实有更好的方法。
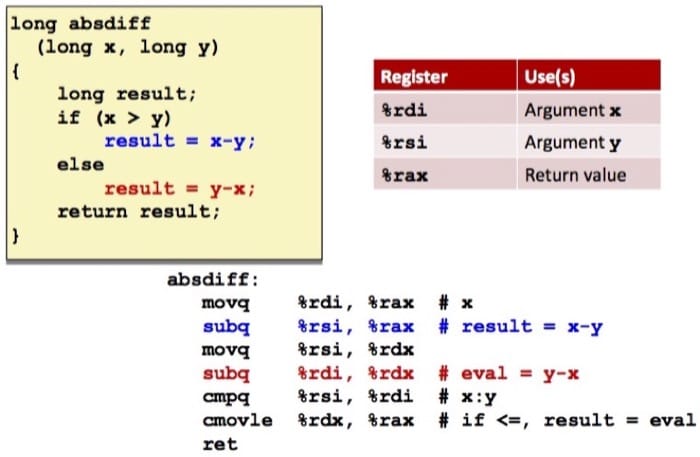
处理器有一条指令支持 if(Test) Dest <- Src 的操作,也就是说可以不用跳转,利用条件代码来进行赋值,于是编译器在可能的时候会把上面的 goto 程序改成如下:
result = Then_Expr;
eval = Else_Expr;
nt = !Test;
if (nt) result = eval;
return result;
具体的做法是:反正一共就两个分支,我都算出行不行,然后利用上面的条件指令来进行赋值,这样就完美避免了因为分支可能带来的性能问题(需要清空流水线),像下面这样:
这个方法好是好,但是也有一些情况并不适用于:
- 因为会把两个分支的运算都提前算出来,如果这两个值都需要大量计算的话,就得不偿失了,所以需要分支中的计算尽量简单。
- 另外在涉及指针操作的时候,如
val = p ? *p : 0;,因为两个分支都会被计算,所以可能导致奇怪问题出现 - 最后一种就是如果分支中的计算是有副作用的,那么就不能这样弄
val = x > 0 ? x*= 7 : x+= 3;,这种情况下,因为都计算了,那么 x 的值肯定就不是我们想要的了。
Loops
先来看看并不那么常用的 Do-While 语句:
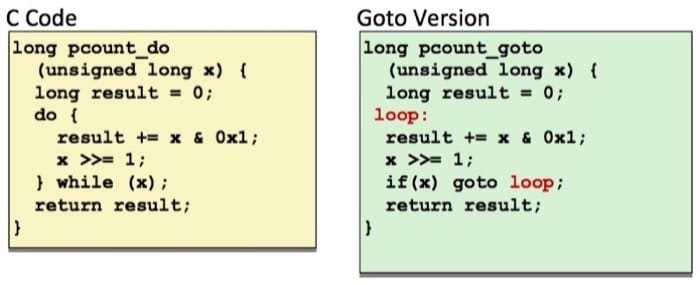
这个函数计算参数 x 中有多少位是 1,翻译成汇编如下:
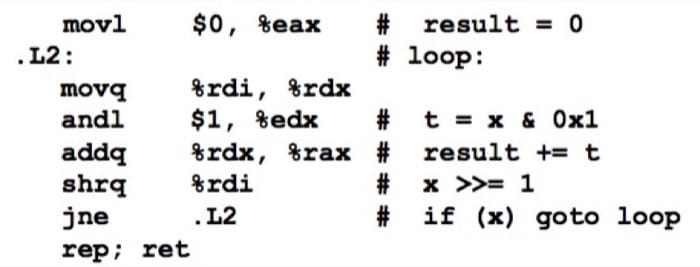
其中 %rdi 中存储的是参数 x,%rax 存储的是返回值。换成更通用的形式:
// C Code
do
	Body
	while (Test);

// Goto Version
loop:
	Body
	if (Test)
		goto loop
而对于 While 语句的转换,会直接跳到中间,如:
// C While version
while (Test)
	Body

// Goto Version
	goto test;
loop:
	Body
test:
	if (Test)
		goto loop;
done:
举个具体的例子:
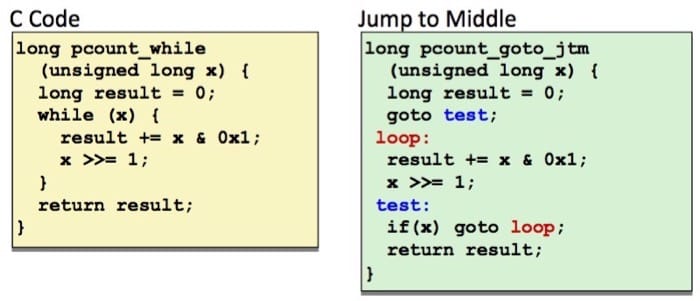
如果在编译器中开启 -O1 优化,那么会把 While 先翻译成 Do-While,然后再转换成对应的 Goto 版本:
// C While version
while (Test)
	Body

// C Do-While Version
	if (!Test)
		goto done;
	do
		Body
		while(Test);
done:

// Goto Version
	if (!Test)
		goto done;
loop:
	Body
	if (Test)
		goto loop;
done:
具体的例子是:
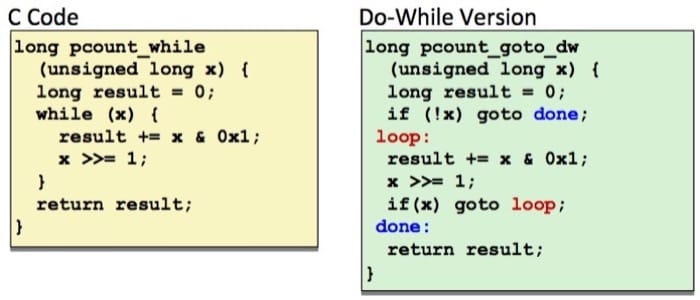
为什么要这样做呢,因为 Do-While 语句执行起来更快,更符合 CPU 的运算模型。
然后来看看最常用的 For 循环,也可以一步一步转换成 While 的形式,如下
// For
for (Init; Test; Update)
	Body

// While Version
Init;
while (Test) {
	Body
	Update;
}
而在具体转换成 Do-While 模式的时候,会把最初的测试优化去除
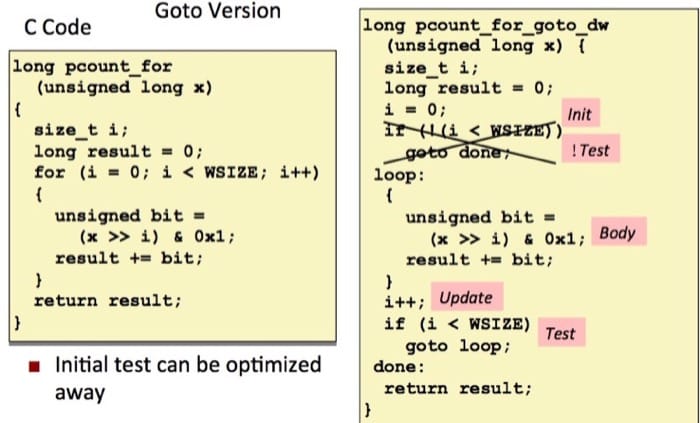
Switch Statement
最后我们来看看最复杂的 switch 语句,这种类型的语句一次判断会有多种可能的跳转路径(知道 CPU 的分支预测会多抓狂吗)。这里用一个具体的例子来进行讲解:
long switch_eg (long x, long y, long z){
	long w = 1;
	switch (x) {
		case 1:
			w = y*z;
			break;
		case 2:
			w = y/z;
			// fall through
		case 3:
			w += z;
			break;
		case 5:
		case 6:
			w -= z;
			break;
		default:
			w = 2;
	}
	return w;
}
这个例子中包含了大部分比较特殊的情况:
- 共享的条件:5 和 6
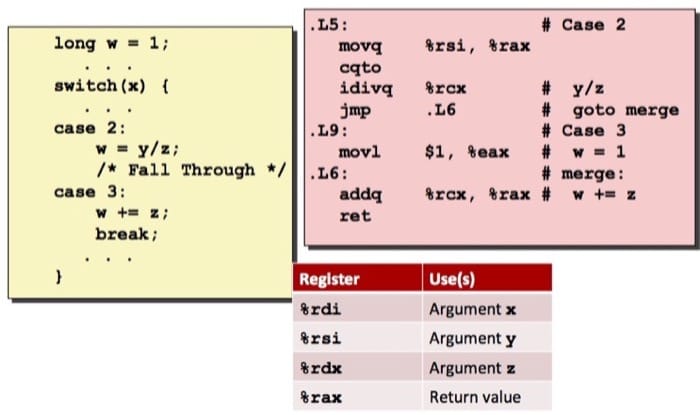
- fall through:2 也会执行 3 的部分(这个要小心,一般来说不这么搞,如果确定要用,务必写上注释)
- 缺失的条件:4
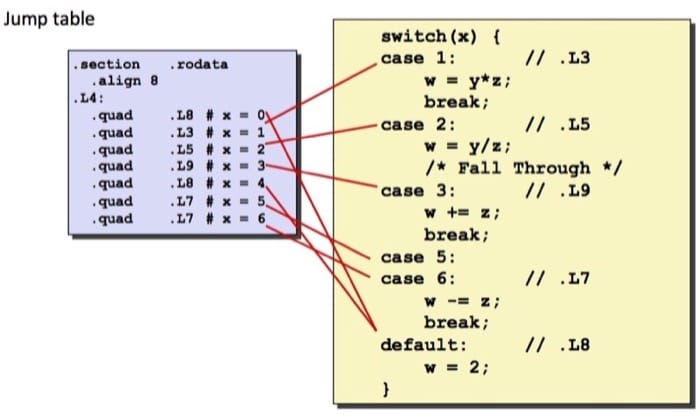
具体怎么办呢?简单来说,使用跳转表(你会发现表的解决方式在很多地方都有用:虚函数,继承甚至动态规划),如下所示:
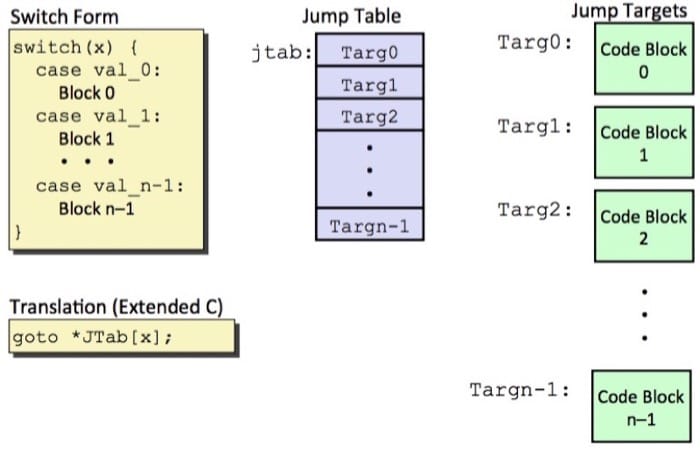
转换出来如下:
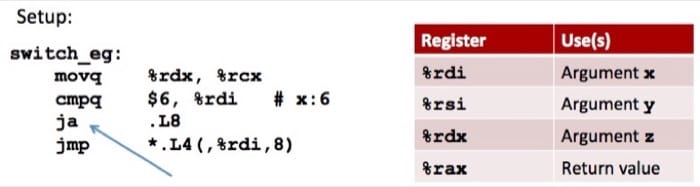
这里需要注意,我们先跟 6 进行比较(因为 6 是最大的),然后利用 ja 指令进行跳转,为什么,因为如果是负数的话,ja 是处理无符号数的,所以负数情况肯定大于 6,于是直接利用 ja 跳转到 default 的分支。
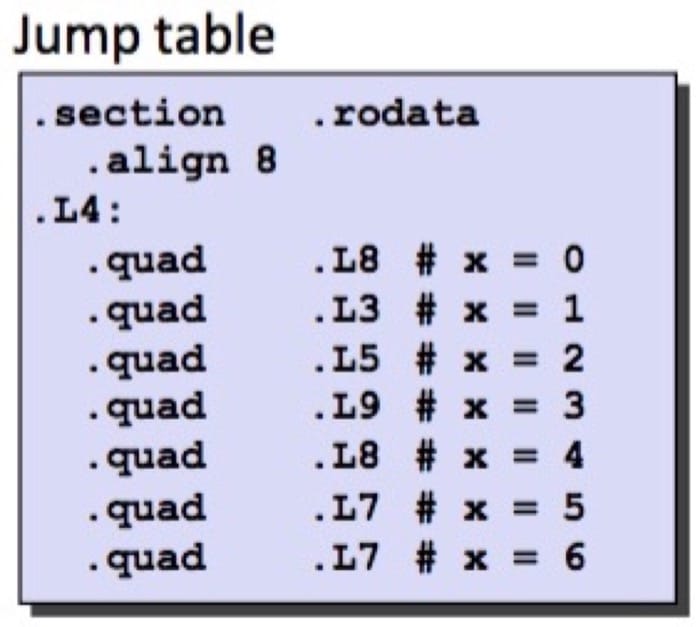
然后下一句 jmp *.L4(,%rdi, 8) # goto *JTab[x],是一个间接跳转,通过看上面的跳转列表来进行跳转。
比如说,直接跳转 jmp .L8,就直接跳到 .L8 所在的标签,也就是 x = 0
如果是 jmp *.L4(,%rdi,8) 那么就先找到 .L4 然后往后找 8 个字节(或 8 的倍数),于是就是 0~6 的范围。具体的对应关系如下:
处理 fall through 的方式:
总结
这节课我们学到了
- C 语言的控制流程
- if-then-else
- do-while
- while, for
- switch
- 汇编的控制流程
- 条件跳转
- 条件转移
- 间接跳转(通过跳转表)
- 编译器会生成代码序列来实现更加复杂的控制
- 标准技术
- 把循环转换位 do-while 的形式或者 jump-to-middle 形式
- 大的 switch 语句会用跳转表
- 处理 switch 语句可能会用到决策树(if-elseif-elseif-else)