机器学习指南
本页目录
本文是我学习机器学习时候的一些笔记和总结,因为时间比较长了,参考链接都遗失了,在这里感谢各位老司机在我学习过程中给我的帮助。
分类
将数据划分到已知类别。分类器的构建基于有监督学习(标注数据:训练集)
- 给定一个样例集合(训练集)
- 每个样例包含一个属性集合,其中一个属性是类标记/类号
- 基于训练集构建一个模型,该模型将类标记属性看作是其它属性值的一个函数
- 目标:对心的样例尽可能准确地赋予标记
- 基于一个测试集来评估模型的准确性
Training Set -> Learn Classifier -> Model <- Test set
- 二类分类:正、负
- 多类分类:多类(>=3)
二类分类是分类问题的最基本形式,多类分类问题可通过转化为二类分类问题加以解决。
- One vs. One
- 对于 K 类分类需要 K(K-1)/2 个二类分类器
- 测试分类时采用投票方式确定类别
- E.g. Labels: a, b, c
- 分类器: a vs b, b vs c, a vs c
- One vs. All(Rest):
- 对于 K 类分类需要 K 个二类分类器
- 测试分类时取返回最大值的类别
- E.g. Labels: a, b, c
- 分类器: a vs (b, c), b vs (a, c), c vs (a, b)
层次式分类,类别构成层次式结构(树状)。中图法、ODP目录。
- 应用
- 新闻分类
- 广告页面判别
- 垃圾邮件过滤
- 垃圾短信过滤
- 博客风格判断
- 评论情感分析
基于规则的分类
人工/专家制定分类规则,使用布尔操作符(AND, OR, NOT),可将规则组织成决策树,节点代表规则,叶节点代表类别
- 优势
- 透明,易于理解,易于修改
- 劣势
- 复杂,耗时
- 主要依赖人工/专家的智能,而非系统/机器智能
- 不易拓展
- 绝对的类别划分,无置信度
基于统计的分类
- 优势
- 可以输出置信概率、允许阈值控制、可扩展
- 劣势
- 需要已标注好的训练数据
- 典型方法
- 朴素贝叶斯
- Rocchio
- K 近邻
- 支持向量机
文本统计分类流程
- 预处理
- Tokenization
- Filtering
- Stemming
- 特征计算
- tf
- Log(tf+1)
- tfidf
- 特征选择
- MI
- Chi-Square
- Information Gain
- 分类学习
- SVM
- Rocchio
- Naive Bayes
- 结果评估
- Recall
- F-Measure
- Precision
文本分类-特征向量表示
- 文本表示为特征向量
- 词语(term): 基本单元
- 权重 TF * IDF
- TF: 词频
- IDF: log(N/DF), N 为文档总数量,DF 为包含该词语的文档数量
文本分类-特征选择
- 好处
- 减少特征维数,改善效果
- 防止过拟合,增强模型的泛化能力
- 提高学习效率
- 提高模型的可解释性
- 方法,从原有特征集合中找出一个更加有效的子集
- Document Frequency 文档频率
- 词语的 DF 小于某个阈值去掉(太小,没有代表性)
- 词语的 DF 大于某个阈值也去掉(太多,没有区分度)
- Mutual Information 互信息
- MI 越大词语 t 和 c 共现程度越大
- Information Gain 信息增益
- 词语 t 为整个分类所能提供的信息量(不考虑任何特征的熵和考虑该特征后的熵的差值)
- Information Ratio
- Chi Squrae
- Odd Ratio
- Document Frequency 文档频率
朴素贝叶斯分类
- 基于概率理论的学习和分类方法
- 贝叶斯理论充当重要角色
- 分类是根据给定样本描述的可能的类别基础上产生的后验概率分布
- 基于贝叶斯理论来计算后验概率
- 分类原理:最大后验估计 MAP(maximum posteriori)
Rocchio 分类方法
- 使用中心向量(centroid vector)表示一个类别
- 中心向量为某个类别下所有文档向量的平均向量
- 基于训练集计算
- 对于新文档,计算该文档与每个类别的中心向量的距离/相似度
- 基于余弦测度
- 确定其类别为距离最小/相似性最大的类别
- 优势: 训练快速,模型很小,快速分类
- 劣势: 类别数量增加时准确率降低
K 近邻分类方法
- 与 Rocchio 方法类似
- 检查新文档的 k 个近邻向量,利用这些近邻向量的类别来确定该文档的类别
- K 通过实验确定
- “近邻” 通过相似度/距离测度来定义
- 1 近邻分类方法
- 将新文档划分到与其最相近的文档样例所属的类别
- K 近邻分类方法
- 基于投票机制,将新文档划分到 k 个近邻文档中多数文档所属的类别
- 进一步,基于加权投票机制,根据近邻文档的相近程度,赋予每个近邻文档一定的权重
- 优势
- 不需要训练阶段
- 类别数量增加也具有良好的扩展性
- 劣势
- 训练数据很大时模型很大
- 需要大量内存
- 性能较慢
支持向量机 Support Vector Machine
- 对于二类分类,该方法在向量空间中找出一个决策超平面(分类函数 f(x) = wx + b),对属于两个类别的文档向量进行有效粉绿
- 通常有很多可能的分割超平面
- 找到最好的一个超平面: 最大间隔准则
- 使得属于不同类别的数据点间隔最大
- 间隔区边缘上的向量称为支撑向量
- 实际上要求解一个带约束的二次规划(quadratic programming, QP)问题
- 训练结果
- 支撑向量
- 分类
- 计算新文档向量与支撑向量的距离
- 常用工具
- SVMLight
- LIBSVM
- 优势
- 只有支撑向量用来对新文档分类
- 模型小
- 一般不会过拟合
- 劣势
- 训练过程非常复杂: 优化问题
分类结果评估
- 对每个分类都可以计算出 precision, recall, F-measure
- 一般侧重正例的结果
- 总体评价: 精度(Accuracy) = 正确分类的样本数量 / 总样本数量
如何应用于实际
- 大多数应用都是直接采用已有的分类算法与工具
- 不需要开发新的
- 关键在于特征工程
- 针对特定应用问题寻找合理、有效的特征集
- 一般需要调节分类算法与工具的多个参数
- 比如 KNN 中的 K,SVM 中的 C 参数等
聚类
- 给定一个数据点集合,每个数据点具有一组属性,数据点之间能进行相似度度量,聚类目标为找到若干类簇:
- 同一类簇中的数据点相似
- 不同类簇中的数据点不相似
- 无监督学习
- 没有标注数据
- 类簇未知
- 相似度度量准则
- 欧氏距离(L2 norm)
- 余弦准则
- L1 范式(L1 norm)
- 聚类算法
- K-Means 聚类
- 层次式聚类(Hierarchical clustering)
- 增量式单遍聚类
- 基于图分割的聚类
- 基于密度峰值的聚类
应用:文档聚类
- 目标:发现文档类簇,同一类簇中文档相似(基于重要词语)
- 方法:识别每篇文档中的重要词语,基于文档相似性进行聚类
层次式聚类
- 自底向上的凝聚式聚类(Agglomerative clustering)
- 初始每个文档自成一个类簇
- 每次合并最相似/距离最近的两个类簇,形成一个新类簇,循环执行,直到满足终止条件
- 终止条件为类簇数量或者相似度阈值
- 结果为树形图
- 不同的计算类簇间距离/相似性的方法
- 最小距离(single link)
- 最大距离(complete link)
- 平均距离(group average)
- 自顶向下的划分式聚类(Divisive clustering)
- 初始只有一个类簇,包括所有文档
- 每次从当前类簇中选择最大(或最不合理)的一个类簇,将其分割成两个(或多个)新的类簇,循环执行,直到满足终止条件
- 类簇分割方法可以采用其他聚类方法,比如 K 均值算法等
K 均值(K-means)聚类
- 一种基于划分的聚类算法
- 算法将文档集划分到 k 个类簇中
- 每个类簇有一个类簇中心,称为 centroid
- 可基于该类簇文档向量的平均向量计算
- K 由用户指定
Buckshot 算法
结合 K-means 与凝聚式聚类
- 从原始 n 个数据点中随机取 √n 个数据点
- 针对这些样本数据点上运行凝聚式聚类
- 使用凝聚式聚类结果作为初始种子点
- 在元数据上基于初始种子点运行 K-means
改善了种子点的选择
增量式单遍聚类(Single-Pass)
- 增量式聚类,适合于高效处理动态文本数据流
- 将新文档与已有类簇逐一对比,如果与某个类簇的相似度值大于设定的阈值,那么将该文档归并到相应类簇中,否则基于该文档形成一个新的类簇
- 数据流中第一个文档形成第一个类簇
基于图分割的聚类
- 计算文档对之间的相似度值,构建相似度图 G=(V,E)
- 每个文档为图的一个节点
- 文档之间有边连接,边的权重 W 为文档相似度
- 文档聚类问题转换成在图上进行顶点分割的问题
- 切割标准 min cut(A,B)
- 问题
- 只考虑了类簇之间的连接情况
- 没有考虑类簇内部的密度
- 改进方法: Normalized Cut
基于密度峰值的聚类(Science)
- 简单优美,可自动确定聚类数目,检测孤立点,可识别不同形状的聚类
- 假设: 类簇中心被一些局部密度较低的点围绕,并且这些点距离其他有高局部密度的点的距离都比较大
- 聚类过程
- 计算出所有数据点的局部密度值和到高局部密度点的距离后,可以得到一张决策图
- 在决策图上挑选具有较大密度的样本点作为类簇中心
- 将其他样本点按照局部密度从高到底依次确定所属类簇,其类簇为领域内最近的高于该点局部密度的样本点所处的类簇
半监督聚类
除了带聚类的数据,还提供了少量先验知识
- 部分标注信息
- 例如为若干数据点标注了类簇
- 约束信息
- 例如要求某两个数据点必须在同一类簇,或者某两个数据点不能在同一类簇
- Seeded K-means
- 用户提供了 Seeded points
- 利用提供的标注信息(seeded points)寻找初始类簇中心,然后运行 K-means
- Seeded points 的标签可能会改变
- Constrained K-means
- 用户提供了 Seeded points
- 利用提供的标注信息(seeded points)寻找初始类簇中心,然后运行 K-means
- Seeded points 的标签不允许被改变
聚类结果评估
- 基于人工标注的类簇进行评价
- 评价准则包括: F 值、纯度(Purity)、规范化信息(NMI)
聚类算法的选择
- 聚类算法的选择具有挑战性
- 每种算法都有各自的优势与不足,聚类效果通常依赖于聚类算法、距离函数、具体的数据与应用
- 实际做法
- 运行使用不同距离函数的多个聚类算法,分析和比较聚类结果
- 对聚类结果的解释要基于原始数据的意义以及聚类算法的特性
半监督聚类
- COP K-means
- 用户提供了 must-link 与 cannot-link 约束
- 初始化: 类簇中心随机选择,但必须保证满足 must-link 约束,也就是 must-link 的两个数据点不能选择做为不同类簇的中心
- 算法: 一个数据点必须在不违反任何约束的情况下归属到临近的类簇
检索结果聚类
- 两类方法
- 先对 snippet 进行聚类,然后为每个类簇选择标签
- 先分析获取有意义的类簇标签,然后将检索结果划分到不同标签
- 基于后缀树的检索结果聚类(Suffix Tree Clustering, STC)
- 时间复杂度低,高效
- 容易获得每个类簇的关键词标签
- 允许一个文档属于多个类簇
- 基于回归学习的检索结果聚类
- 现货的重要的短语代表类簇,然后再将检索结果跟类簇关联
- 同样允许一文档隶属多个类簇
- 候选短语(频率大于3的n-gram(n<=3))
- 短语重要性排序
- 看做回归问题
- 利用 SVM-Light 实现的支撑向量回归等多个回归方法
- 人工标注短语训练集,也即短语与其重要性分值
- 短语特征
- Phrase Frequency/Inverted Document Frequency(TFIDF)
- Phrase Length
- Intra-Cluster Similarity
- Cluster Entropy
- Phrase Independence
朴素贝叶斯(NB)
- 优点
- 对小规模的数据表现很好
- 适合多分类任务
- 适合增量式训练
- 缺点
- 对输入数据的表达形式很敏感
- 适用数据范围
- 标称型
- 算法类型
- 分类算法
朴素贝叶斯是贝叶斯理论的一部分,贝叶斯决策理论的核心思想,即选择具有高概率的决策。朴素贝叶斯之所以冠以朴素开头,是因为其在贝叶斯理论的基础上做出了两点假设:
- 每个特征之间相互独立。
- 每个特征同等重要。
贝叶斯准则是构建在条件概率的基础之上的,其公式如下:
P(H|X)是根据 X 参数值判断其属于类别 H 的概率,称为后验概率。P(H) 是直接判断某个样本属于 H 的概率,称为先验概率。P(X|H) 是在类别 H 中观测到 X 的概率(后验概率),P(X) 是在数据库中观测到X的概率。可见贝叶斯准则是基于条件概率并且和观测到样本的先验概率和后验概率是分不开的。
总结:对于分类而言,使用概率有事要比使用硬规则更为有效。贝叶斯概率及贝叶斯准则提供了一种利用已知值来估计未知概率的有效方法。可以通过特征之间的条件独立性假设,降低对数据量的需求。尽管条件独立性的假设并不正确,但是朴素贝叶斯仍然是一种有效的分类器。
一些要注意的地方:
- 给出的特征向量长度可能不同,所以需要归一化为统一长度的向量。比如说文本分类,如果特征是句子单词的话,则长度为整个词汇量的长度,对应位置是该单词出现的次数
- 利用贝叶斯分类器对文档进行分类时,要计算多个概率的乘积以获得文档属于某个类别的概率。如果其中一个概率值为 0,那么最后乘积也为 0。为了降低这种影响,可以将所有词出现数字初始化为 1,并将分母初始化为 2。拉普拉斯平滑法将每个 k 值出现次数事先都加 1,通俗讲就是假设他们都出现过一次。
- 另一个遇到的问题是下溢出,这是由于太多很小的数相乘造成的,这里取对数,就可以把乘法变为加法,并且对最后结果没有影响。
- 遇到特征之间不独立问题,参考改进的贝叶斯网络,使用 DAG 来进行概率图的描述
线性回归(Linear Regression)
- 优点
- 结果易于理解
- 计算上不复杂。
- 缺点
- 对非线性数据拟合不好。
- 适用数据类型
- 数值型
- 标称型
- 算法类型
- 回归算法
在统计学中,线性回归(Linear Regression)是利用称为线性回归方程的最小平方函数对一个或多个自变量和因变量之间关系进行建模的一种回归分析。这种函数是一个或多个称为回归系数的模型参数的线性组合(自变量都是一次方)。只有一个自变量的情况称为简单回归,大于一个自变量情况的叫做多元回归。
线性方程的模型函数的向量表示形式为:
通过训练数据集寻找向量系数的最优解,即为求解模型参数。其中求解模型系数的优化器方法可以用“最小二乘法”、“梯度下降”算法,来求解损失函数的最优解:
最小二乘法
将训练特征表示为 X 矩阵,结果表示成 y 向量,仍然是线性回归模型,误差函数不变。那么 θ 可以直接由下面公式得出
这里 y 是向量,此方法要求 X 是列满秩的,而且求矩阵的逆比较慢。
而在 LWLR(局部加权线性回归)中,参数的计算表达式为:
因为此时优化的是
由此可见 LWLR 与 LR 不同,LWLR 是一个非参数模型,因为每次进行回归计算都要遍历训练样本至少一次。
岭回归(ridge regression)
岭回归是一种专用于共线性数据分析的有偏估计回归方法,实质上是一种改良的最小二乘估计法,通过放弃最小二乘法的无偏性,以损失部分信息、降低精度为代价,获得回归系数更为符合实际、更可靠的回归方法,对病态数据的耐受性远远强于最小二乘法。
岭回归分析法是从根本上消除复共线性影响的统计方法。岭回归模型通过在相关矩阵中引入一个很小的岭参数 K(1>K>0),并将它加到主对角线元素上,从而降低参数的最小二乘估计中复共线特征向量的影响,减小复共线变量系数最小二乘估计的方法,以保证参数估计更接近真实情况。岭回归分析将所有的变量引入模型中,比逐步回归分析提供更多的信息。
总结:与分类一样,回归也是预测目标值的过程。回归与分类的不同点在于,前者预测连续型的变量,而后者预测离散型的变量。回归是统计学中最有力的工具之一。在回归方程里,求得特征对应的最佳回归系统的方法是最小化误差的平方和。
k-近邻算法(kNN)
- 优点
- 精度高
- 对异常值不敏感
- 无数据输入假定
- 缺点
- 计算复杂度高
- 空间复杂度高
- 适用数据范围
- 数值型
- 标称型
- 算法类型
- 分类算法。
存在一个样本数据集合,也称作训练样本集,并且样本集中每个数据都存在标签,即我们知道样本集中每一数据与所属分类的对应关系。输入没有标签的新数据后,将新数据的每个特征与样本集中对应的特征进行比较,然后算法提取样本集中前 k 个最相似的数据。最后,选择 k 个最相似数据中出现次数最多的分类,作为新数据的分类。
为了避免不同的特征的数值不同所导致的影响不同,可能需要进行归一化,也就是把特征值转换成 [0,1] 值
k-近邻算法是分类数据最简单最有效的算法,必须保存全部数据集,如果训练数据集很大,必须使用大量的存储空间。此外,由于必须对数据集中的每个数据计算距离值,实际使用可能非常耗时。k决策树是其优化版本,可以节省大量的计算开销。
另一个却显示它无法给出任何数据的基础结构信息,因此我们也无法知晓平均实例样本和典型实例样本具有什么特征。使用概率测量方法可以解决这个问题。
三要素
- k值的选择
- 距离的度量(常见的距离度量有欧式距离,马氏距离等)
- 分类决策规则 (多数表决规则)
k 值的选择
k值越小表明模型越复杂,更加容易过拟合- 但是k值越大,模型越简单,如果
k=N的时候就表明无论什么点都是训练集中类别最多的那个类
所以一般 k 会取一个较小的值,然后用过交叉验证来确定。这里所谓的交叉验证就是将样本划分一部分出来为预测样本,比如 95% 训练,5% 预测,然后 k 分别取1,2,3,4,5之类的,进行预测,计算最后的分类误差,选择误差最小的k
KD树
KD 树是一个二叉树,表示对K维空间的一个划分,可以进行快速检索(那KNN计算的时候不需要对全样本进行距离的计算了)
在k维的空间上循环找子区域的中位数进行划分的过程。假设现在有K维空间的数据集 T={x1,x2,x3,…xn},xi={a1,a2,a3..ak}
- 首先构造根节点,以坐标
a1的中位数b为切分点,将根结点对应的矩形局域划分为两个区域,区域 1 中a1b - 构造叶子节点,分别以上面两个区域中
a2的中位数作为切分点,再次将他们两两划分,作为深度1的叶子节点,(如果 a2 = 中位数 ,则 a2 的实例落在切分面) - 不断重复 2 的操作,深度为j的叶子节点划分的时候,索取的
ai的i=j%k+1,直到两个子区域没有实例时停止
KD树的搜索
- 首先从根节点开始递归往下找到包含x的叶子节点,每一层都是找对应的xi
- 将这个叶子节点认为是当前的“近似最近点”
- 递归向上回退,如果以
x圆心,以“近似最近点”为半径的球与根节点的另一半子区域边界相交,则说明另一半子区域中存在与x更近的点,则进入另一个子区域中查找该点并且更新”近似最近点“ - 重复 3 的步骤,直到另一子区域与球体不相交或者退回根节点
- 最后更新的”近似最近点“与
x真正的最近点
KD树进行KNN查找
通过 KD 树的搜索找到与搜索目标最近的点,这样 KNN 的搜索就可以被限制在空间的局部区域上了,可以大大增加效率。
KD树搜索的复杂度
当实例随机分布的时候,搜索的复杂度为 log(N),N 为实例的个数,KD 树更加适用于实例数量远大于空间维度的 KNN 搜索,如果实例的空间维度与实例个数差不多时,它的效率基于等于线性扫描。
决策树
决策树的主要优势在于数据形式非常容易理解。决策树很多任务都是为了数据中所蕴含的知识信息,因此决策树可以使用不熟悉的数据集合,并从中提取出一系列规则,机器学习算法最终将使用这些机器从数据集中创造的规则。
- 优点
- 计算复杂度不高
- 输出结果易于理解
- 对中间值的缺失不敏感
- 可以处理不相关特征数据
- 缺点
- 容易过拟合(后面出现了随机森林)
- 适用数据类型
- 数值型
- 标称型
- 算法类型
- 分类算法。
- 数据要求
- 树的构造只适用于标称型的数据,因此数值型数据必须离散化。
在构造决策树时,我们需要解决的第一个问题就是,当前数据集上哪个特征在划分数据分类时起决定性作用。为了找到决定性的特征,划分出最好的结果,我们必须评估每个特征。完成测试之后,原始数据集就被划分为几个数据子集。这些数据子集会分布在第一个决策点的所有分支上。
创建分支的伪代码如下:
检测数据集中的每个子项是否属于同一分类:
   if so return 类标签;
   else
       寻找数据集的最好特征
       划分数据集
       创建分支结点
           for 每个划分的子集
               调用函数createBranch并增加返回结果到分支结点中
return 分支结点划分数据集的大原则是:将无序的数据变得更加有序。组织杂乱无章数据的一种方法就是使用信息论度量信息。信息增益(information gain)和熵(entropy)
信息熵的计算公式为:
其中 表示选择该分类的概率。
决策树分类器就像带有终止块的流程图,终止块表示分类结果。开始处理数据时,我们首先需要测量集合中数据的不一致性,也就是熵,然后寻找最优方案划分数据集,直到数据集中的所有数据属于同一分类。
ID3 算法可以用于划分标称型数据集。构造决策树时,我们通常采用递归的方法将数据集转化为决策树。
决策树可能会产生过多的数据集划分,从而产生过度匹配数据集的问题。我们可以通过裁剪决策树,合并相邻的无法产生大量信息增益的叶节点,消除过度匹配的问题。
ID3、C4.5&CART
其实不同的决策树学习算法只是它们选择特征的依据不同,决策树的生成过程都是一样的(根据当前环境对特征进行贪婪的选择)。
ID3 算法的核心是在决策树各个节点上应用信息增益准则选择特征,每一次都选择使得信息增益最大的特征进行分裂,递归地构建决策树。
ID3 算法以信息增益作为划分训练数据集的特征,有一个致命的缺点。选择取值比较多的特征往往会具有较大的信息增益,所以 ID3 偏向于选择取值较多的特征。
针对 ID3 算法的不足,C4.5 算法根据信息增益比来选择特征,对这一问题进行了校正。
CART 指的是分类回归树,它既可以用来分类,又可以被用来进行回归。CART 用作回归树时用平方误差最小化作为选择特征的准则,用作分类树时采用基尼指数最小化原则,进行特征选择,递归地生成二叉树。
决策树的剪枝:我们知道,决策树在生成的过程中采用了贪婪的方法来选择特征,从而达到对训练数据进行更好地拟合(其实从极端角度来看,决策树对训练集的拟合可以达到零误差)。而决策树的剪枝是为了简化模型的复杂度,防止决策树的过拟合问题。具体的决策树剪枝策略可以参见李航的《统计学习方法》。
Logistic 回归
- 优点
- 计算代价不高
- 易于理解和实现
- 缺点
- 容易欠拟合
- 分类精度可能不高
- 适用数据类型
- 数值型
- 标称型
- 算法类别
- 分类算法
- 适用场景
- 二分类问题
Logistic 回归的目的是寻找一个非线性函数 Sigmoid 的最佳拟合参数,求解过程可以由最优化算法来完成。在最优化算法中,最常用的就是梯度上升算法,而梯度上升算法又可以简化为随机梯度上升算法。
logistic函数表达式为:
Sigmoid 函数的定义为
导数形式为
函数值域范围(0,1)。可以用来做分类器。Sigmoid函数的函数曲线如下:
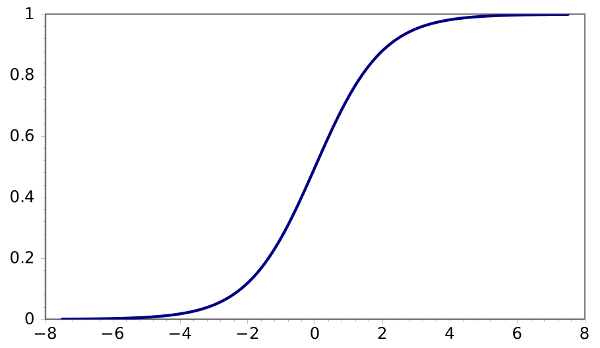
逻辑回归模型分解如下:
(1)首先将不同维度的属性值和对应的一组权重加和,公式如下:
其中 是某样本数据的各个特征,维度为m
这里就是一个线性回归。W权重值就是需要经过训练学习到的数值,具体W向量的求解,就需要用到极大似然估计和将似然估计函数代入到 优化算法来求解。最常用的最后化算法有 梯度上升算法。
单个样本的后验概率为:
整个样本的后验概率:
其中
对整个样本的后验概率取对数得到:
然后利用梯度下降来进行求解,得到最终的
由上面可见:逻辑回归函数虽然是一个非线性的函数,但其实其去除Sigmoid映射函数之后,其他步骤都和线性回归一致。
(2)然后将上述的线性目标函数 z 代入到 sigmoid 逻辑回归函数,可以得到值域为(0,0.5)和(0.5,1)两类值,等于 0.5 的怎么处理还以自己定。这样其实就得到了2类数据,也就体现了二分类的概念。
总结:Logistic 回归的目的是寻找一个非线性函数Sigmoid的最佳拟合参数,参数的求解过程可以由最优化算法来完成。在最优化算法中,最常用的就是梯度上升算法,而梯度上升算法有可以简化为随机梯度上升算法。
随机梯度上升算法与梯度上升算法的效果相当,但占用更少的计算资源。此外,随机梯度上升是一个在线算法,它可以在新数据到来时就完成参数更新,而不需要重新读取整个数据集来进行批处理运算。
处理数据中的缺失值的技巧:
- 使用可用特征的均值来填补缺失值
- 使用特殊值来填补缺失值,如 -1
- 忽略有缺失值的样本
- 使用相似样本的均值填补缺失值
- 使用另外的机器学习算法预测缺失值
关于 LR 的过拟合问题
如果我们有很多的特性,在训练集上拟合得很好,但是在预测集上却达不到这种效果
- 减少 feature 个数(人工定义留多少个 feature、算法选取这些 feature)
- 正则化(留下所有的 feature,但对于部分 feature 定义其 parameter 非常小)
关于LR的多分类 softmax
softmax 假设离散型随机变量Y的取值集合是 {1,2,..,k},则多分类的LR为
这里会输出当前样本下属于哪一类的概率,并且满足全部概率加起来=1
关于 softmax 和 k 个 LR 的选择
如果类别之间是否互斥(比如音乐只能属于古典音乐、乡村音乐、摇滚月的一种)就用softmax
否则类别之前有联系(比如一首歌曲可能有影视原声,也可能包含人声,或者是舞曲),这个时候使用k个LR更为合适
树回归
- 优点
- 可以对复杂和非线性的数据建模。
- 缺点
- 结果不易理解。
- 适用数据类型
- 数值型
- 标称型
- 算法类型
- 回归算法
简述:线性回归方法可以有效的拟合所有样本点(局部加权线性回归除外)。当数据拥有众多特征并且特征之间关系十分复杂时,构建全局模型的回归算法是比较困难的。此外,实际中很多问题为非线性的,例如常见的分段函数,不可能用全局线性模型类进行拟合。树回归将数据集切分成多份易建模的数据,然后利用线性回归进行建模和拟合。较为经典的树回归算法为 CART(classification and regreesion trees 分类回归树)。
分类回归树(Classification And Regression Tree)是一个决策二叉树,在通过递归的方式建立,每个节点在分裂的时候都是希望通过最好的方式将剩余的样本划分成两类,这里的分类指标:
- 分类树:基尼指数最小化(
gini_index) - 回归树:平方误差最小化
分类树:
- 首先是根据当前特征计算他们的基尼增益
- 选择基尼增益最小的特征作为划分特征
- 从该特征中查找基尼指数最小的分类类别作为最优划分点
- 将当前样本划分成两类,一类是划分特征的类别等于最优划分点,另一类就是不等于
- 针对这两类递归进行上述的划分工作,直达所有叶子指向同一样本目标或者叶子个数小于一定的阈值
GINI 用来度量分布不均匀性(或者说不纯),总体的类别越杂乱,GINI 指数就越大(跟熵的概念很相似)
解决决策树的过拟合
- 剪枝
- 前置剪枝:在分裂节点的时候设计比较苛刻的条件,如不满足则直接停止分裂(这样干决策树无法到最优,也无法得到比较好的效果)
- 后置剪枝:在树建立完之后,用单个节点代替子树,节点的分类采用子树中主要的分类(这种方法比较浪费前面的建立过程)
- 交叉验证
- 随机森林
随机森林 RF
优缺点
- 能够处理大量特征的分类,并且还不用做特征选择
- 能够处理具有高维特征的输入样本,而且不需要降维
- 在训练完成之后能给出哪些feature的比较重要
- 在生成过程中,能够获取到内部生成误差的一种无偏估计
- 对于缺省值问题也能够获得很好得结果
- 训练速度很快,很容易并行
- 实现相对来说较为简单
随机森林就是通过集成学习的思想将多棵树集成的一种算法,它的基本单元是决策树,而它的本质属于机器学习的一大分支——集成学习(Ensemble Learning)方法。随机森林的名称中有两个关键词,一个是“随机”,一个就是“森林”。“森林”我们很好理解,一棵叫做树,那么成百上千棵就可以叫做森林了,这样的比喻还是很贴切的,其实这也是随机森林的主要思想--集成思想的体现。
其实从直观角度来解释,每棵决策树都是一个分类器(假设现在针对的是分类问题),那么对于一个输入样本,N棵树会有N个分类结果。而随机森林集成了所有的分类投票结果,将投票次数最多的类别指定为最终的输出,这就是一种最简单的 Bagging 思想。
bagging 的代价是不用单棵决策树来做预测,具体哪个变量起到重要作用变得未知,所以 bagging 改进了预测准确率但损失了解释性。
一开始我们提到的随机森林中的“随机”就是指的这里的两个随机性。两个随机性的引入对随机森林的分类性能至关重要。由于它们的引入,使得随机森林不容易陷入过拟合,并且具有很好得抗噪能力(比如:对缺省值不敏感)。
随机森林分类效果(错误率)与两个因素有关:
- 森林中任意两棵树的相关性:相关性越大,错误率越大;
- 森林中每棵树的分类能力:每棵树的分类能力越强,整个森林的错误率越低。
减小特征选择个数m,树的相关性和分类能力也会相应的降低;增大m,两者也会随之增大。所以关键问题是如何选择最优的m(或者是范围),这也是随机森林唯一的一个参数。
构建随机森林的关键问题就是如何选择最优的m,要解决这个问题主要依据计算袋外错误率 oob error(out-of-bag error)。
随机森林有一个重要的优点就是,没有必要对它进行交叉验证或者用一个独立的测试集来获得误差的一个无偏估计。它可以在内部进行评估,也就是说在生成的过程中就可以对误差建立一个无偏估计。
我们知道,在构建每棵树时,我们对训练集使用了不同的bootstrap sample(随机且有放回地抽取)。所以对于每棵树而言(假设对于第k棵树),大约有1/3的训练实例没有参与第k棵树的生成,它们称为第k棵树的 oob 样本。 而这样的采样特点就允许我们进行 oob 估计,它的计算方式如下:
- 对每个样本,计算它作为 oob 样本的树对它的分类情况(约1/3的树);
- 然后以简单多数投票作为该样本的分类结果;
- 最后用误分个数占样本总数的比率作为随机森林的 oob 误分率。
学习过程
- 现在有 N 个训练样本,每个样本的特征为 M 个,需要建 K 颗树
- 从 N 个训练样本中有放回的取 N 个样本作为一组训练集(其余未取到的样本作为预测分类,评估其误差),每棵树的训练集都是不同的,而且里面包含重复的训练样本
- 从 M 个特征中取 m 个特征左右子集特征(
m<<M),随机地从 M 个特征中选取 m 个特征子集,每次树进行分裂时,从这 m 个特征中选择最优的; - 对采样的数据使用完全分裂的方式来建立决策树,这样的决策树每个节点要么无法分裂,要么所有的样本都指向同一个分类,每棵树都尽最大程度的生长,并且没有剪枝过程。
- 重复 2 的过程 K 次,即可建立森林
预测过程
- 将预测样本输入到K颗树分别进行预测
- 如果是分类问题,直接使用投票的方式选择分类频次最高的类别
- 如果是回归问题,使用分类之后的均值作为结果
参数问题
- 这里的一般取
m=sqrt(M) - 关于树的个数 K,一般都需要成百上千,但是也有具体的样本有关(比如特征数量)
- 树的最大深度,(太深可能可能导致过拟合)
- 节点上的最小样本数、最小信息增益
学习算法
- ID3 算法:处理离散值的量
- C45 算法:处理连续值的量
- Cart 算法:离散和连续
随机森林是一种集成学习+决策树的分类模型,它可以利用集成的思想(投票选择的策略)来提升单颗决策树的分类性能(通俗来讲就是“三个臭皮匠,顶一个诸葛亮”)。
集集成学习和决策树于一身,随机森林算法具有众多的优点,其中最为重要的就是在随机森林算法中每棵树都尽最大程度的生长,并且没有剪枝过程。
随机森林引入了两个随机性——随机选择样本(bootstrap sample)和随机选择特征进行训练。两个随机性的引入对随机森林的分类性能至关重要。由于它们的引入,使得随机森林不容易陷入过拟合,并且具有很好得抗噪能力(比如:对缺省值不敏感)
GDBT
迭代决策树 GBDT(Gradient Boosting Decision Tree)也被称为是 MART(Multiple Additive Regression Tree)或者是 GBRT(Gradient Boosting Regression Tree),也是一种基于集成思想的决策树模型,但是它和 Random Forest 有着本质上的区别。不得不提的是,GBDT 是目前竞赛中最为常用的一种机器学习算法,因为它不仅可以适用于多种场景,更难能可贵的是,GBDT 有着出众的准确率。这也是为什么很多人称 GBDT 为机器学习领域的“屠龙刀”。
这么牛叉的算法,到底是怎么做到的呢?说到这里,就不得不说一下 GBDT 中的 “GB”(Gradient Boosting)。Gradient Boosting 的原理相当的复杂,但是看不懂它也不妨碍我们对 GBDT 的理解和认识
Boosting,迭代,即通过迭代多棵树来共同决策。这怎么实现呢?难道是每棵树独立训练一遍,比如 A 这个人,第一棵树认为是 10 岁,第二棵树认为是 0 岁,第三棵树认为是 20 岁,我们就取平均值 10 岁做最终结论?当然不是!且不说这是投票方法并不是 GBDT,只要训练集不变,独立训练三次的三棵树必定完全相同,这样做完全没有意义。之前说过,GBDT 是把所有树的结论累加起来做最终结论的,所以可以想到每棵树的结论并不是年龄本身,而是年龄的一个累加量。GBDT 的核心就在于,每一棵树学的是之前所有树结论和的残差,这个残差就是一个加预测值后能得真实值的累加量。比如A的真实年龄是 18 岁,但第一棵树的预测年龄是 12 岁,差了 6 岁,即残差为 6 岁。那么在第二棵树里我们把 A 的年龄设为 6 岁去学习,如果第二棵树真的能把 A 分到 6 岁的叶子节点,那累加两棵树的结论就是 A 的真实年龄;如果第二棵树的结论是 5 岁,则 A 仍然存在 1 岁的残差,第三棵树里 A 的年龄就变成 1 岁,继续学。这就是 Gradient Boosting 在 GBDT 中的意义。
支持向量机
- 优点
- 泛化错误率低
- 计算开销不大
- 结果易解释
- 缺点
- 对参数调节和核函数的选择敏感
- 原始分类器不加修改仅适用于处理二元分类问题
- 适用数据类型
- 数值型
- 标称型
- 类别
- 分类算法
- 适用场景
- 解决二分类问题。
将数据集分隔开来的直线称为分隔超平面(separating hyperplane)。如果数据对象是 1024 维的,那么就需要一个1023维的某某对象来对数据进行分隔,这个对象就叫超平面(hyperplane),也就是分类的决策边界。分布在超平面一侧的所有数据都属于某个类别,而分布在另一侧的所有数据则属于另一个类别。
我们希望能找到离分隔超平面最近的点,确保它们离分隔面的距离尽可能远。这里点到分隔面的距离被称为间隔(margin)。我们希望间隔尽可能大,因为如果我们犯错或者在有限数据上训练分类器的话,我们希望分类器尽可能健壮。
**支持向量(support vector)**就是离分隔超平面最近的那些点。接下来要试着最大化支持向量到分隔面的距离。
分隔超平面的形式可以写成 。要计算点 A 到分隔超平面的距离,就必须给出点到分隔面的法线或垂线的长度,值为 。这里的常数 b 类似于 Logistic 回归中的截距 。
当计算数据点到分隔面的距离并确定分隔面的放置位置时,间隔是通过 来计算的。如果数据点处于正方向(+1), 会是一个很大的正数,同时 也会是一个很大的正数;而处于负方向时(-1), 仍然会是一个很大的正数。
现在的目标就是找出分类器定义中的 w 和 b。为此,我们必须找到具有最小间隔的数据点,而这些数据点也就是前面提到的支持向量。一旦找到具有最小间隔的数据点,我们就需要对该间隔最大化:
直接求解上述问题相当困难,所以需要将它转换成为另一种更容易求解的形式。
先考察一下大括号中的部分。由于对乘积进行优化是一件很讨厌的事情,因此我们要做的是固定其中一个因子而最大化其他因子。如果令所有支持向量的 都为 1,那么就可以通过求 ||w|| 的最大值来得到最终解。但是,并非所有数据点的 都等于 1,只有那些离分割超平面最近的点得到的值才为 1。而离超平面越远的数据点,其 的值也就越大。
这里的约束条件就是 。对于这类优化问题,有一个非常著名的求解方法,拉格朗日乘子法。通过引入拉格朗日乘子,我们就可以基于约束条件来表述原来的问题。由于这里的约束条件都是基于数据点的,因此我们就可以将超平面写成数据点的形式,优化函数就变成
被称为点到分隔面的函数间隔, 称为点到分隔面的几何间隔 尖括号表示两个向量的内积
约束条件为
考虑到数据不可能非常完美,就需要引入**松弛变量(slack variable)**来允许有些数据点可以处于分隔面错误的一侧。这样我们的优化目标就能保持仍然不变,但约束条件变成:
这里的常数 C 用于控制“最大化间隔”和“保证大部分点的函数间隔小于1.0”这两个目标的权重。在优化算法的实现代码中,常数 C 是一个参数,因此我们就可以通过调节该参数得到不同的结果。一旦求出了所有的 α,那么分隔超平面就可以通过这些 α 来表达。这一结论十分直接,SVM 中的主要工作就是求解这些 α。
SMO 高效优化算法(Sequential Minimal Optimization,SMO)
Platt 的 SMO 算法
SMO 表示序列最小化(Sequential Minimal Optimization)。Platt 的 SMO 算法是将大优化问题分解为多个小优化问题来求解的。这些小优化问题往往很容易求解,并且对它们进行顺序求解的结果与将它们作为整体来求解的结果是完全一致的。
SMO 算法的目标是求出一系列 α 和 b,一旦求出了这些 α,就很容易计算出权重向量 w 并得到分隔超平面。
它选择凸二次规划的两个变量,其他的变量保持不变,然后根据这两个变量构建一个二次规划问题,这个二次规划关于这两个变量解会更加的接近原始二次规划的解,通过这样的子问题划分可以大大增加整个算法的计算速度,关于这两个变量:
- 其中一个是严重违反KKT条件的一个变量
- 另一个变量是根据自由约束确定,好像是求剩余变量的最大化来确定的。
SMO 算法的工作原理是:每次循环中选择两个 α 进行优化处理。一旦找到一对合适的 α,那么就增大其中一个同时减小另一个。这里所谓的“合适”就是指两个 α 必须要符合一定的条件,条件之一就是这两个 α 必须要在间隔边界之外,第二个条件则是这两个 α 还没有进行过区间化处理或者不在边界上。
Platt SMO 算法中的外循环确定要优化的最佳 α 对。而简化版会跳过这一部分,首先在数据集上遍历每一个 α,然后在剩下的 α 集合中随机选择另一个 α,从而构建 α 对。这一点相当重要,要同时改变,因为我们有一个约束条件:
由于改变一个 α 可能会导致该约束条件失效,因此我们总是同时改变两个 α。
伪代码:
创建一个 α 向量并将其初始化为 0 向量
当迭代次数小于最大迭代次数时(外循环)
    对数据集中的每个数据向量(内循环):
        如果该数据向量可以被优化:
            随机选择另外一个数据向量
            同时优化这两个向量
            如果两个向量都不能被优化,退出内循环
    如果所有向量都没有被优化,增加迭代数量,继续下一次循环
完整的Platt SMO算法
在在选择第一个 α 值后,算法会通过一个内循环来选择第二个 α 值。在优化过程中,会通过最大化步长的方式来获得第二个 α 值。
在复杂数据上应用核函数
核函数(kernel) 和 径向基函数(fadial basis function)
利用核函数将数据映射到高维空间
从某个特征空间到另一个特征空间的映射是通过核函数来实现的。可以把核函数想象成一个包装器(wrapper)或者是接口(interface),它能把数据从某个很难处理的形式转换成另一种较易处理的形式。
SVM 优化中一个特别好的地方是,所有的运算都可以写成内积(inner product)的形式。向量的内积指的是两个向量相乘,之后得到单个标量或者数值。我们可以把内积运算替换成核函数,而不必做简化处理。将内积替换成核函数的方式被称为核技巧(kernel trick)或者核变电(kernel substation)。
径向基核函数
采用向量作为自变量的函数,基于向量距离运算输出一个标量。这个距离可以是从<0, 0>向量或者其他向量开始计算的距离,我们使用径向基函数的高斯版本,公式如下:
上述高斯核函数将数据从其特征空间映射到更高维的空间,具体来说这里是映射到一个无穷维的空间。
支持向量的数目存在一个最优值。SVM 的优点在于它能对数据进行高效分类。如果支持向量太少,就可能会得到一个很差的决策边界;如果支持向量太多,也就相当于每次都利用整个数据集进行分类,这种分类方法称为 k近邻。
可以这么看 SVM 比 k 近邻好的地方在于,从很多数据中找到最有代表性的数据点来作为分类的依据,可以有效减少多余的计算。
SVM 多分类方法
一对多
其中某个类为一类,其余 n-1 个类为另一个类,比如 A,B,C,D 四个类,第一次 A 为一个类,{B,C,D} 为一个类训练一个分类器,第二次 B 为一个类,{A,C,D} 为另一个类,按这方式共需要训练 4 个分类器,最后在测试的时候将测试样本经过这4个分类器f1(x), f2(x), f3(x) 和 f4(x),取其最大值为分类器(这种方式由于是 1 对 M 分类,会存在偏置,很不实用)
一对一(libsvm实现的方式)
任意两个类都训练一个分类器,那么n个类就需要 n*(n-1)/2 个svm分类器。
还是以 A,B,C,D 为例,那么需要 {A,B},{A,C},{A,D},{B,C},{B,D},{C,D} 为目标共6个分类器,然后在预测的将测试样本通过这6个分类器之后进行投票选择最终结果。(这种方法虽好,但是需要 n*(n-1)/2 个分类器代价太大,不过有好像使用循环图来进行改进)
小结
支持向量机的泛化错误率较低,也就是说它具有良好的学习能力,且学到的结果具有很好的推广性。这些优点使得向量机十分流行,有些人认为它是监督学习中最好的定式算法。
支持向量机试图通过求解一个二次优化问题来最大化分类间隔。
和方法或者说核技巧会将数据(有时是非线性数据)从一个低维空间映射到一个高维空间,可以将一个在低维空间中的非线性问题转换成高维空间下的线性问题来求解。和方法不止在 SVM 中适用,还可以用于其他算法中。而其中径向基函数是一个常用的度量两个向量距离的核函数。
支持向量机是一个二元分类器。当用其解决多元问题时,则需要额外的方法对其进行扩展。SVM 的效果也对优化参数和所用核函数中的参数敏感。
Bagging 和 Boosting
使用机器学习方法解决问题时,有较多模型可供选择。 一般的思路是先根据数据的特点,快速尝试某种模型,选定某种模型后, 再进行模型参数的选择(当然时间允许的话,可以对模型和参数进行双向选择)
因为不同的模型具有不同的特点, 所以有时也会将多个模型进行组合,以发挥"三个臭皮匠顶一个诸葛亮的作用",这样的思路,反应在模型中,主要有两种思路:Bagging和Boosting
Bagging
Bagging 可以看成是一种圆桌会议,或是投票选举的形式,其中的思想是:"群众的眼光是雪亮的",可以训练多个模型,之后将这些模型进行加权组合,一般这类方法的效果,都会好于单个模型的效果。 在实践中,在特征一定的情况下,大家总是使用Bagging的思想去提升效果。例如kaggle上的问题解决,因为大家获得的数据都是一样的,特别是有些数据已经过预处理。
基本的思路比较简单,就是:训练时,使用 replacement 的 sampling 方法, sampling 一部分训练数据k次并训练 k 个模型;预测时,使用 k 个模型,如果为分类,则让 k 个模型均进行分类并选择出现次数最多的类(每个类出现的次数占比可以视为置信度);如为回归,则为各类器返回的结果的平均值。
在该处,Bagging 算法可以认为每个分类器的权重都一样。
Boosting
在 Bagging 方法中,我们假设每个训练样本的权重都是一致的; 而 Boosting 算法则更加关注错分的样本,越是容易错分的样本,约要花更多精力去关注。对应到数据中,就是该数据对模型的权重越大,后续的模型就越要拼命将这些经常分错的样本分正确。 最后训练出来的模型也有不同权重,所以 boosting 更像是会整,级别高,权威的医师的话语权就重些。
Bagging 和 Boosting 都可以视为比较传统的集成学习思路。 现在常用的 Random Forest,GBDT,GBRank 其实都是更加精细化,效果更好的方法
AdaBoost
- 优点
- 泛化错误率低
- 易编码,可以应用在大部分分类器上
- 无参数调整
- 缺点
- 对离群点敏感
- 适用数据类型
- 数值型
- 标称型
boosting 是一种与 bagging 很类似的技术。不论是在 boosting 还是 bagging 当中,所使用的多个分类器的类型都是一致的。但是在前者当中,不同的分类器是通过串行训练而获得的,每个新分类器都根据已训练出的分类器的性能来进行训练。boosting 是通过集中关注被已有分类器错分的那些数据来获得新的分类器。
由于 boosting 分类的结果是基于所有分类器的加权求和结果的,因此 boosting 与 bagging 不太一样。bagging 中的分类器权重是相等的,而 boosting 中的分类器权重并不相等,每个权重代表的是其对应分类器在上一轮迭代中的成功度。
boosting 方法拥有多个版本,这里只关注最流行的 AdaBoost
能否使用弱分类器和多个实例来构建一个强分类器?这是一个非常有趣的理论问题。这里的“弱”意味着分类器的性能比所及猜测要略好,但是也不会好太多。AdaBoost 算法即脱胎于上述理论问题。
AdaBoost 是 adaptive boosting(自适应 boosting)的缩写,其运行过程如下:训练数据中的每个样本各有一个权重,这些权重构成了向量 D。一开始,这些权重都初始化成相等值。首先在训练数据上训练处一个弱分类器并计算该分类器的错误率,然后在同一数据集上再次训练弱分类器。在分类器的第二次训练当中,将会重新调整每个样本的权重,其中第一次分对的样本的权重将会降低,而第一次分错的样本的权重将会提高。
为了从所有弱分类器中得到最终的分类结果,AdaBoost 为每个分类器都分配了一个权重值 α,这些 α 值是基于每个弱分类器的错误率进行计算的。错误率和 α 的公式为
计算出 α 值之后,可以对权重向量 D 进行更新,以使那些正确分类的样本的权重降低而错分样本的权重升高。D 的计算方法如下:
正确情况:
错误情况:
计算出 D 之后,AdaBoost 又开始进入下一轮迭代。AdaBoost 算法会不断地重复训练和调整权重的过程,直到训练错误率为 0 或者弱分类器的数目达到用户的指定值为止。
构建弱分类器:**单层决策树(decision stump, 决策树桩)**是一种简单的决策树,仅基于单个特征来做决策。
KMeans
- 优点
- 容易实现
- 对处理大数据集,该算法是相对可伸缩的和高效率的,因为它的复杂度大约是 O(nkt),其中 n 是所有对象的数目,k 是簇的数目,t 是迭代的次数。通常 k<<n。这个算法通常局部收敛
- 算法尝试找出使平方误差函数值最小的 k 个划分。当簇是密集的、球状或团状的,且簇与簇之间区别明显时,聚类效果较好
- 缺点
- 可能收敛到局部最小值
- 在大规模数据集上收敛较慢
- k-平均方法只有在簇的平均值被定义的情况下才能使用,且对有些分类属性的数据不适合
- 要求用户必须事先给出要生成的簇的数目 k
- 不适合于发现非凸面形状的簇,或者大小差别很大的簇
- 对于"噪声"和孤立点数据敏感,少量的该类数据能够对平均值产生极大影响
- 使用数据类型
- 数值型
- 算法类型
- 聚类算法
K-Means的基本步骤:
- 从数据对象中随机的初始化K个初始点作为质心。然后将数据集中的每个点分配到一个簇中,具体来讲每个点找到距其最近的质心,并将其分配给该质心所对应的簇。
- 计算每个簇中样本点的均值,然后用均值更新掉该簇的质心。然后划分簇结点。
- 迭代重复(2)过程,当簇对象不再发生变化时,或者误差在评测函数预估的范围时,停止迭代。
选择批次距离尽可能远的K个点
首先随机选取一个点作为初始点,然后选择距离与该点最远的那个点作为中心点,再选择距离与前两个点最远的点作为第三个中心点,以此类推,直至选取大k个
选用层次聚类或者 Canopy 算法进行初始聚类
聚类属于无监督学习,以往的回归、朴素贝叶斯、SVM 等都是有类别标签 y 的,也就是说样例中已经给出了样例的分类。而聚类的样本中却没有给定 y,只有特征 x,比如假设宇宙中的星星可以表示成三维空间中的点集(x,y,z)。聚类的目的是找到每个样本x潜在的类别y,并将同类别y的样本x放在一起。
在聚类问题中,给我们的训练样本是 {x(1),...,x(m)},每个 x(i)∈ R^n,没有了 y。
下面累述一下 K-means 与 EM 的关系,首先回到初始问题,我们目的是将样本分成 k 个类,其实说白了就是求每个样例 x 的隐含类别 y,然后利用隐含类别将 x 归类。由于我们事先不知道类别 y,那么我们首先可以对每个样例假定一个 y吧,但是怎么知道假定的对不对呢?怎么评价假定的好不好呢?我们使用样本的极大似然估计来度量,这里是就是x和y的联合分布 P(x,y)了。如果找到的 y 能够使 P(x,y) 最大,那么我们找到的 y 就是样例 x 的最佳类别了,x 顺手就聚类了。但是我们第一次指定的 y 不一定会让 P(x,y) 最大,而且 P(x,y) 还依赖于其他未知参数,当然在给定 y 的情况下,我们可以调整其他参数让 P(x,y) 最大。但是调整完参数后,我们发现有更好的 y 可以指定,那么我们重新指定 y,然后再计算 P(x,y) 最大时的参数,反复迭代直至没有更好的 y 可以指定。
这个过程有几个难点,第一怎么假定 y?是每个样例硬指派一个 y 还是不同的 y 有不同的概率,概率如何度量。第二如何估计P(x,y),P(x,y) 还可能依赖很多其他参数,如何调整里面的参数让 P(x,y) 最大。
这里只是指出 EM 的思想,E 步就是估计隐含类别 y 的期望值,M 步调整其他参数使得在给定类别 y 的情况下,极大似然估计 P(x,y) 能够达到极大值。然后在其他参数确定的情况下,重新估计 y,周而复始,直至收敛。
上面的阐述有点费解,对应于K-对应隐含变量也就是最佳类别 。最开始可以随便指定一个 给它,然后为了让 P(x,y) 最大(这里是要让 J 最小),我们求出在给定 c 情况下,J最小时的 (前面提到的其他未知参数),然而此时发现,可以有更好的 (质心与样例 距离最小的类别)指定给样例 ,那么 得到重新调整,上述过程就开始重复了,直到没有更好的 指定。
这样从K-means里我们可以看出它其实就是EM的体现,E步是确定隐含类别变量 ,M步更新其他参数 u 来使J最小化。这里的隐含类别变量指定方法比较特殊,属于硬指定,从k个类别中硬选出一个给样例,而不是对每个类别赋予不同的概率。总体思想还是一个迭代优化过程,有目标函数,也有参数变量,只是多了个隐含变量,确定其他参数估计隐含变量,再确定隐含变量估计其他参数,直至目标函数最优。
总结
如果将样本看作观察值,潜在类别看作是隐藏变量,那么聚类问题也就是参数估计问题,只不过聚类问题中参数分为隐含类别变量和其他参数,这犹如在 x-y 坐标系中找一个曲线的极值,然而曲线函数不能直接求导,因此什么梯度下降方法就不适用了。但固定一个变量后,另外一个可以通过求导得到,因此可以使用坐标上升法,一次固定一个变量,对另外的求极值,最后逐步逼近极值。对应到EM上,E步估计隐含变量,M步估计其他参数,交替将极值推向最大。EM中还有“硬”指定和“软”指定的概念,“软”指定看似更为合理,但计算量要大,“硬”指定在某些场合如 K-means 中更为实用(要是保持一个样本点到其他所有中心的概率,就会很麻烦)。
另外,EM 的收敛性证明方法确实很牛,能够利用 log 的凹函数性质,还能够想到利用创造下界,拉平函数下界,优化下界的方法来逐步逼近极大值。而且每一步迭代都能保证是单调的。最重要的是证明的数学公式非常精妙,硬是分子分母都乘以z的概率变成期望来套上Jensen不等式,前人都是怎么想到的。
PCA 主成分分析
- 优点
- 降低数据的复杂性
- 识别最重要的多个特征。
- 缺点
- 不一定需要
- 且可能损失有用信息。
- 适用适用类型
- 数值型
- 技术类型
- 降维技术
按照一定的数学变换方法,把给定的一组相关变量(维度)通过线性变换转成另一组不相关的变量,这些新的变量按照方差依次递减的顺序排列。在数学变换中保持变量的总方差不变,使第一变量具有最大的方差,称为第一主成分,第二变量的方差次大,并且和第一变量不相关,称为第二主成分。依次类推,I个变量就有I个主成分。
通过低维表征的向量和特征向量矩阵,可以基本重构出所对应的原始高维向量
总结与讨论
PCA技术的一大好处是对数据进行降维的处理。我们可以对新求出的“主元”向量的重要性进行排序,根据需要取前面最重要的部分,将后面的维数省去,可以达到降维从而简化模型或是对数据进行压缩的效果。同时最大程度的保持了原有数据的信息。
PCA技术的一个很大的优点是,它是完全无参数限制的。在PCA的计算过程中完全不需要人为的设定参数或是根据任何经验模型对计算进行干预,最后的结果只与数据相关,与用户是独立的。
但是,这一点同时也可以看作是缺点。如果用户对观测对象有一定的先验知识,掌握了数据的一些特征,却无法通过参数化等方法对处理过程进行干预,可能会得不到预期的效果,效率也不高。
SVD(singular value decomposition) 奇异值分解
- 优点
- 简化数据
- 去除噪声
- 提高算法的结果。
- 缺点
- 数据转换可能难以理解。
- 适用数据类型
- 数值型
- SVD是矩阵分解的一种类型。
总结:SVD是一种强大的降维工具,我们可以利用SVD来逼近矩阵并从中提取重要特征。通过保留矩阵 80%~90% 的能量,就可以得到重要的特征并去掉噪声。SVD已经运用到多个应用中,其中一个成功的应用案例就是推荐引擎。推荐引擎将物品推荐给用户,协同过滤则是一种基于用户喜好和行为数据的推荐和实现方法。协同过滤的核心是相似度计算方法,有很多相似度计算方法都可以用于计算物品或用户之间的相似度。通过在低维空间下计算相似度,SVD提高了推荐引擎的效果。
SVD将矩阵分解为三个矩阵的乘积,公式如下所示:
中间的矩阵sigma为对角矩阵,对角元素的值为Data矩阵的奇异值(注意奇异值和特征值是不同的),且已经从大到小排列好了。即使去掉特征值小的那些特征,依然可以很好的重构出原始矩阵。
如果 m 代表商品的个数,n 代表用户的个数,则 U 矩阵的每一行代表商品的属性,现在通过降维 U 矩阵(取深色部分)后,每一个商品的属性可以用更低的维度表示(假设为 k 维)。这样当新来一个用户的商品推荐向量 X,则可以根据公式 得到一个 k 维的向量,然后在 V’ 中寻找最相似的那一个用户(相似度测量可用余弦公式等),根据这个用户的评分来推荐(主要是推荐新用户未打分的那些商品)。
SVD++ 可以说是SVD模型的加强版,除了打分关系,SVD++还可以对隐含的回馈(implicit feedback) 进行建模。
这种隐含的回馈可以是打分动作(谁对某个商品打过分),或者是浏览记录等。 只要有类似的隐含回馈,客观上也表示了 user 对某个 item 的偏好。 毕竟,user 不会无缘无故地浏览一个 item,肯定有什么原因, 比如 user 喜欢紫色,恰恰这个 item 也是紫色的,那通过隐含回馈就可以对 user 对紫色的偏好建模出来。
现实中,隐含回馈的原因比较复杂,专门给一部分参数空间去建模,肯定对用户的建模有一些帮助。
除了在 SVD 中定义的向量外,每个 item 对应一个向量 yi ,来通过 user 隐含回馈过的 item 的集合来刻画用户的偏好。
特征工程
特征工程大概包括两个部分:特征提取和特征选择。
一般来说,领域内的知识主要是应用在特征提取。举个例子的话,比如说基于内容的购物推荐,性别就是一个很重要的领域知识,男性和女性关注的物品差别就比较大,推荐也应该体现出这种差别,那么这个特征就是这个问题一个重要特征,应该重点从已知数据提取,甚至专门为它再构建一个机器学习问题。
一般简单且常见的都是卡方检验,互信息和信息增益这三种
关于特征工程(Feature Engineering),已经是很古老很常见的话题了,坊间常说:“数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已”。由此可见,特征工程在机器学习中占有相当重要的地位。在实际应用当中,可以说特征工程是机器学习成功的关键。纵观 Kaggle、KDD 等国内外大大小小的比赛,每个竞赛的冠军其实并没有用到很高深的算法,大多数都是在特征工程这个环节做出了出色的工作,然后使用一些常见的算法,比如LR,就能得到出色的性能。遗憾的是,在很多的书籍中并没有直接提到 Feature Engineering,更多的是 Feature selection。这也并不,很多ML书籍都是以讲解算法为主,他们的目的是从理论到实践来理解算法,所以用到的数据要么是使用代码生成的,要么是已经处理好的数据,并没有提到特征工程。在这篇文章,我打算自我总结下特征工程,让自己对特征工程有个全面的认识。在这我要说明一下,我并不是说那些书写的不好,其实都很有不错,主要是因为它们的目的是理解算法,所以直接给出数据相对而言对于学习和理解算法效果更佳。
特征工程是利用数据领域的相关知识来创建能够使机器学习算法达到最佳性能的特征的过程。
简而言之,特征工程就是一个把原始数据转变成特征的过程,这些特征可以很好的描述这些数据,并且利用它们建立的模型在未知数据上的表现性能可以达到最优(或者接近最佳性能)。从数学的角度来看,特征工程就是人工地去设计输入变量X。
(1)特征越好,灵活性越强
只要特征选得好,即使是一般的模型(或算法)也能获得很好的性能,因为大多数模型(或算法)在好的数据特征下表现的性能都还不错。好特征的灵活性在于它允许你选择不复杂的模型,同时运行速度也更快,也更容易理解和维护。
(2)特征越好,构建的模型越简单
有了好的特征,即便你的参数不是最优的,你的模型性能也能仍然会表现的很nice,所以你就不需要花太多的时间去寻找最有参数,这大大的降低了模型的复杂度,使模型趋于简单。
(3)特征越好,模型的性能越出色
显然,这一点是毫无争议的,我们进行特征工程的最终目的就是提升模型的性能。
特征选择 Feature Selection
首先,从特征开始说起,假设你现在有一个标准的Excel表格数据,它的每一行表示的是一个观测样本数据,表格数据中的每一列就是一个特征。在这些特征中,有的特征携带的信息量丰富,有的(或许很少)则属于无关数据(irrelevant data),我们可以通过特征项和类别项之间的相关性(特征重要性)来衡量。比如,在实际应用中,常用的方法就是使用一些评价指标单独地计算出单个特征跟类别变量之间的关系。如Pearson相关系数,Gini-index(基尼指数),IG(信息增益)等,下面举Pearson指数为例,它的计算方式如下:
其中,x 属于 X,X 表一个特征的多个观测值,y 表示这个特征观测值对应的类别列表。
Pearson 相关系数的取值在 0 到 1 之间,如果你使用这个评价指标来计算所有特征和类别标号的相关性,那么得到这些相关性之后,你可以将它们从高到低进行排名,然后选择一个子集作为特征子集(比如top 10%),接着用这些特征进行训练,看看性能如何。此外,你还可以画出不同子集的一个精度图,根据绘制的图形来找出性能最好的一组特征。
这就是特征工程的子问题之一——特征选择,它的目的是从特征集合中挑选一组最具统计意义的特征子集,从而达到降维的效果。
做特征选择的原因是因为这些特征对于目标类别的作用并不是相等的,一些无关的数据需要删掉。做特征选择的方法有多种,上面提到的这种特征子集选择的方法属于 filter(刷选器)方法,它主要侧重于单个特征跟目标变量的相关性。优点是计算时间上较高效,对于过拟合问题也具有较高的鲁棒性。缺点就是倾向于选择冗余的特征,因为他们不考虑特征之间的相关性,有可能某一个特征的分类能力很差,但是它和某些其它特征组合起来会得到不错的效果。另外做特征子集选取的方法还有 wrapper(封装器)和 Embeded(集成方法)。wrapper 方法实质上是一个分类器,封装器用选取的特征子集对样本集进行分类,分类的精度作为衡量特征子集好坏的标准,经过比较选出最好的特征子集。常用的有逐步回归(Stepwise regression)、向前选择(Forward selection)和向后选择(Backward selection)。它的优点是考虑了特征与特征之间的关联性,缺点是:当观测数据较少时容易过拟合,而当特征数量较多时,计算时间又会增长。对于 Embeded 集成方法,它是学习器自身自主选择特征,如使用 Regularization 做特征选择,或者使用决策树思想,细节这里就不做介绍了。这里还提一下,在做实验的时候,我们有时候会用 Random Forest 和 Gradient boosting 做特征选择,本质上都是基于决策树来做的特征选择,只是细节上有些区别。
特征提取
原则上来讲,特征提取应该在特征选择之前。特征提取的对象是原始数据(raw data),它的目的是自动地构建新的特征,将原始特征转换为一组具有明显物理意义(Gabor、几何特征[角点、不变量]、纹理[LBP HOG])或者统计意义或核的特征。比如通过变换特征取值来减少原始数据中某个特征的取值个数等。对于表格数据,你可以在你设计的特征矩阵上使用主要成分分析(Principal Component Analysis,PCA)来进行特征提取从而创建新的特征。对于图像数据,可能还包括了线或边缘检测。
常用的方法有:
- PCA (Principal component analysis,主成分分析)
- ICA (Independent component analysis,独立成分分析)
- LDA (Linear Discriminant Analysis,线性判别分析)
对于图像识别中,还有SIFT方法。
用中文来说就是:特征工程是一个超集,它包括特征提取、特征构建和特征选择这三个子模块。在实践当中,每一个子模块都非常重要,忽略不得。根据答主的经验,他将这三个子模块的重要性进行了一个排名,即:特征构建>特征提取>特征选择。
事实上,真的是这样,如果特征构建做的不好,那么它会直接影响特征提取,进而影响了特征选择,最终影响模型的性能。
实体识别
命名实体识别(Named EntitiesRecognition, NER)是自然语言处理(Natural LanguageProcessing, NLP)的一个基础任务。其目的是识别语料中人名、地名、组织机构名等命名实体。由于这些命名实体数量不断增加,通常不可能在词典中穷尽列出,且其构成方法具有各自的一些规律性,因而,通常把对这些词的识别从词汇形态处理(如汉语切分)任务中独立处理,称为命名实体识别。命名实体识别技术是信息抽取、信息检索、机器翻译、问答系统等多种自然语言处理技术必不可少的组成部分。
命名实体是命名实体识别的研究主体,一般包括3大类(实体类、时间类和数字类)和7小类(人名、地名、机构名、时间、日期、货币和百分比)命名实体。评判一个命名实体是否被正确识别包括两个方面:实体的边界是否正确;实体的类型是否标注正确。主要错误类型包括文本正确,类型可能错误;反之,文本边界错误,而其包含的主要实体词和词类标记可能正确。
命名实体识别的主要技术方法分为:基于规则和词典的方法、基于统计的方法、二者混合的方法等。
1.基于规则和词典的方法
基于规则的方法多采用语言学专家手工构造规则模板,选用特征包括统计信息、标点符号、关键字、指示词和方向词、位置词(如尾字)、中心词等方法,以模式和字符串相匹配为主要手段,这类系统大多依赖于知识库和词典的建立。基于规则和词典的方法是命名实体识别中最早使用的方法,一般而言,当提取的规则能比较精确地反映语言现象时,基于规则的方法性能要优于基于统计的方法。但是这些规则往往依赖于具体语言、领域和文本风格,编制过程耗时且难以涵盖所有的语言现象,特别容易产生错误,系统可移植性不好,对于不同的系统需要语言学专家重新书写规则。基于规则的方法的另外一个缺点是代价太大,存在系统建设周期长、移植性差而且需要建立不同领域知识库作为辅助以提高系统识别能力等问题。
2.基于统计的方法
基于统计机器学习的方法主要包括:隐马尔可夫模型(HiddenMarkovMode,HMM)、最大熵(MaxmiumEntropy,ME)、支持向量机(Support VectorMachine,SVM)、条件随机场(ConditionalRandom Fields,CRF)等。
在这4种学习方法中,最大熵模型结构紧凑,具有较好的通用性,主要缺点是训练时间复杂性非常高,有时甚至导致训练代价难以承受,另外由于需要明确的归一化计算,导致开销比较大。而条件随机场为命名实体识别提供了一个特征灵活、全局最优的标注框架,但同时存在收敛速度慢、训练时间长的问题。一般说来,最大熵和支持向量机在正确率上要比隐马尔可夫模型高一些,但是隐马尔可夫模型在训练和识别时的速度要快一些,主要是由于在利用Viterbi算法求解命名实体类别序列的效率较高。隐马尔可夫模型更适用于一些对实时性有要求以及像信息检索这样需要处理大量文本的应用,如短文本命名实体识别。
基于统计的方法对特征选取的要求较高,需要从文本中选择对该项任务有影响的各种特征,并将这些特征加入到特征向量中。依据特定命名实体识别所面临的主要困难和所表现出的特性,考虑选择能有效反映该类实体特性的特征集合。主要做法是通过对训练语料所包含的语言信息进行统计和分析,从训练语料中挖掘出特征。有关特征可以分为具体的单词特征、上下文特征、词典及词性特征、停用词特征、核心词特征以及语义特征等。
基于统计的方法对语料库的依赖也比较大,而可以用来建设和评估命名实体识别系统的大规模通用语料库又比较少。
3.混合方法
自然语言处理并不完全是一个随机过程,单独使用基于统计的方法使状态搜索空间非常庞大,必须借助规则知识提前进行过滤修剪处理。目前几乎没有单纯使用统计模型而不使用规则知识的命名实体识别系统,在很多情况下是使用混合方法:
- 统计学习方法之间或内部层叠融合。
- 规则、词典和机器学习方法之间的融合,其核心是融合方法技术。在基于统计的学习方法中引入部分规则,将机器学习和人工知识结合起来。
- 将各类模型、算法结合起来,将前一级模型的结果作为下一级的训练数据,并用这些训练数据对模型进行训练,得到下一级模型。
这种方法在具体实现过程中需要考虑怎样高效地将两种方法结合起来,采用什么样的融合技术。由于命名实体识别在很大程度上依赖于分类技术,在分类方面可以采用的融合技术主要包括如Voting, XVoting, GradingVa, l Grading等。
特征向量
归一化方法
- 线性函数转换,表达式如下:
y=(x-MinValue)/(MaxValue-MinValue) - 对数函数转换,表达式如下:
y=log10 (x) - 反余切函数转换 ,表达式如下:
y=arctan(x)*2/PI - 减去均值,乘以方差:
y=(x-means)/ variance
异常值处理
用均值或者其他统计量代替
ROC、AUC
ROC和AUC通常是用来评价一个二值分类器的好坏
ROC
曲线坐标上:
- X 轴是 FPR(表示假阳率-预测结果为 positive,但是实际结果为 negitive,FP/(N))
- Y 轴式 TPR(表示真阳率-预测结果为 positive,而且的确真实结果也为 positive 的, TP/P)
那么平面的上点(X,Y):
- (0,1)表示所有的 positive 的样本都预测出来了,分类效果最好
- (0,0)表示预测的结果全部为 negitive
- (1,0)表示预测的错过全部分错了,分类效果最差
- (1,1)表示预测的结果全部为 positive
针对落在 x=y 上点,表示是采用随机猜测出来的结果
ROC 曲线建立
一般默认预测完成之后会有一个概率输出 p,这个概率越高,表示它对 positive 的概率越大。
现在假设我们有一个 threshold,如果 p>threshold,那么该预测结果为 positive,否则为 negative,按照这个思路,我们多设置几个 threshold,那么我们就可以得到多组 positive 和 negative 的结果了,也就是我们可以得到多组 FPR 和 TPR 值将这些 (FPR,TPR) 点投射到坐标上再用线连接起来就是 ROC 曲线了
当threshold取1和0时,分别得到的就是(0,0)和(1,1)这两个点。(threshold=1,预测的样本全部为负样本,threshold=0,预测的样本全部为正样本)
AUC
AUC(Area Under Curve) 被定义为 ROC 曲线下的面积,显然这个面积不会大于1(一般情况下 ROC 会在 x=y 的上方,所以0.5<AUC<1).
AUC越大说明分类效果越好
为什么要使用ROC和AUC
因为当测试集中的正负样本发生变化时,ROC 曲线能基本保持不变,但是 precision 和 recall 可能就会有较大的波动。
熵
在信息论中,熵表示的是不确定性的量度。信息论的创始人香农在其著作《通信的数学理论》中提出了建立在概率统计模型上的信息度量。他把信息定义为”用来消除不确定性的东西“。熵的定义为信息的期望值。
在信息论和概率统计中,熵是表示随机变量不确定性的度量。设X是一个取有限个值的离散随机变量,其概率分布为:
则随机变量X的熵定义为:
熵只依赖 X 的分布,和 X 的取值没有关系,熵是用来度量不确定性,当熵越大,概率说 的不确定性越大,反之越小,在机器学期中分类中说,熵越大即这个类别的不确定性更大,反之越小。
当 p=0 或 p=1 时,H(p)=0,随机变量完全没有不确定性,当p=0.5时,H(p)=1,此时随机变量的不确定性最大。
条件熵(conditional entropy):表示在一直随机变量X的条件下随机变量Y的不确定性度量。
设随机变量(X, Y),其联合概率分布为 ,随机变量 X 给定的条件下随机变量Y的条件熵 H(Y|X),定义为 X 给定条件下 Y 的条件概率分布的熵对 X 的数学期望:
这里,
熵指的是体系的混乱程度,它在控制论,概率论,数论,天体物理,生命科学等领域都有重要的应用,在不同的学科中也有引申出更为具体的定义,是各个领域十分重要的参量。熵由鲁道夫.克劳修斯提出,并应用在热力学中。后来在,克劳德.埃尔伍德.香农 第一次将熵的概念引入到信息论中来。
信息增益(information gain)
信息增益表示得知特征X的信息而使得类Y的信息的不确定性减少的程度。
特征 A 对训练数据集 D 的信息增益 g(D, A),定义为集合 D 的经验熵 H(D)与特征 A 给定条件下 D 的经验条件熵 H(D|A)之差,即
g(D, A)=H(D)-H(D|A)
信息增益大的特征具有更强的分类能力。
信息增益比(information gain ratio)
信息增益比 定义为其信息增益 g(D, A) 与训练数据集 D 关于特征 A 的值的熵 之比,即
其中, , n 是特征 A 取值的个数。
基尼指数(gini index)
分类问题中,假设有 K 个类,样本属于第 k 类的概率为 ,则概率分布的基尼指数定义为:
对于二分类问题,若样本点属于第 1 个类的概率是 p,则概率分布的基尼指数为:
Gini(p)=2p(1-p)
对于给定的样本集合D,其基尼指数为:
这里, 是 D 中属于第 k 类的样本子集,k 是类的个数。
如果样本集合 D 根据特征 A 是否取到某一可能值 a 被分割成 D1 和 D2 两部分,则在特征 A 的条件下,集合 D 的基尼指数定义为:
基尼指数 Gini(D) 表示集合 D 的不确定性,基尼指数越大,样本集合的不确定性也就越大,这一点与熵相似。
相关文章
- 机器学习平台设计:让实验能够交付2026-11-06
- 【机器学习与数据科学之旅】B2 《算法与数据中台》读书笔记2020-12-07
- 【机器学习与数据科学之旅】B1 《深入理解 AutoML 和 AutoDL》读书笔记2020-10-28
- 【机器学习与数据科学之旅】1 Numpy 实例指南2020-06-16