深入理解计算机系统 第 8 课 Machine Advanced
本页目录
这一讲是机器代码的最后一部分,会介绍一些『高级』话题,比如程序在内存中的组织,缓冲区溢出引起的攻防大战,以及 Union 的具体实现方式。
我们先来看看程序在内存中是如何组织的(x86-64 Linux):
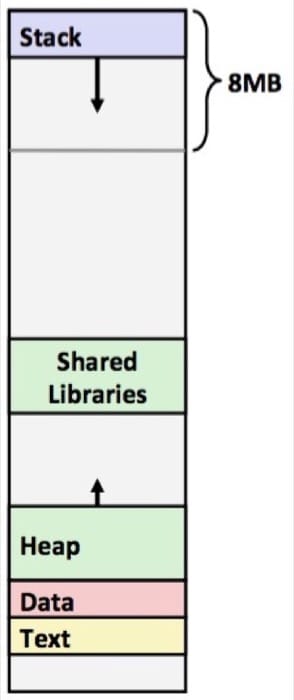
最上面是运行时栈,有 8MB 的大小限制,一般用来保存局部变量。然后是堆,动态的内存分配会在这里处理,例如 malloc(), calloc(), new() 等。然后是数据,指的是静态分配的数据,比如说全局变量,静态变量,常量字符串。最后是共享库等可执行的机器指令,这一部分是只读的。
看个具体分配的例子:
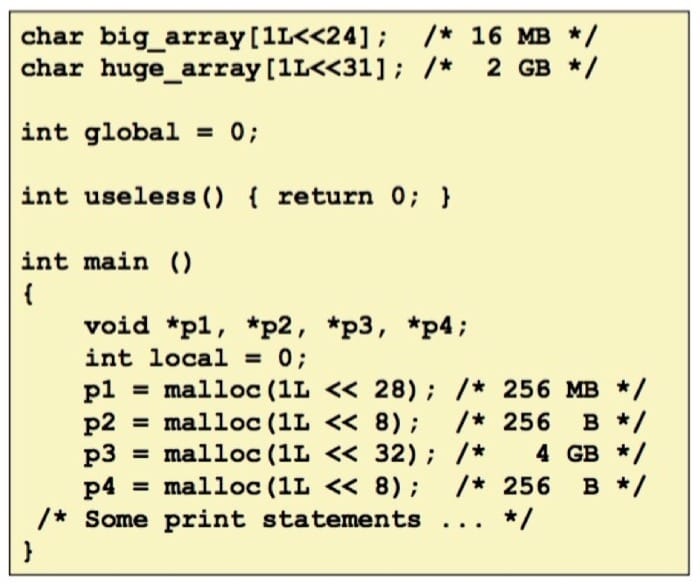
经过观察大概是这样的:
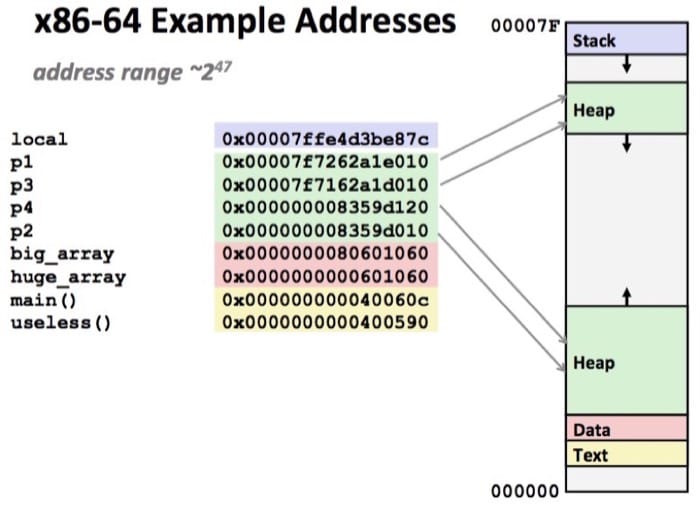
这里注意一点,分配堆的时候是两头分配的,到中间相遇的时候就说明没有空间了,具体是怎么在两头分配的呢?老师也表示不知道。
Buffer Overflow
缓冲区溢出需要注意两个方面,一是为什么会产生这种情况,二是在黑客利用这种漏洞来进行攻击时,能够怎么防范。
先看看之前提到过的例子:
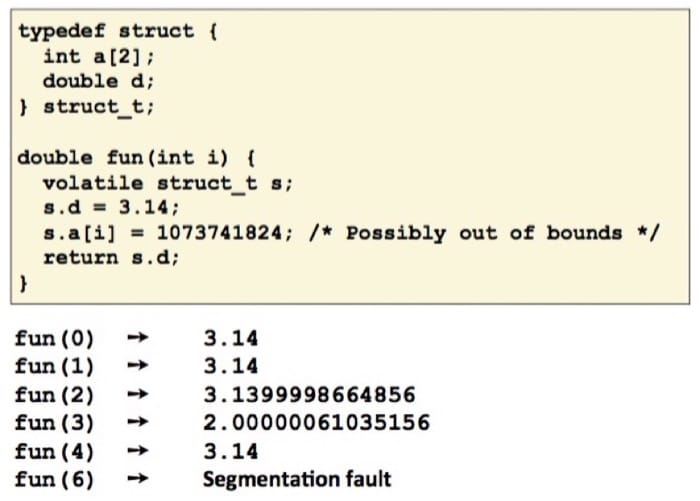
之所以会产生这种错误,是因为访问内存的时候跨过了数组本身的界限修改了 d 的值:
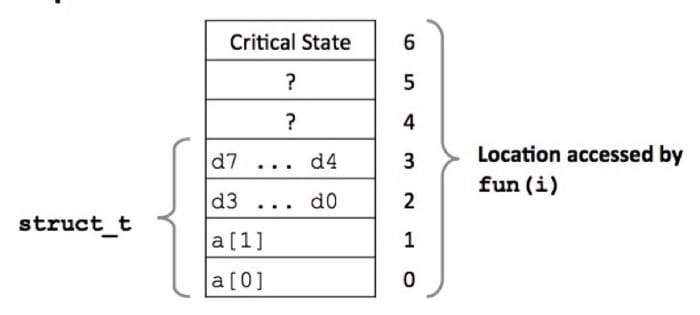
你没看错,这是个大问题!#1 technical cause of security vulnerabilities! #1 overall cause is social enginnering / user ignorance!
如果不检查输入字符串的长度,就很容易出现这种问题,尤其是针对在栈上有界限的字符数组。
在 Unix 中,gets() 函数的实现是这样的:
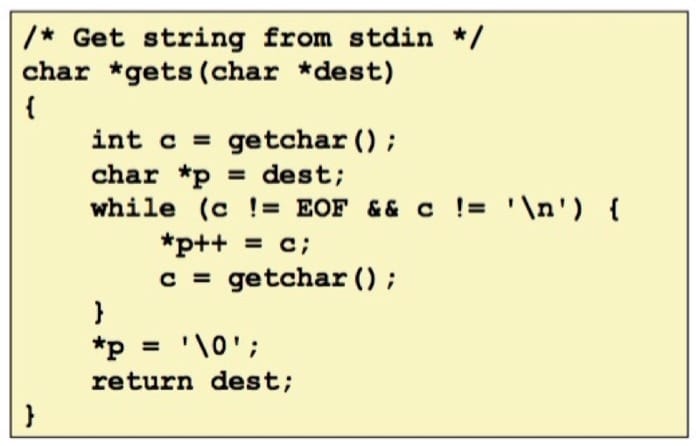
可以看到并没有去检测最多能读入多少字符(于是很容易出问题),类似的情况还在 strcpy, strcat, scanf, fscanf, sscanf 中出现。比如说
void echo() {
	char buf[4]; // 太小
	gets(buf);
	puts(buf);
}

void call_echo() {
	echo();
}
我们输入一长串,可以看到:
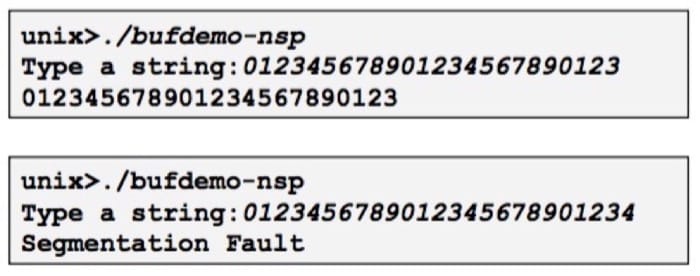
为什么明明只给了 4 个 char,居然一开始输入这么多都没问题?我们到汇编代码里去看看:
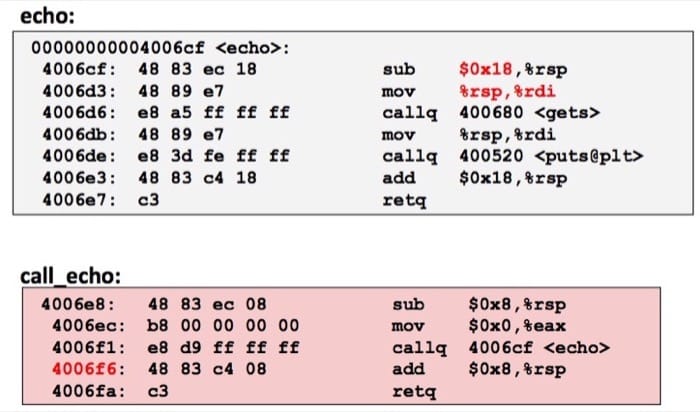
可以看到实际上是给 %rsp 分配了 0x18 的空间的。
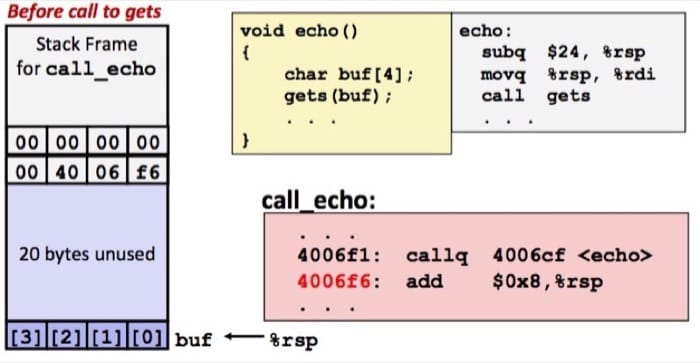
在调用之前,可以看到内存的摆放是这样的,但是调用了 call_echo 之后,就变成:
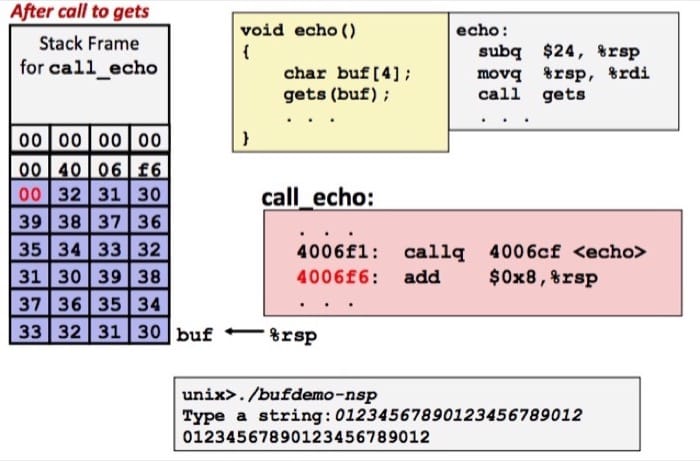
虽然缓冲区溢出了,但是并没有损害当前的状态,程序还是可以继续运行(也就是没有出现段错误),但是如果再多一点的话:
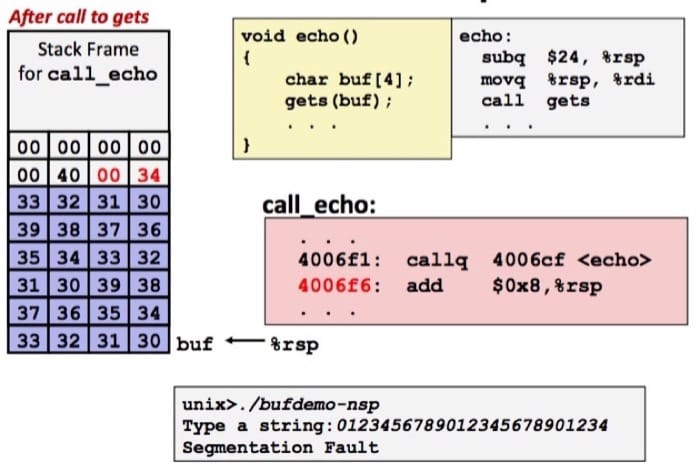
就把返回地址给覆盖掉了,但是段错误之后发现还可以继续运行,是因为返回代码会返回到 main 中,和具体的地址无关:
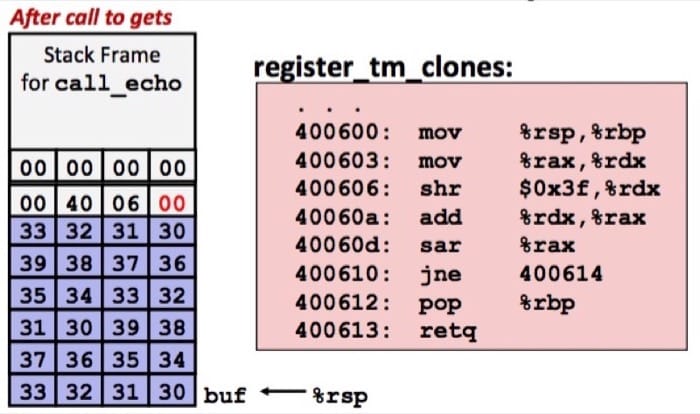
在这个例子中没有问题,但是在下面的例子中,就会出问题了
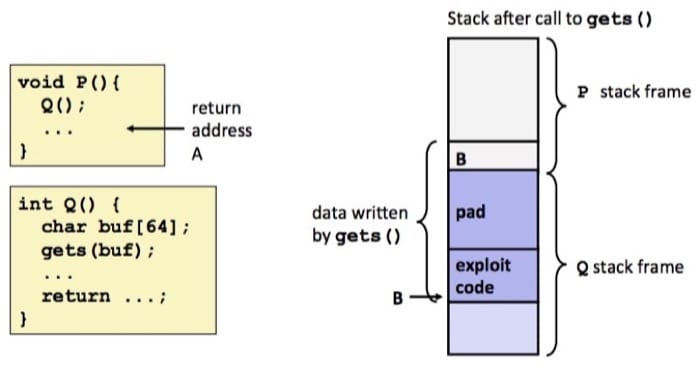
原本函数 P 的返回地址是 A,但是因为 Buffer 一直在被写,直接改到了 P 的栈帧,那么之后跳转就会跳转到奇怪的地方了。
那么我们现在来看看,怎么处理缓冲区溢出攻击,有几种方式:
- 好好写代码,尽量不让缓冲区异常
- 程序容易出问题,那么提供系统层级的保护
- 编译器也可以来个认证(stack canaries)
第一种,避免缓冲区溢出,我们用更安全的方法,如:fgets, strncpy 等等。
第二种,栈的位置不确定,让缓冲区溢出没办法影响到,并且每次位置都不一样,就不怕被暴力破解:
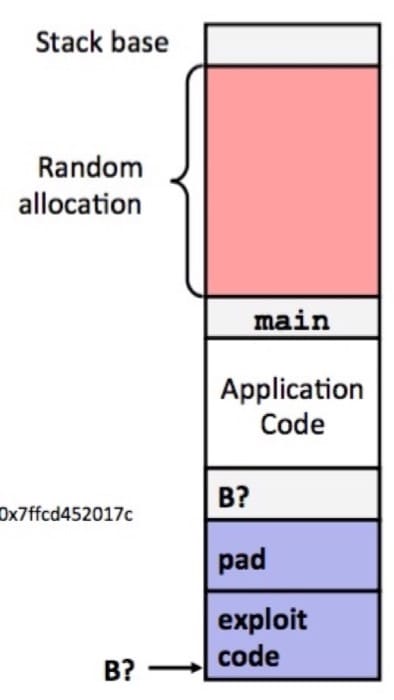
并且也可以把一段内存标记为只读,那么就避免因为缓冲区溢出而导致的重写。
第三种,使用 Stack Canaries。简单来说,就是在超出缓冲区的位置加一个特殊的值,如果发现这个值变化了,那么就知道出问题了。
但是,除了缓冲区溢出,还有另一种攻击的方式,就是把返回的位置给改了。可以利用修改已有的代码,来绕过系统和编译器的保护机制。这里就不详细展开了。
Unions
和结构体对应的一种结构,但是其实我在编程的时候感觉不是非常常见,这里简单了解下实现原理:
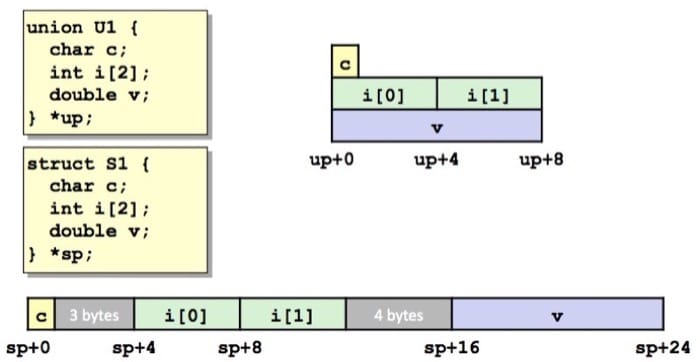
具体的拜访可以是:
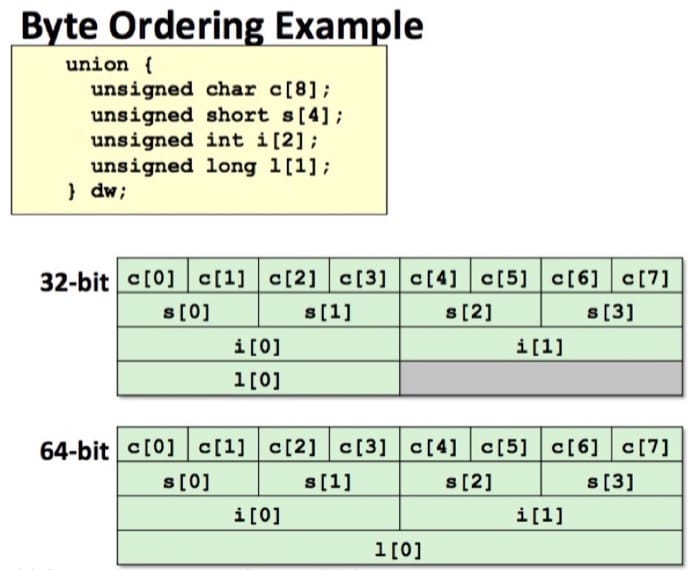
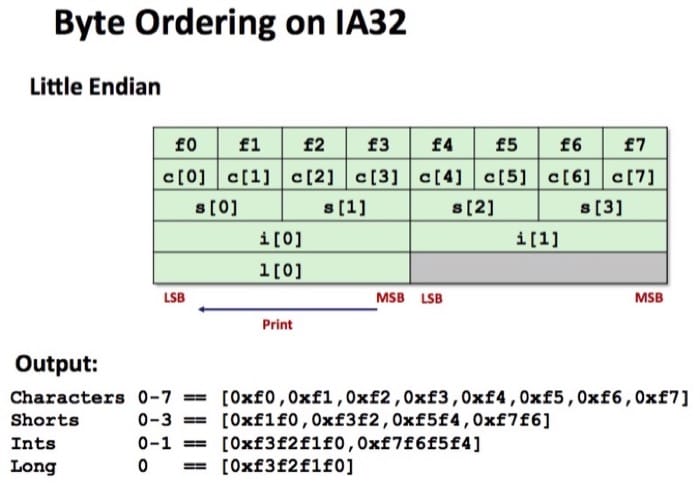
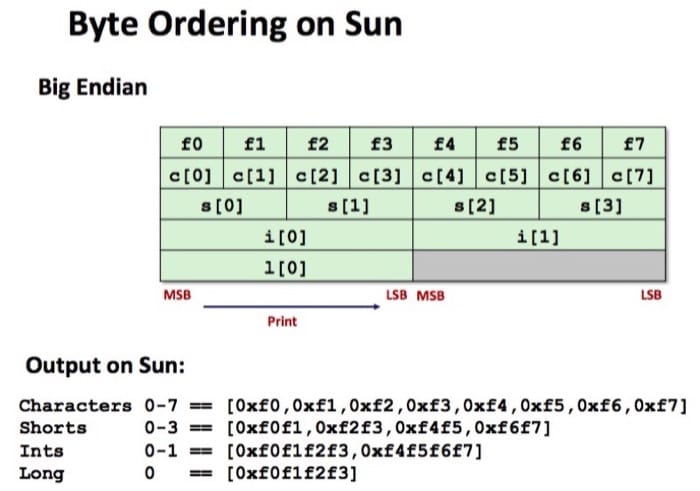
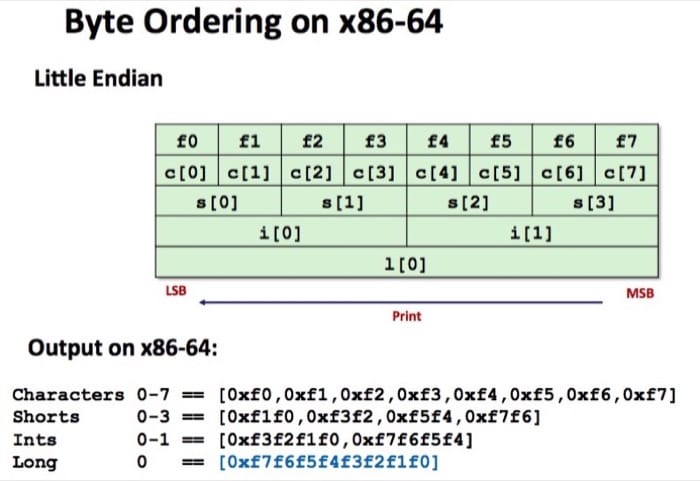
下面是三种不同系统上的排布:
这一讲的内容就到这里,下一讲是非常有趣的关于如何优化代码的内容,我自己都很期待。