深入理解计算机系统 第 7 课 Machine Data
本页目录
上一讲我们了解了过程调用是如何用机器代码实现的,这一讲我们来看看基本的数据是如何存储在计算机中的。
Arrays
数组其实就是连续分配的地址空间,比如说 T A[L],意思就是类型 T 且长度为 L 的数组,需要分配 L*sizeof(T) 个字节的空间。
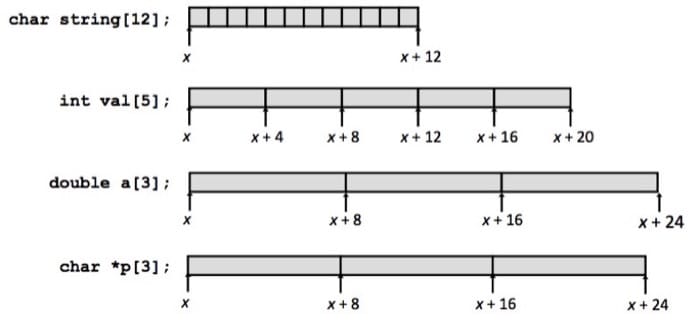
既然是连续的地址空间,就有很多不同的访问方式,举个例子:
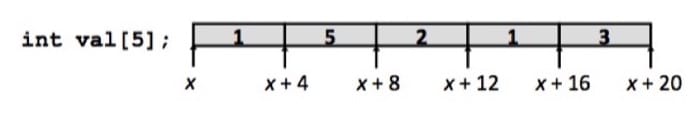
那么对应的一些访问方式为:
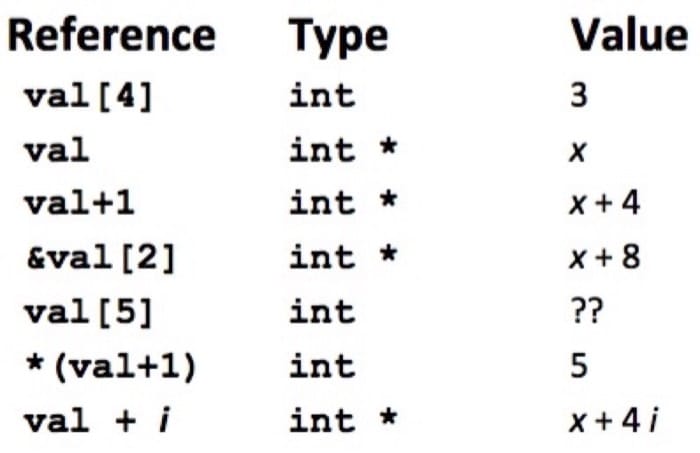
再举个例子:
#define ZLEN 5
typedef int zip_dig[ZLEN];

zip_dig cmu = { 1, 5, 2, 1, 3};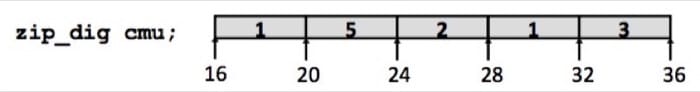
假设我们要取数组中的某一位:
int get_digit(zip_dig z, int digit){
	return z[digit];
}
对应的汇编代码是:
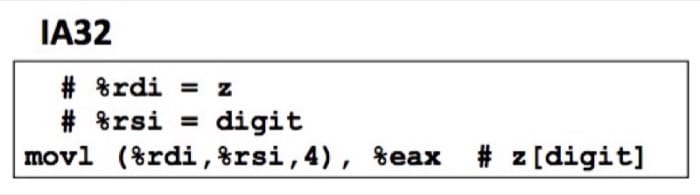
这里寄存器 %rdi 中存着数组的起始地址,寄存器 %rsi 存着序号,我们要访问的地址等价于 %rdi + 4*%rsi,用内存引用的方式就是 (%rdi, %rsi, 4)。
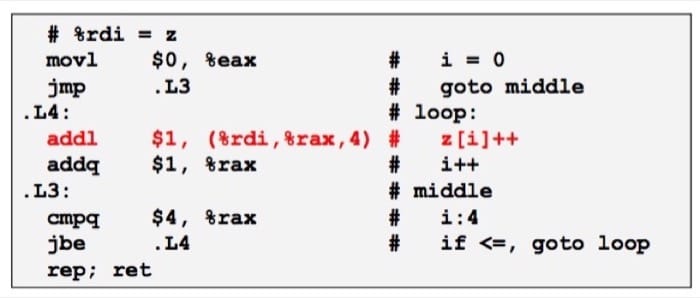
再看一个数组循环的例子:
void zincr(zip_dig z){
	size_t i;
	for (i = 0; i < ZLEN; i++)
		z[i]++;
}
对应的汇编是,注意红字的部分,相当于等价实现了 ++ 操作
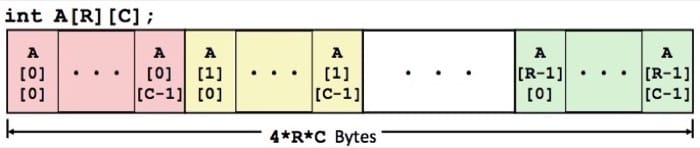
对于多维的数组,基本形式是 T A[R][C],R 是行,C 是列,如果类型 T 占 K 个字节的话,那么数组所需要的内存是 R*C*K 字节。具体在内存里的排列方式如下:
多维数组的第一维可以看作是每行起始的地址:
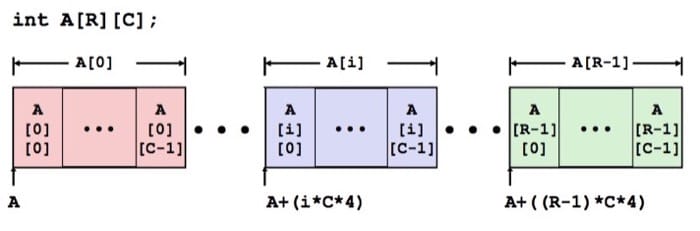
因为如此,所以访问可以是这样的:
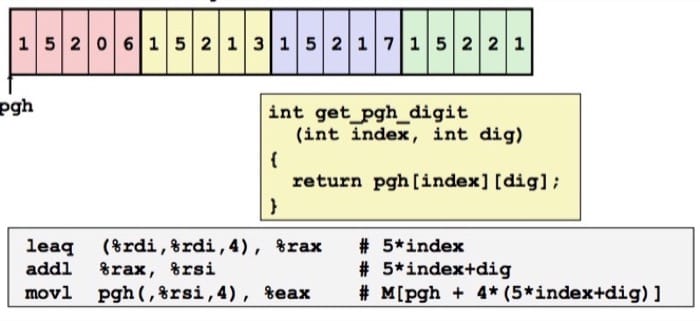
这里 pgh[index][dig] 是 int 类型。地址 pgh + 20*index + 4*dig = pgh + 4*(5*index + dig)。
还有另外一种组合数组的方式,不是连续分配,而是存储每个数组的起始地址,例如:
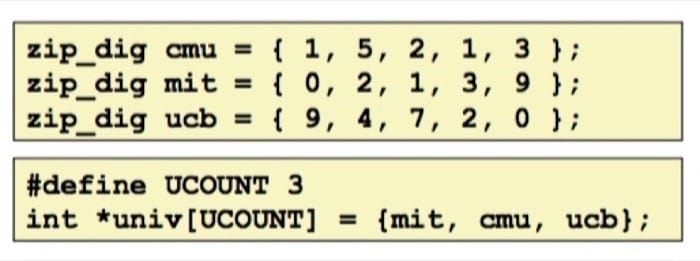
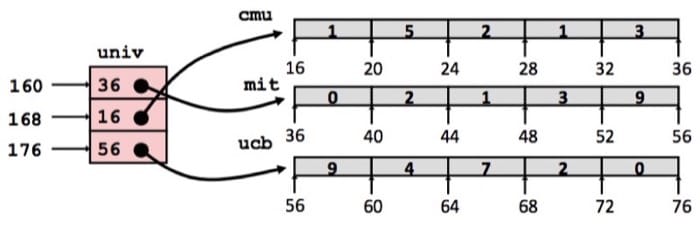
获取具体某个元素的地址其实就是计算时的起始地址有变换,对应的代码为:
int get_univ_digit(size_t index, size_t digit){
	return univ[index][digit];
}
汇编为:
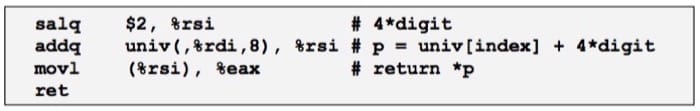
这里等同于进行两次内存访问 Mem[Mem[univ+8*index]+4*digit],
对比一下
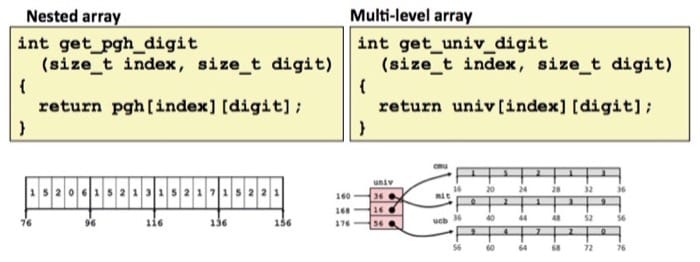
在 C 语言中看起来差不多,但是实际上差别很大:
Mem[pgh+20*index+4*digit] vs Mem[Mem[univ+8*index]+4*digit]
Structures
结构体是如何表示的呢,大概是这样:
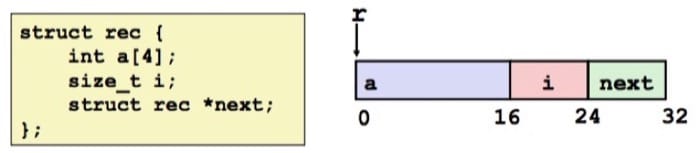
这里我们发现刚好都是 4 的倍数,如果换一种方式来组合,会是怎么样的呢?会像下图这样吗?
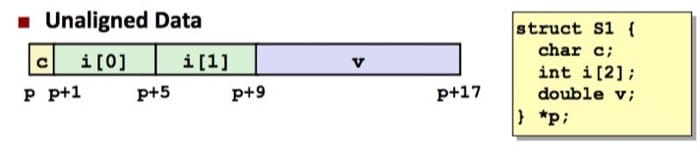
答案是,并不会,会在内存中进行对齐:
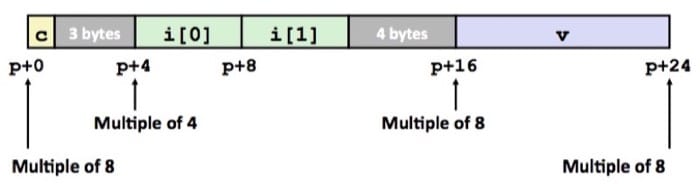
具体对齐的原则是,如果 primitive data type 需要 K 个字节,那么地址都必须是 K 的倍数。为什么要这样呢,因为内存访问通常来说是 4 或者 8 个字节位单位的,不对齐的话访问起来效率不高。具体来看的话,是这样:
- 1 字节:char, ...
- 没有地址的限制
- 2 字节:short, ...
- 地址最低的 1 比特必须是
- 4 字节:int, float, ...
- 地址最低的 2 比特必须是
- 8 字节:double, long, char *, ...
- 地址最低的 3 比特必须是
- 16 字节:long double (GCC on Linux)
- 地址最低的 4 比特必须是
对于一个结构体来说,所占据的内存空间必须是最大的类型所需字节的倍数,比如:
struct S2 {
	double v;
	int i[2];
	char c;
} *p;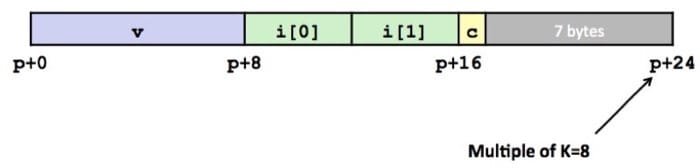
如果是结构体数组的话,那就是像这样:
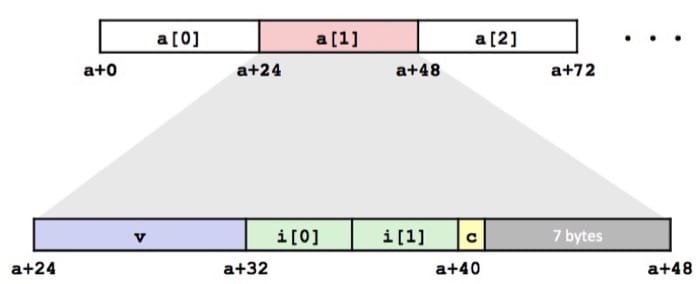
具体到访问结构体中的例子,如下:
struct S3 {
	short i;
	float v;
	short j;
} a[10];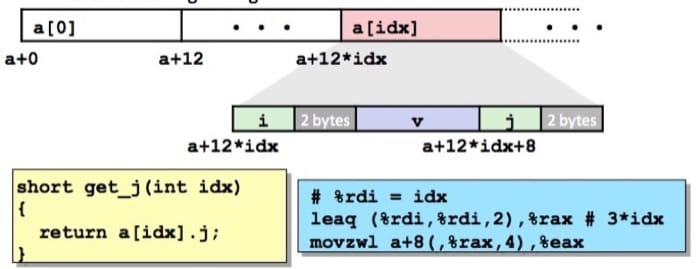
那么根据这种特点,就有一些技巧了。例如,要把大的数据类型放到前面,看这个例子:
struct S4 {
	char c;
	int i;
	char d;
} *p;

struct S5 {
	int i;
	char c;
	char d;
} *p;
那么这两种的对应排列就是:
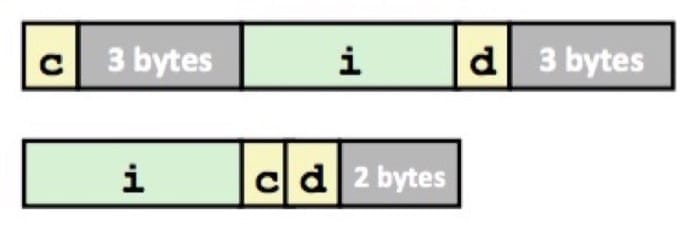
可以看到,下面那种省了 4 个字节。
Floating Point
浮点数的部分在课上介绍的不是很多,这里简要介绍一下。
最开始是 x87 FP(比较丑陋),之后是 SSE FP(利用了向量指令),然后是 AVX FP(类似与 SSE)。
SSE3 对于 XMM 寄存器一共有 16 个,每个 16 字节:
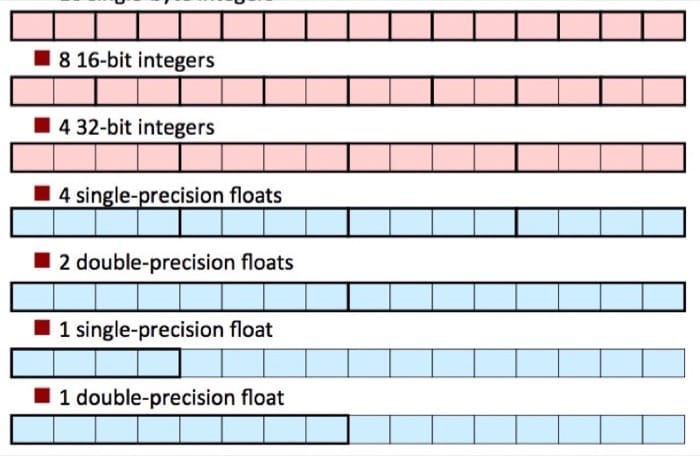
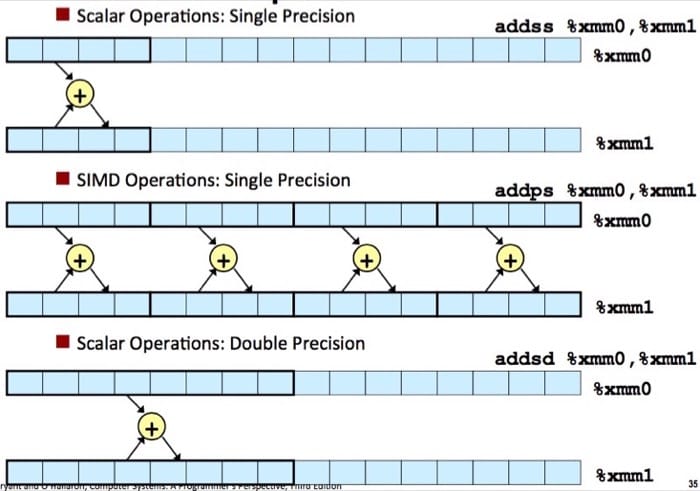
下面是对标量和 SIMD 操作的描述:
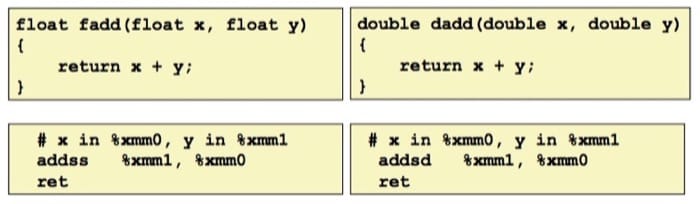
具体的机制也是类似的,传入的参数存储在 %xmm0, %xmm1,返回参数在 %xmm0,所有的 XMM 寄存器都会被保存在调用者的栈帧中:
这一讲到此结束,之后会进入更深入的话题(因为作业大概两到三周一次,所以可能先把重点放在概念的理解上)