深入理解计算机系统 第 11 课 Cache Memories
本页目录
上一讲我们了解了存储的相关知识,这节课我们来更加深入研究一下 cache memory 的知识。
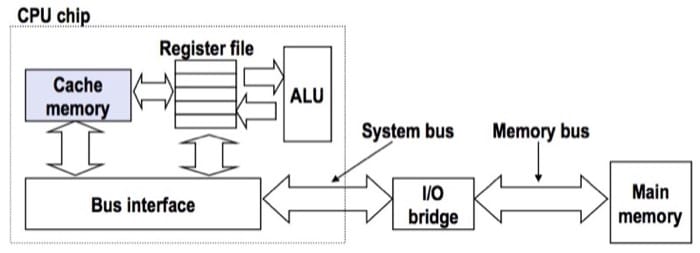
Cache memory 是由硬件自动管理的 SRAM 内存,CPU 会首先从这里找数据,其所处的位置如下:
General Cache Organization(S, E, B)
通常来说,是按照如下图所示的方式来组织的,一定要注意 S/E/B 具体在说什么:
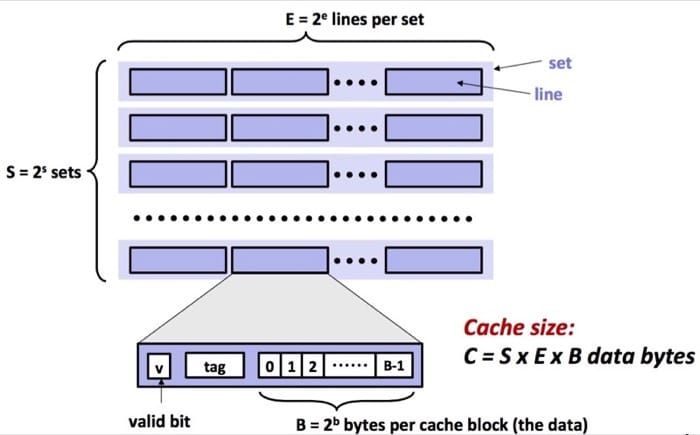
实际上可以理解为三种层级关系,对应不同的索引,这样分层的好处在于,通过层级关系简化搜索需要的时间,并且和字节的排布也是一一对应的(之后介绍缓存的时候就体现得更加明显)。
读入
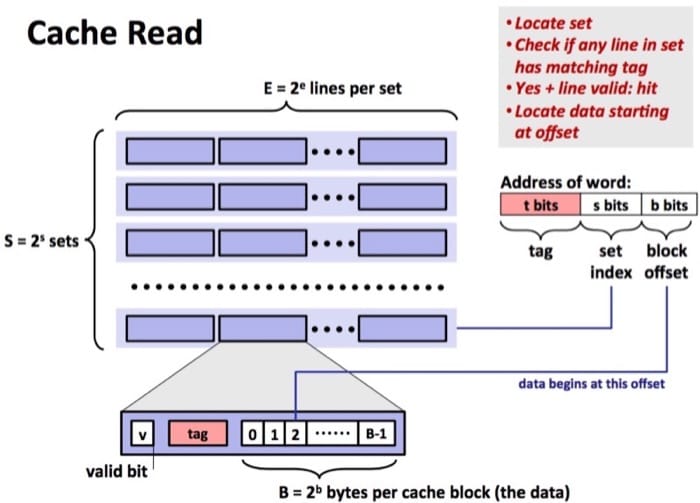
具体在从缓存中读取一个地址时,首先我们通过 set index 确定要在哪个 set 中寻找,确定后利用 tag 和同一个 set 中的每个 line 进行比对,找到 tag 相同的那个 line,最后再根据 block offset 确定要从 line 的哪个位置读起(这里的而 line 和 block 是一个意思)。
当 E=1 时,也就是每个 set 只有 1 个 line 的时候,称之为直接映射缓存(Direct Mapped Cache)。
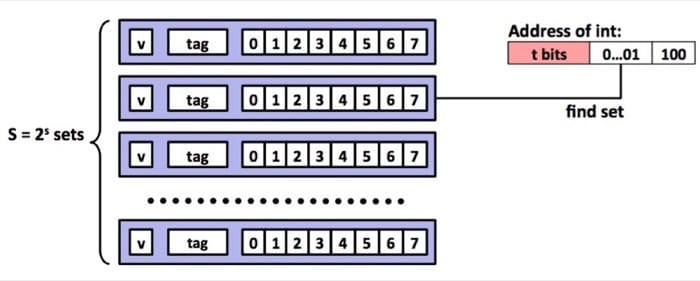
这种情况下,因为每个 set 对应 1 个 line,反过来看,1 个 line 就需要一个 set,所以 set index 的位数就会较多(和之后的多路映射对比)。具体的检索过程就是先通过 set index 确定哪个 set,然后看是否 valid,然后比较那个 set 里唯一 line 的 tag 和地址的 t bits 是否一致,就可以确定是否缓存命中。
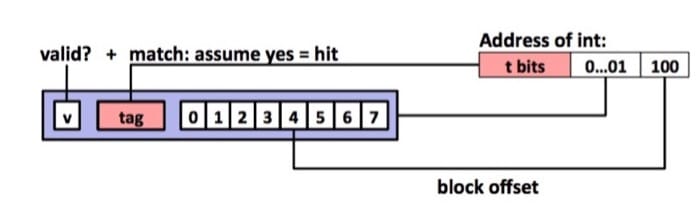
命中之后根据 block offset 确定偏移量,因为需要读入一个 int,所以会读入 4 5 6 7 这四个字节(假设缓存是 8 个字节)。如果 tag 不匹配的话,这行会被扔掉并放新的数据进来。
这里举一个具体的例子
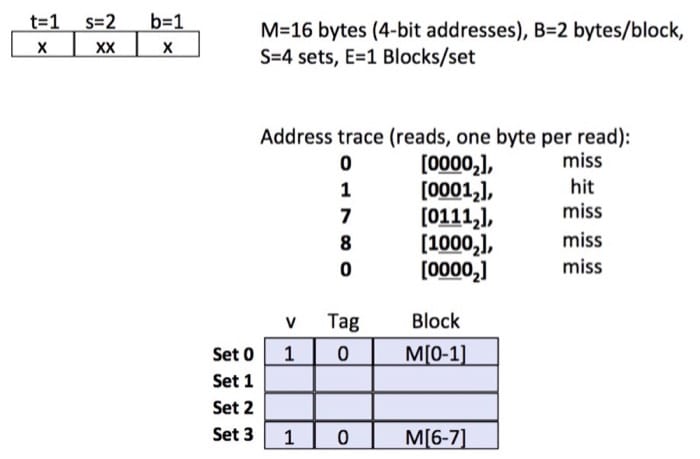
缓存的大小如图所示,对应就是有 4 个 set,所以需要 2 位的 set index,所以进行读入的时候,会根据中间两位来确定在哪个 set 中查找,其中 8 和 0,因为中间两位相同,会产生冲突,导致连续 miss,这个问题可以用多路映射来解决。
当 E 大于 1 时,也就是每个 set 有 E 个 line 的时候,称之为 E-way Set Associative Cache。这里用 E = 2 来做例子:
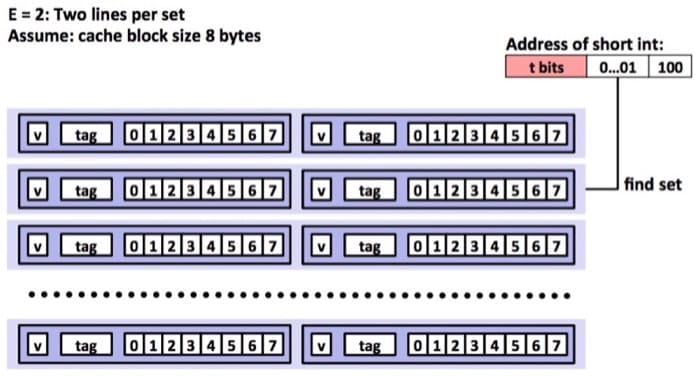
跟前面所说的一致,这里每个 set 有两个 line,所以就没有那么多 set,也就是说 set index 可以少一位(之后的例子可以看到)
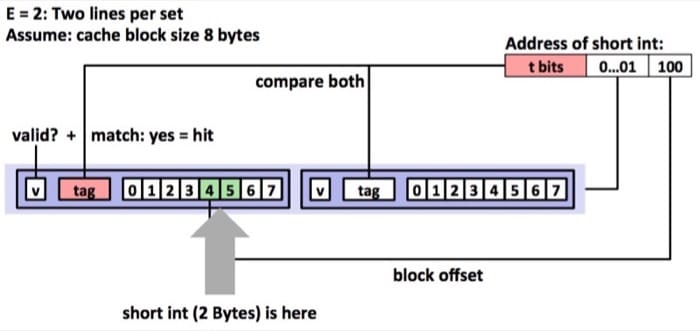
再简述一下整个过程,先从 set index 确定那个 set,然后看 valid 位,接着利用 t bits 分别和每个 line 的 tag 进行比较,如果匹配则命中,那么返回 4 5 位置的数据,如果不匹配,就需要替换,可以随机替换,也可以用 least recently used(LRU) 来进行替换。下面是一个具体的例子:
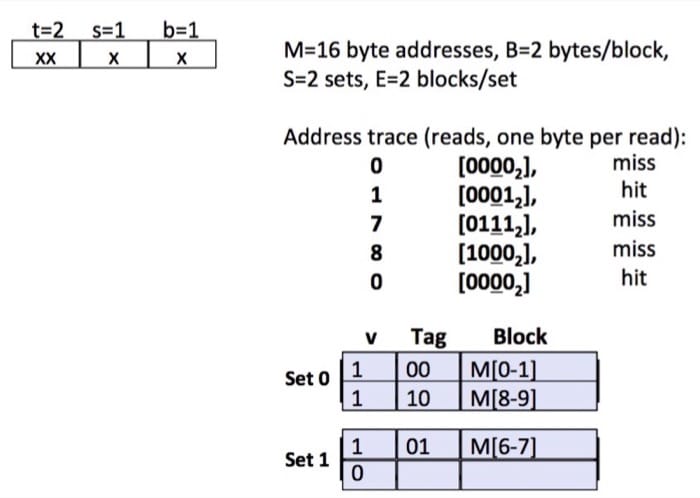
可以看到因为每个 set 有 2 个 line,所以只有 2 个 set,set index 也只需要 1 位了,这个情况下即使 8 和 0 的 set index 一致,因为一个 set 可以容纳两个数据,所以最后一次访问 0,就不会 miss 了。
写入
在整个 memory hierarchy 中,不同的层级可能会存放同一个数据的不同拷贝(如 L1, L2, L3, 主内存, 硬盘)。如果发生写入命中的时候(也就是要写入的地址在缓存中有),有两种策略:
- Write-through: 命中后更新缓存,同时写入到内存中
- Write-back: 直到这个缓存需要被置换出去,才写入到内存中(需要额外的 dirty bit 来表示缓存中的数据是否和内存中相同,因为可能在其他的时候内存中对应地址的数据已经更新,那么重复写入就会导致原有数据丢失)
在写入 miss 的时候,同样有两种方式:
- Write-allocate: 载入到缓存中,并更新缓存(如果之后还需要对其操作,这个方式就比较好)
- No-write-allocate: 直接写入到内存中,不载入到缓存
这四种策略通常的搭配是:
- Write-through + No-write-allocate
- Write-back + Write-allocate
其中第一种可以保证绝对的数据一致性,第二种效率会比较高(通常情况下)。
实例学习:Intel Core i7
Intel Core i7 的 cache hierarchy 如下图所示:
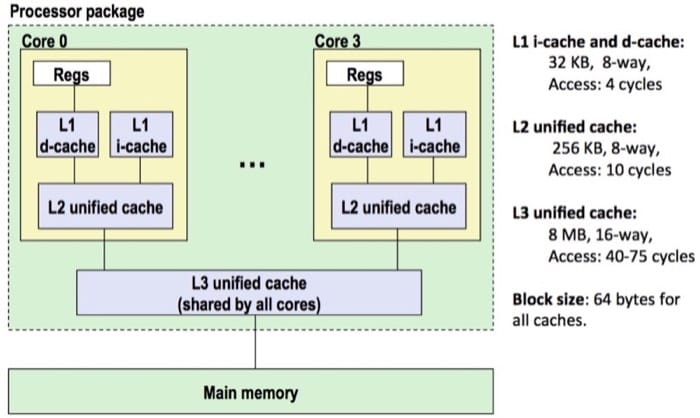
我们通常用如下的指标来评价缓存的性能:
- Miss Rate
- 1 - hit rate
- 对于 L1 来说一般 3-10%
- 对于 L2 来说很小 < 1%
- 也就是说大部分时间堆数据的访问都是极快的
- Hit Time
- 把 1 个 line 的缓存传输给处理器所用的时间,包括判断其是否在缓存中这个过程
- 对于 L1 来说一般 4 个时钟周期
- 对于 L2 来说一般 10 个时钟周期
- Miss Penalty
- 因为 miss 所需要花费的额外时间
- 一般来说需要 50-200 个时钟周期(因为要读内存,而且由于处理器速度越来越快,这个时间还在增长)
从前面的数据中,我们可以看出,hit 和 miss 所需要的时间是天壤之别(只看 L1 和主存的话,可能差 100 倍)。
还有一个比较有意思的现象是,99% 的命中率,是 97% 的命中率的性能的两倍。举个例子,假设缓存命中时需要 1 个周期,而 miss penalty 是 100 个周期,那么
- 97% hits: 1 cycle + 0.03 x 100 cycles = 4 cycles
- 99% hits: 1 cycle + 0.01 x 100 cycles = 2 cycles
这也是为什么我们用 miss rate 而不是 hit rate,因为更能体现出倍数的关系。
Memory mountain
我们用每秒从内存中读入的字节数目来衡量内存的性能(单位 MB/s),根据 spatial 和 temporal locality 的特性,我们可以画出一幅立体的表现性能走向的图,具体用的测试代码为:
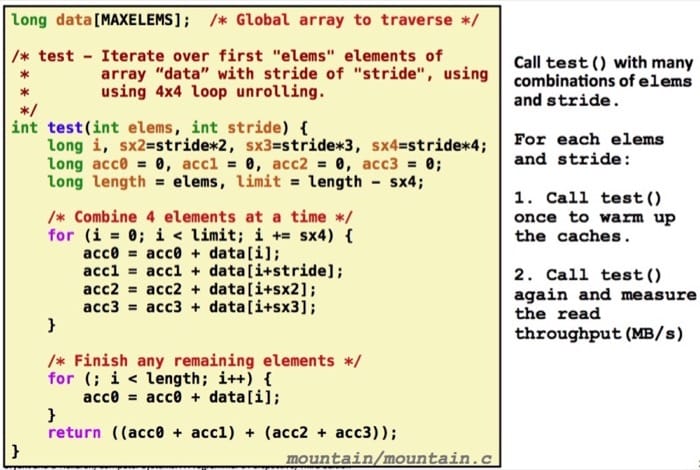
可以得到这么一幅图
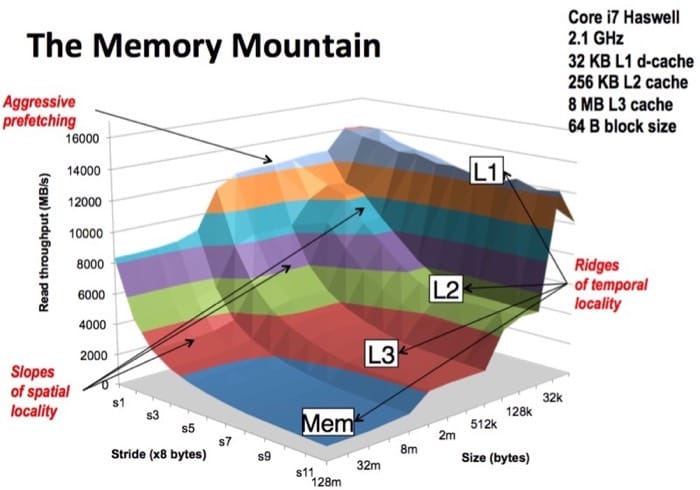
注意,这是根据 Core i7 得出来的图,不同的处理器可能因为不同的设计和架构而有所区别,但是可以通过不同的颜色和层次,看出不同 size 和 stride 对性能的影响。山脚是我们应该尽量避免的,山顶是我们力求达到的,也就是说,尽量一次访问一个 stride,一次读入的数据大小也不宜太大,最好和 L1 缓存数值上吻合。
矩阵相乘
矩阵相乘是学习缓存非常好的例子,这里给出一些条件:
- 两个 N x N 的矩阵相乘,N 非常大,所以可以认为 1/N 等于 0
- 矩阵的每个元素是 double,也就是 8 个字节
- 一共需要 次操作
- 源矩阵的每个元素需要被读入 N 次
- 目标矩阵的每个元素要被写入 N 次(相加),但是可以在寄存器中完成
- 缓存中每 1 个 line 的大小是 32 个字节(足够放下 4 个 double)
- 缓存可能至多能容纳矩阵的一行(甚至只能是一行的一部分)
更改循环顺序提高 spatial locality
一种算法是这样的
/* ijk */
for (i = 0; i < n; i++) {
    for (j = 0; j < n; j++){
        sum = 0.0;
        for (k = 0; k < n; k++)
            sum += a[i][k] * b[k][j];
        c[i][j] = sum;
    }
}
观察里面的循环,大概的访问模式是这样的:
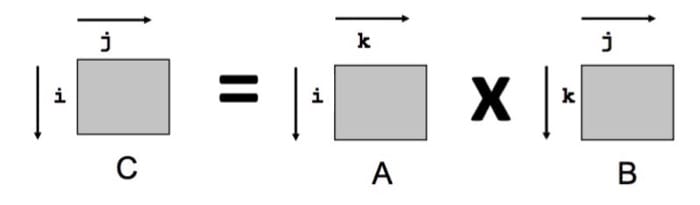
因为 C 语言是根据行来分配数组内存的,所以按照列的顺序来访问,可以得到最好的 spatial locality。假设我们需要读入 N 个连续的字节,如果缓存的 block 大小为 B 个字节,那么实际上真正需要去内存中访问是 N/B 次(这种时候会 miss)。但是如果按照行来访问,每次都是跳着来,miss rate 就是百分之百。
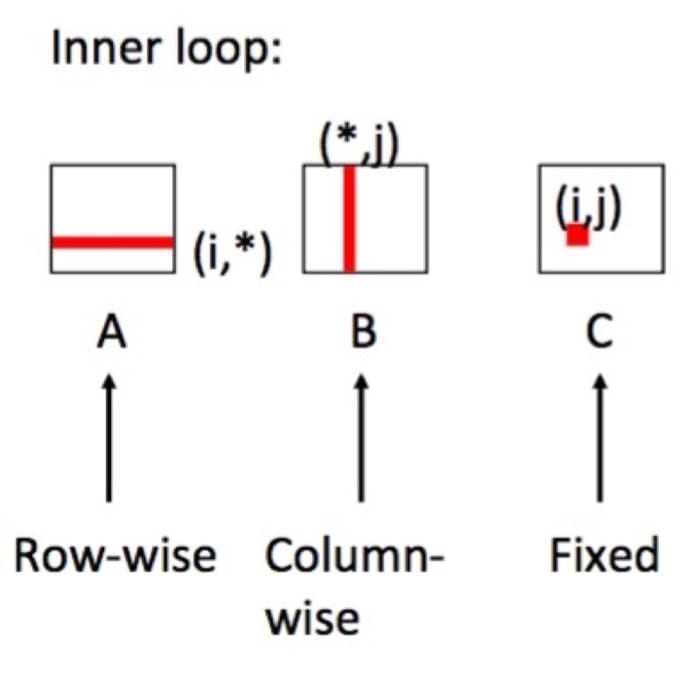
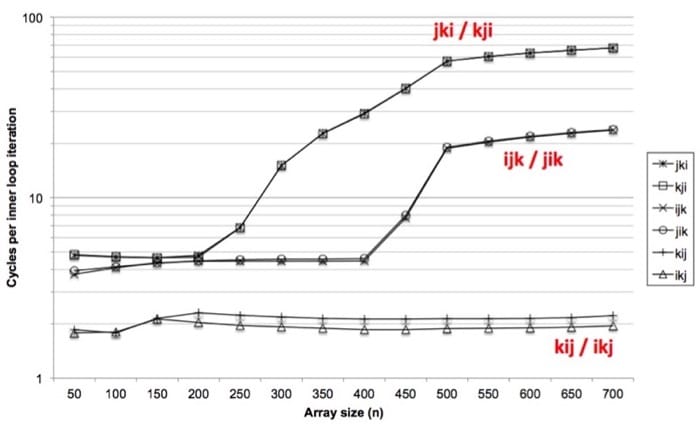
而 ijk 的访问模式,处理矩阵 A 的时候是按列访问的,因为这里设定一个 block 可以存放 4 个 double,读入每四个元素的情况下,我们只会在读入第一个 double 的时候 miss,所以对于矩阵 A 来说,内部的循环(就是 k 的那个循环)每次迭代平均会 miss 0.25 次(就是 1/4 次)。而访问矩阵 B 的时候,因为是按照行访问的,缓存实际上没有任何用,同样的条件下,每次迭代都会 miss。(我们还可以发现 jik 的访问模式和 ijk 很类似,这里略过)
但是如果换一下顺序,变成 kij 的访问模式,就会有不一样的变化,代码如下:
/* kij */
for (k = 0; k < n; k++){
    for (i =0; i < n; i++) {
        r = a[i][k];
        for (j = 0; j < n; j++)
            c[i][j] += r * b[k][j];
    }
}
对应的访问模式:
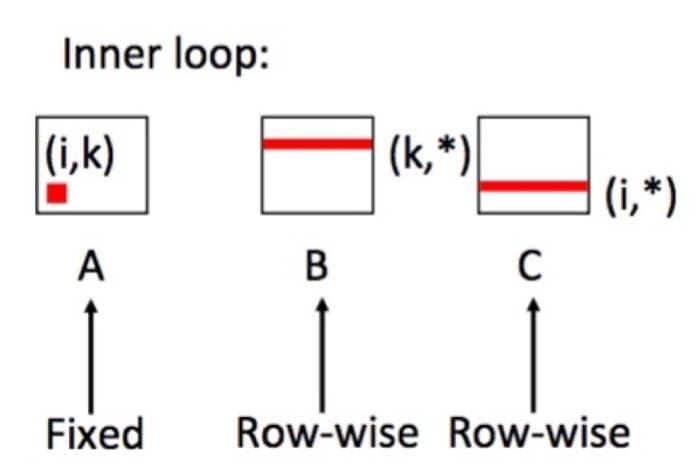
可以看到对于矩阵 B 和 C 来说都是按照列访问的(就是横着),所以内循环中每次迭代只会 miss 0.25 次(ikj 的访问模式也是如此)
当然还可以使用 jki 或 kji 的访问模式,这种模式下对于矩阵 A 和 C 的访问都是按行访问的(就是竖着),内循环中每次迭代都会 miss 1 次,是很糟糕的
比较一下:
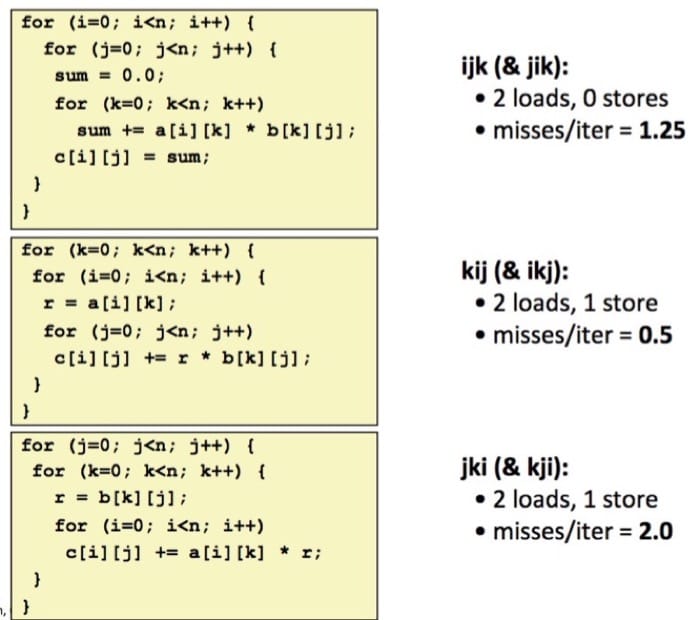
就可以发现不同的访问模式会产生巨大的影响,下面的表格更加能说明问题:
利用 blocking 提高 temporal locality
还是矩阵相乘的例子,先看代码
c = (double *) calloc(sizeof(double), n*n);

/* Multiply n x n matrices a and b */
void mmm(double *a, double *b, double *c, int n){
    int i, j, k;
    for (i = 0; i < n; i++)
        for (j = 0; j < n; j++)
            for (k = 0; k < n; k++)
                c[i*n + j] += a[i*n + k] * b[k*n + j];
}
我们假设矩阵的元素是 double,缓存的每个 line 可以容纳 8 个 double,整个缓存的大小 C 远小于 n。
对应的访问模式为:
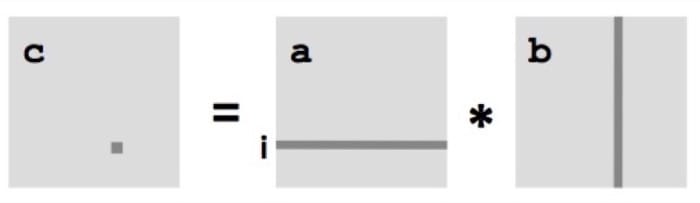
进行计算的时候,对于矩阵 a,因为是一行一行读取的,在读取第一个 double 的时候,后面 7 个也会被载入缓存(miss 数目为 n/8),但是对于矩阵 b,因为是一列一列读取的,所以每次都需要更新缓存(miss 数目为 n)
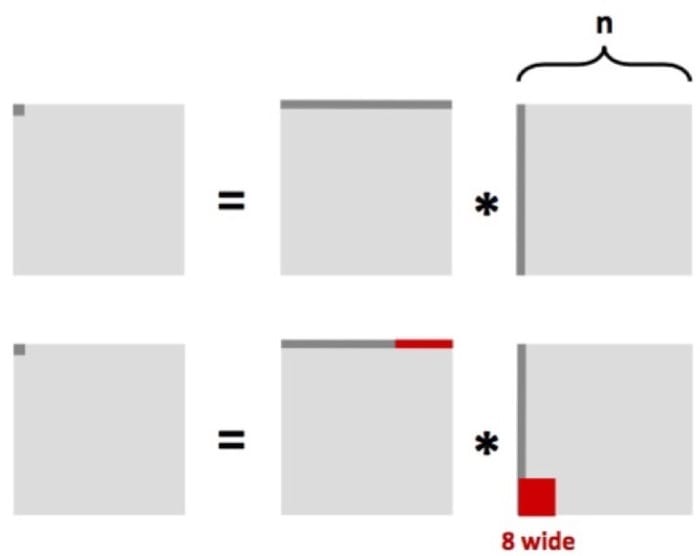
所以总的 miss 数目为:
但是如果我们把矩阵分成一块一块来计算,就会有不一样的效果:
c = (double *) calloc(sizeof(double), n*n);

/* Multiply n x n matrices a and b */
void mmm(double *a, double *b, double *c, int n){
    int i, j, k;
    int i1, j1, k1;
    for (i = 0; i < n; i+=B)
        for (j = 0; j < n; j+=B)
            for (k = 0; k < n; k+=B)
            /* B x B mini matrix multiplications */
                for (i1 = i; i1 < i+B; i1++)
                    for (j1 = j; j1 < j+B; j1++)
                        for (k1 = k; k1 < k+B; k1++)
                            c[i1*n+j1] += a[i1*n+k1] * b[k1*n + j1];
}
也就是如下图所示:
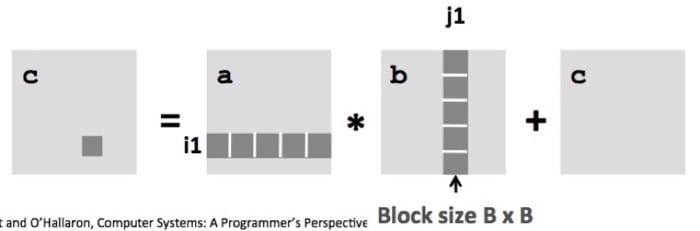
这里我们加一个条件,假设缓存中可以放下 3 个 Block,即 。
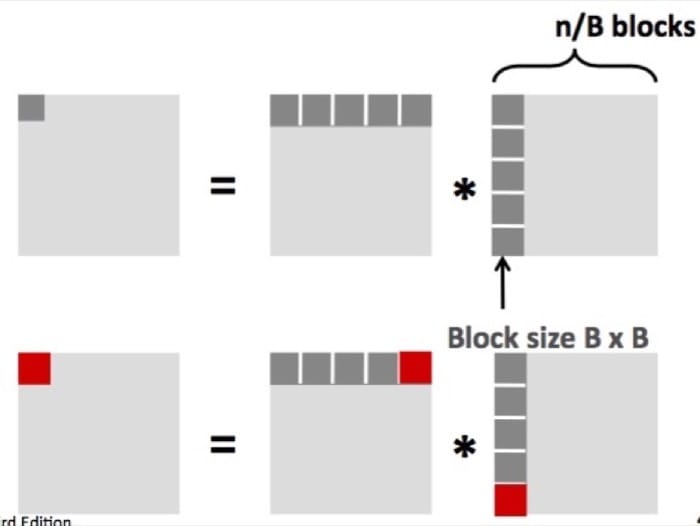
那么在计算的时候,这三个 Block 其实都可以放到缓存中。对于每个 Block 来说,一共有 个元素,8 个元素会 miss 一次,所以一共会 miss 次。而一次完整的计算(指算完整行乘以整列),矩阵 a 和 b 都需要读入 个 block,所以总的 miss 数目是 (这里的 2n 是因为矩阵 a 和 b 各有 n/B 个 Block)。
而对于整个矩阵 c 来说,一共有 个 block,所以整个计算过程的 miss 数目为:
比较一下,一个是 ,另一个是 ,有巨大的差异!,但是需要保证的就是 (所以需要针对机器进行调整)
总结下
- Cache memories 对性能会有极大的影响
- 写代码的时候可以考虑
- 关注内循环,尤其是访问元素的顺序和方向
- 以 stride 1 的顺序来访问可以最大化 spatial locality
- 尽可能多利用读入的数据(重复使用)来最大化 temporal locality