深入理解计算机系统 第 10 课 Memory Hierarchy
本页目录
从这一讲开始我们会介绍有关存储的知识(估计前面的汇编已经看得够呛了吧),个人的感觉来说会稍微轻松一些,但是概念比较多,一定要弄清楚再继续。
RAM
按照 Sheldon 的做法,我们当然要从历史说起,了解存储设备所用的技术以及发展趋势,对我们理解内存层级背后的原因很有帮助。
RAM(Random-Access Memory) 有两种类型:SRAM(Static RAM) 和 DRAM(Dynamic RAM),SRAM 非常快,也不需要定期刷新,通常用在处理器做缓存,但是比较贵;DRAM 稍慢一点(大概是 SRAM 速度的十分之一),需要刷新,通常用作主内存,相比来说很便宜(是 SRAM 价格的百分之一)。
无论是 DRAM 还是 SRAM,一旦不通电,所有的信息都会丢失。如果想要让数据持久化,可以考虑 ROM, PROM, EPROM, EEPROM 等介质。固件程序会存储在 ROM 中(比如 BIOS,磁盘控制器,网卡,图形加速器,安全子系统等等)。另外一个趋势就是 SSD 固态硬盘,取消了机械结构,更稳定速度更快更省电。
硬盘
传统的机械硬盘有许多不同的部件:
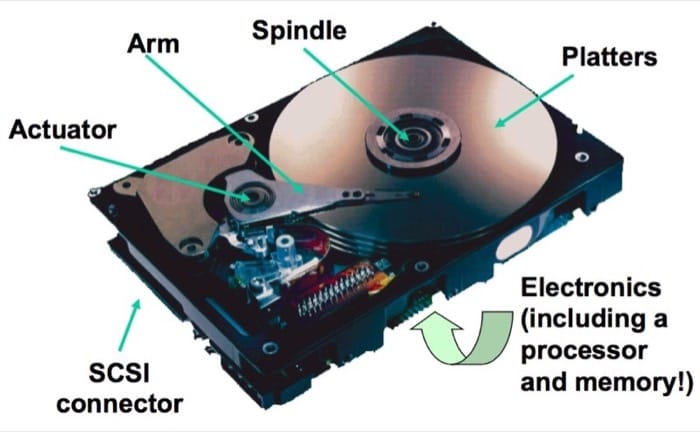
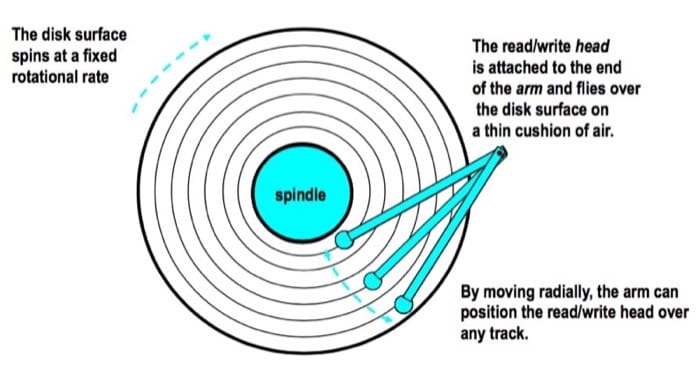
虽然现在越来越多电脑已经改为使用固态硬盘,但是还是有必要了解一下硬盘的组成的。首先需要知道是,机械硬盘有许多片 platter 组成,每一片 platter 有两面;每一面由一圈圈的 track 组成,而每个 track 由 gap 分隔成不同的 sector。这里概念层层递进,可以结合下图仔细辨析清楚。
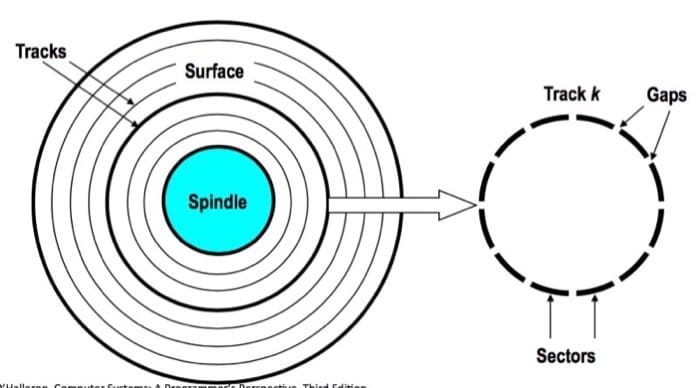
上图是一个 platter 的视图,多个 platter 组合起来是这样的:
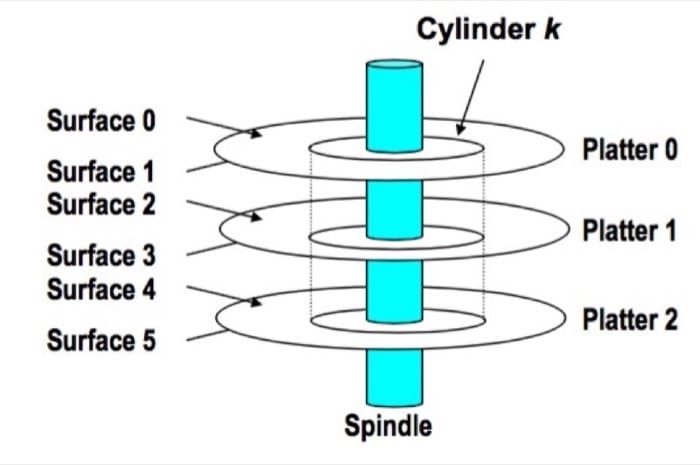
硬盘的容量指的是最大能存储的比特数,通常用 GB 来做单位。1 GB 相当于 10 的 9 次方个 Byte。与硬盘的结构分层类似,容量取决于下面三个方面:
- 记录密度(bits/in):track 中 1 英寸能保存的字节数
- Track 密度(tracks/in):1 英寸直径能保存多少条 track
- Areal 密度(bits/in 的平方):上面两个数值的乘积
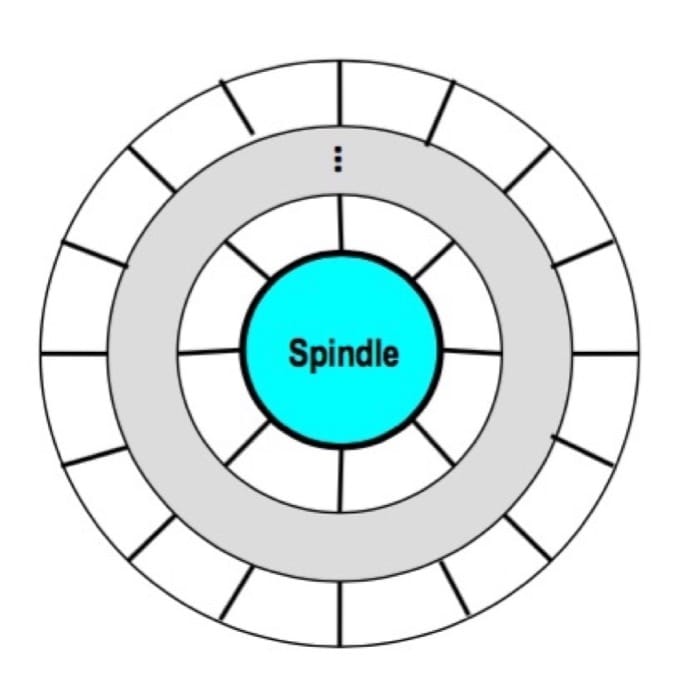
现在硬盘会把相邻的若干个 track 切分成小块,每一块叫做 recording zones。 recording zone 中的每个 track 都包含同样数量的 sector;但是每个 zone 中包含的 sector 和 track 的数目是不一样的,外层的更多,内层的更少;正因为如此,我们计算容量是,用的是平均的数值。
容量 Capacity = (# bytes/sector) x (avg. # sectors/track) x (# tracks/surface) x (# surfaces/platter) x (# platters/disk)
举个例子,假如一个硬盘有:
- 512 bytes/sector
- 300 sectors/track (平均)
- 20000 tracks/surface
- 2 surfaces/platter
- 5 platters/disk
总的容量为 = 512 x 300 x 20000 x 2 x 5 = 30,720,000,000 = 30.72 GB
具体的工作模式大概是这样的:
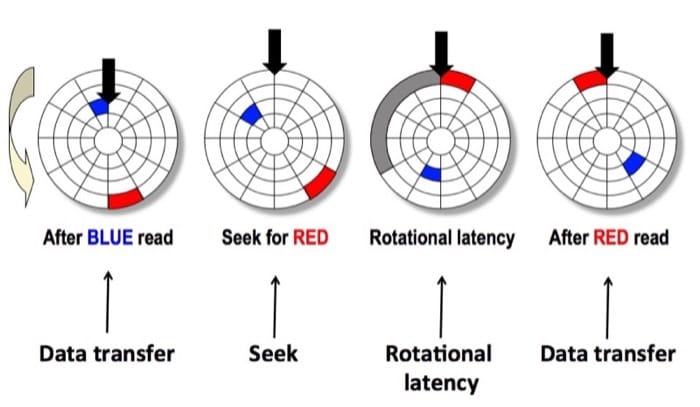
假设我们现在已经从蓝色区域读取完了数据,接下来需要从红色区域读,首先需要寻址,把读取的指针放到红色区域所在的 track,然后等待磁盘旋转,旋转到红色区域之后,才可以开始真正的数据传输过程。
总的访问时间 Taccess = 寻址时间 Tavg seek + 旋转时间 Tavg rotation + 传输时间 Tavg transfer
- 寻址时间 Tavg seek 因为物理规律的限制,一般是 3-9 ms
- 旋转延迟 Tavg rotation 取决于硬盘具体的转速,一般来说是 7200 RPM
- 传输时间 Tavg tranfer 就是需要读取的 sector 数目
举个例子,假设转速是 7200 RPM,平均寻址时间 9ms,平均每个 track 的 sector 数目是 400,那么我们有:
- Tavg rotation = 1/2 x (60 secs / 7200 RPM) x 1000 ms/sec = 4 ms
- Tavg transfer = 60 / 7200 RPM x 1/400 secs/track x 1000 ms/sec = 0.02 ms
- Taccess = 9 ms + 4 ms + 0.02 ms
从这里可以看出,主要决定访问时间的是寻址时间和旋转延迟;读取一个 sector 的第一个 bit 是非常耗时的,之后的都几乎可以忽略不计;硬盘比 SRAM 慢 40,000 倍,比 DRAM 慢 2500 倍。
最后需要知道的就是逻辑分区和实际的物理分区的区别,为了使用方便,会用连续的数字来标志所有可用的 sector,具体的映射工作由磁盘控制器完成。
接下来介绍一下固态硬盘,大概的结构如下:
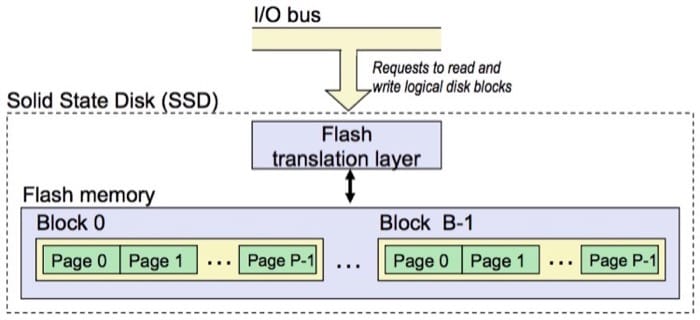
固态硬盘中分成很多 Block,每个 Block 又有很多 Page(大约 32-128 个),每个 Page 可以存放一定数据(大概 4-512KB),进行数据读写的最小单位,就是 Page,但是有一点需要注意,对一个 Page 进行写入操作的时候,需要先把整个 Block 清空(设计限制),而一个 Block 大概在 100,000 次写入之后就会报废。
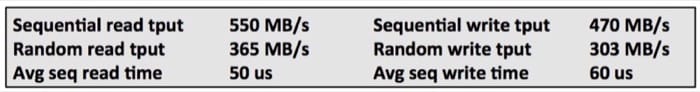
与传统的机械硬盘相比,固态硬盘在读写速度上有很大的优势。但是因为设计本身的约束,连续访问会比随机访问快,而且如果需要写入 Page,那么需要移动其他 Page,擦除整个 Block,然后才能写入。现在固态硬盘的读写速度差距已经没有以前那么大了,但是仍然有一些差距。
不过与机械硬盘相比,固态硬盘存在一个具体的寿命限制,价格也比较贵,但是因为速度上的优势,越来越多设备开始使用固态硬盘。
总线
总线是用来传输地址、数据和控制信号的一组平行的电线,通常来说由多个设备共享,类似于不同城市之间的高速公路,可以传输各类数据。CPU 通过总线和对应的接口来从不同的设备中获得所需要的数据,放入寄存器中等待运算,像下面这样:
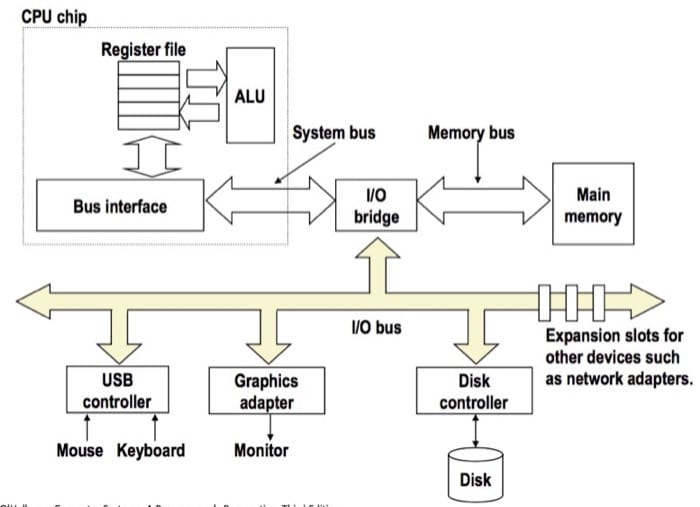
假设 CPU 需要从硬盘中读取一些数据,会给定指令,逻辑块编号和目标地址,并发送给磁盘控制器。然后磁盘控制器会读取对应的数据,并通过 DMA(direct memory access)把数据传输到内存中;传输完成后,磁盘控制器通过 interrupt 的方式通知 CPU,然后 CPU 完成之后的工作。
总线上连接的各个设备,其访问速度有天壤之别,不同的技术发展速度不同,更加剧了这个情况:
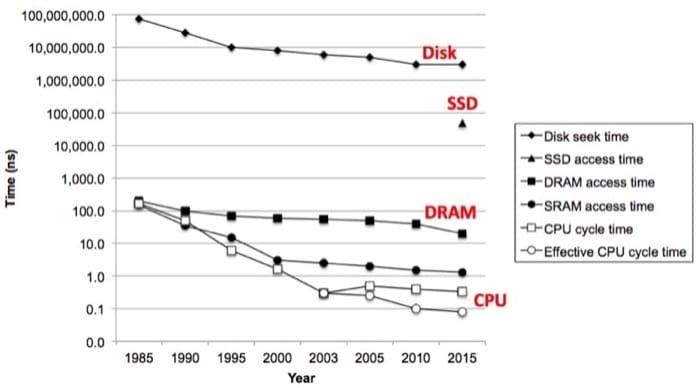
比方说磁盘的读写速度,30 年大概只提高了一个数量级多一点,所以固态硬盘的出现,以下拯救了劳苦大众(提高了两个数量级),DRAM 的发展,一路从 DDR12345 发展来,速度大概提高了一个数量级,不过 SRAM 则是在同一个起点愣是多跑了一个数量级,总体来说是跟着 CPU 的发展走的。不过 CPU 的发展在 2003 年也遇到了问题(单个核心基本到极限),不过多核的出现以及技术优化,总体来说还是使得执行速度越来越快。
那么这么大的时间差距,怎么办呢?难道根据木桶理论,都要取决于最慢的那个吗?不一定!Locality 可以在一定程度上拯救世界。
Locality
Locality 的思路很简单,就是如果一个数据最近被访问过,很可能还会被再次访问:
- Temporal locality: Recently referenced items are likely to be referenced again in the near future
- Spatial locality: Items with nearby addresses tend to be referenced close together in time
举个例子:
sum = 0;
for (i = 0; i < n; i++){
    sum += a[i];
}
return sum;
这里每次循环都会访问 sum,是 temporal locality;而访问数组是连续访问的,是 spatial locality。
根据这个特性,在写遍历数组的时候(尤其是高维),尤其要注意按照内存排列顺序来访问,不然性能会惨不忍睹。
Memory Hierarchy
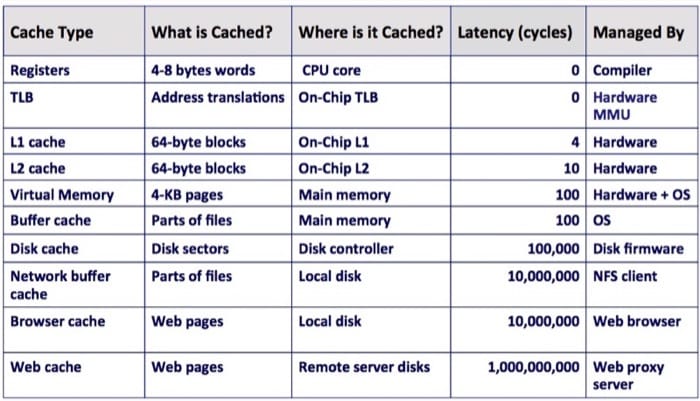
一种介质的速度越快,就会越贵,同时也消耗更多的电量,所以一般容量比较小。而 CPU 和内存之间的速度差距越来越大,所以好的程序都会尽可能利用 locality。根据这些特性,也就引申出了一个安排存储的方式,称为 memory hierarchy。
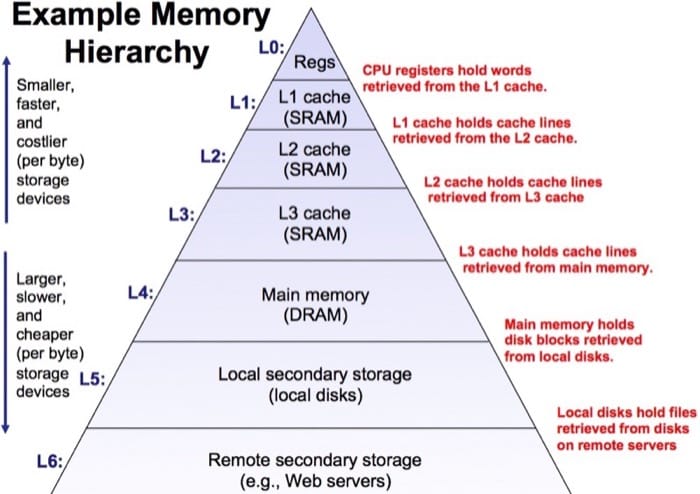
这里就涉及到一个技术:缓存。缓存可以看作是把大且缓慢的设备中的数据的一部分拿出来存储到其中的更快的存储设备。在 memory hierarchy 金字塔中,每一层都可以看作是下一层的缓存。利用 locality,程序会更倾向于访问第 k 层的数据,而非第 k+1 层,这样就减少了访问时间。
The memory hierarcy creates a large pool of storage that costs as much as the cheap storage near the bottom, but that serves data to programs at the rate of the fast storage near the top.
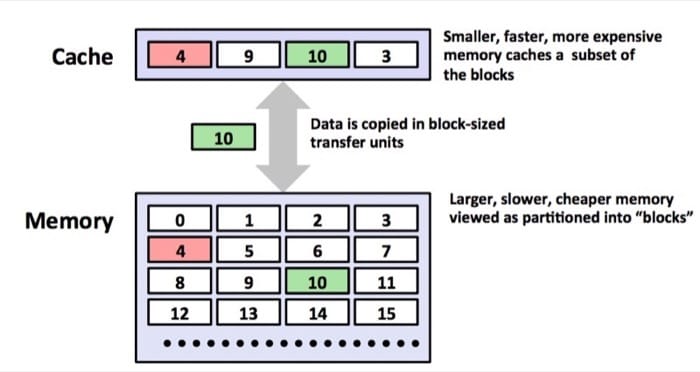
在上图中,假如程序请求的是 10,那么 10 正好在缓存中,即 cache hit,就可以节约时间。但是如果程序请求的是 12,因为 12 不在缓存中,即 cache miss,就必须从内存中获取,并替换缓存中的某个数据(具体替换哪一个,由 placement policy 和 replacement policy 决定)
Cache Miss
Cache miss 有三种:
- Cold(compulsory) Miss: CPU 第一次访问相应 cache 块,cache 中肯定没有该 cache 块,这是不可避免的
- Confilict Miss: 在直接相联或组相联的 cache 中,不同的 cache 块由于 index 相同相互替换,引起的失效叫做冲突失效
- 假设这里有 32KB 直接相联的 cache
- 如果有两个 8KB 的数据需要来回访问,但是这两个数组都映射到相同的地址,cache 大小足够存储全部的数据,但是因为相同地址发生了冲突需要来回替换,发生的失效则全都是冲突失效(第一次访问失效依旧是强制性失效),这时 cache 并没有存满
- Capacity Miss: 有限的 cache 容量导致 cache 放不下而被替换出 cache 块,被替换出去的 cache 块再被访问,引起的失效叫做容量失效
- 假设这里有 32KB 直接相联的 cache
- 如果有一个 64KB 的数组需要重复访问,数组的大小远远大于 cache 大小,没办法全部放入 cache。第一次访问数组发生的失效全都是强制性失效。之后再访问数组,再发生的失效则全都是容量失效,这时 cache 已经存满,容量不足以存储全部数据