云计算 第 15 课 分区和复制
本页目录
之前我们做的是计算能力的伸缩拓展,这次我们也要对数据库做类似的事情,并且通过具体的场景,来了解键值对存储的应用特点。特别鸣谢瓜瓜 @jiexing 的点拨,不然我就卡在自己脑洞里出不来了。
学习目标
- 了解分布式键值对存储的设计空间和动机
- 比较在键值对存储中使用复制和分区的异同及优劣
- 利用复制或分区机制来拓展分布式键值对存储
- 了解并实现一致性哈希算法,并借此说明其在分布式键值对存储中的分区起到的作用
- 把复制和分区技术应用到现实场景中
一致性哈希算法的要求很简单:
在任何时候,对于同一个 key,要返回同一个 value
理论上的要求很简洁,但具体实现的时候就会有需要细节了,比方说如何平均分配不同的 key,如果处理错误的状况等等。
背景知识
随着互联网、电子商务和社交媒体的快速发展,很多公司都不得不面对日益增长的数据量。如何存储、处理和分析这些数据越来越成为巨大的挑战。因为数据量已经远超一台机器可以承载的范围,我们需要分布式可拓展的存储系统。这里我们会专注于分布式键值对存储系统(也是 NoSQL 存储系统)。键值对存储系统支持两个基本操作:
PUT请求,把一条记录放到数据库中GET请求,从数据库中获取指定数据
分布式键值对存储包含多个节点(可能不在一个地方),一个比较常见的做法是利用最近的服务器来处理对应请求以减少延迟。
说到数据库的扩展性,我们可以通过下面的视频来进行基本的了解
下面是视频中的要点:
- Vertical Scaling:提高硬件和软件配置(CPU, Memory, Disk, Network)
- 优势:迁移简单,使用已有的软件
- 限制:硬件成本快速增长,可能最强大的硬件也不够用
- Horizontal Scaling:从一台数据库服务器扩展为数据库服务器集群,有下面两种机制来进行
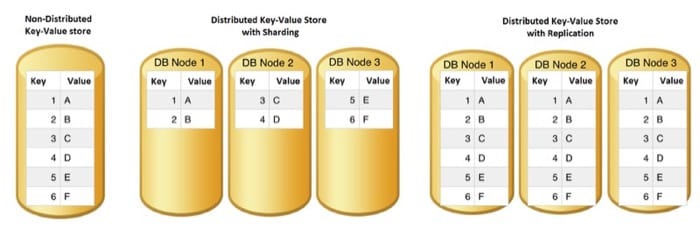
- Replication 复制:每台数据库服务器都有同样的数据,读数据的时候没有问题,写数据的时候需要考虑数据同步的问题。对读数据性能要求较高的应用可以采用这种机制。
- Sharding 分区:每台数据库服务器保存部分的数据库文件,需要决定什么时候访问哪台服务器,需要一个分区表。具体的分隔可以以行来分(Horizontal Partitioning)或者以列来分(Vertical Partitioning)。对写数据性能要求较高的应用可以采用这种机制。
这两个机制各有侧重点,这里简要介绍一下。
Replication
对于复制机制来说,每次更新数据,都需要把改动『广播』到所有的节点上以保证数据一致性,如果系统的容错性要求很高,那么复制机制可能是比较好的选择,下图是一个例子:
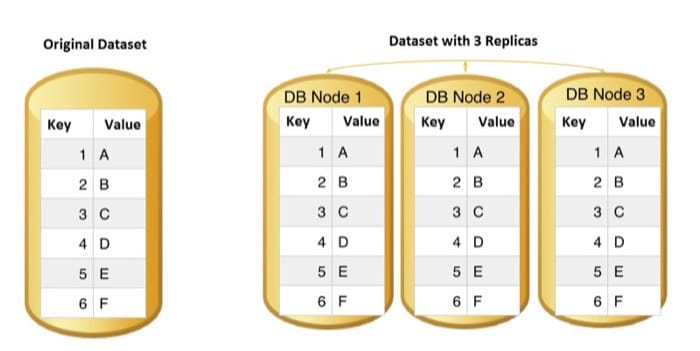
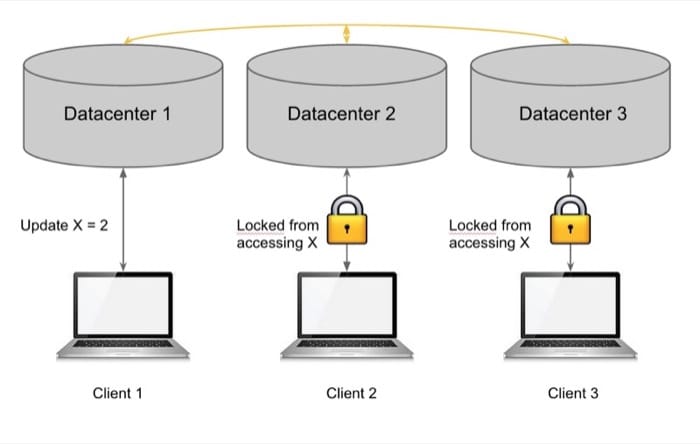
在复制的情况下,主要的优化机制是提供不同级别的一致性保证。在一个数据库节点的某条记录被修改时,其他数据库中对应的记录是不可访问的,直到三个数据库的数据完全同步之后才可以,如下:
并且,操作的不同顺序也会以时间戳的方式进行记录和排序,为了保证强一致性,需要保证任何时候从任何复制节点读取的数据都是一样的,具体的规则如下表所示
| 属性 | 解释 |
|---|---|
| 强一致性 | 任何时候从任何复制节点中相同的 key 对应相同的 value |
| 严格排序 | 按时间顺序处理请求 |
| 原子操作 | 所有的操作都应该是原子的,不能同时更新 |
| 访问控制 | 一个 key 在被更新时其他节点中的对应 key 不能访问 |
Sharding
对于分区机制来说,可以直接用下图来描述与复制机制的区别(比较简单这里不详细介绍)
背景设定
简单来说就是要做一个支持 PUT 和 GET 的分布式键值对存储系统,保存以下两种数据:
- 销售记录:保存支付密码等关键交易信息,一定要非常安全,不能轻易丢失。用户也会频繁访问购买历史,所以会有很多
GET的操作,于是会采用复制机制 - 匿名日志:包含页面访问及歌曲收听记录等匿名日志,只会在用户行为分析的时候使用,并且对于安全性的要求没那么高,反而是会有很多
PUT的操作,所以会利用分区机制。
整个系统的设计如下:
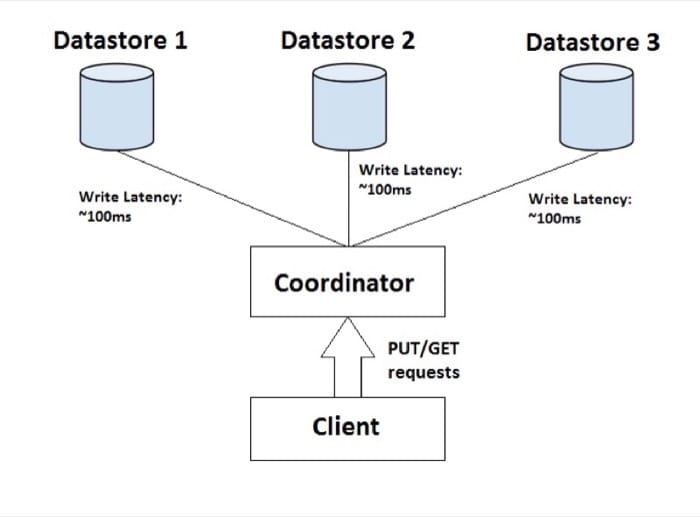
每个 datastore 已经帮我们配置好了,所以不必修改,我们需要做的就是折腾好 Coordinator 部分,也就是接收请求并转发给合适的 datastore
Coordinator
具体的实现包含两个部分,分别对应前面提到的两种不同的需求。具体的需求如下
- 并发执行
- 利用多线程来并行处理不同的请求,已经提供了框架代码
- 确定的行为
- 不会出现竞争条件,利用各种保证并行安全的技术来实现
- 非阻塞
PUT操作- 具体参考下面的图示
- 严格排序
- 根据请求到来的顺序处理请求,已有的代码是包含时间戳的
- 无缓存 Coordinator
- 在处理请求的过程中临时保存请求是可以的,但是不能有持久的缓存
- 动态策略
- Coordinator 应该支持后端的变动
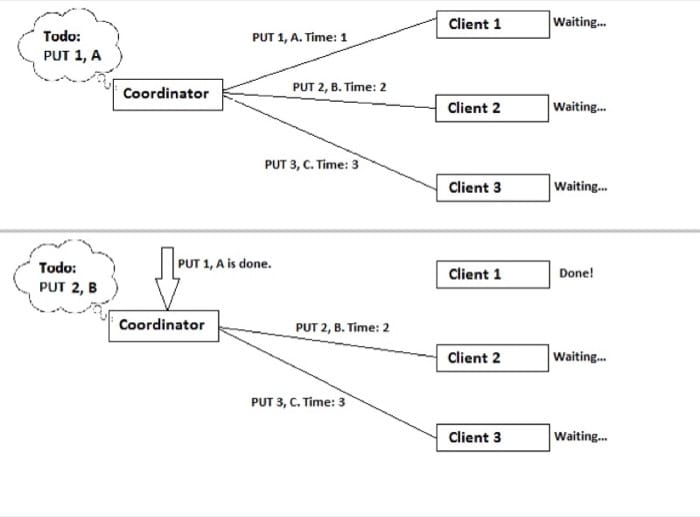
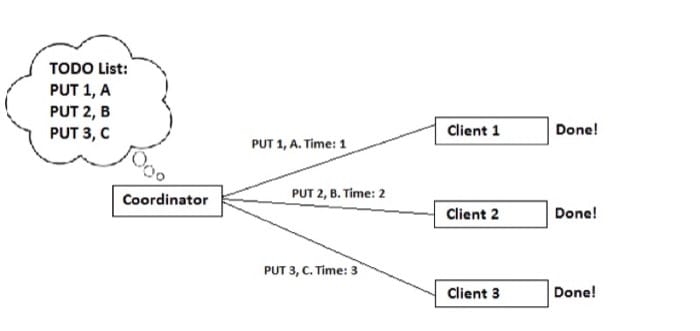
任务简介
- 打上标签:
Project: 3.2 - Datastore:
ami-83ba8ae9,t1.micro - Coordinator:
ami-17a4947d,t1.micro - Client:
ami-a05d60ca,m1.small
具体步骤
- 开启 3 个 datastore 实例,注意允许 8080 端口的访问
- 在浏览器中访问
http://[DATASTORE-DNS]:8080/test来测试 datastore 是否正常运行 - 开启 1 个 coordinator 实例,在
/home/ubuntu/Project3_2/vertx/bin/可以看到一个Coordinator.java文件,我们主要会在这里完成代码 - 使用命令
./vertx run Coordinator.java来启动 coordinator - 第一部分工作我们需要拓展
Coordinator.java来完成复制机制 - 第二部分工作我们需要完成分区机制
访问接口
http://[Coordinator-DNS]:8080/storage?storage=TYPE_OF_STORAGE- 指定需要支持的存储类型(复制与分区),用来设置具体不同的模式
http://[Coordinator-DNS]:8080/put?key=KEY&value=VALUE- 接收键值对并保存在 datastore 实例中
http://[Coordinator-DNS]:8080/get?key=KEY&loc=LOCATION- 接收需要查询的 key,并包含指定的获取位置(1/2/3 为对应的序号),在分区机制中,如果指定的实例没有对应的 value,那么返回 0,如果没有指定获取位置,那么就根据哈希的结果从对应的实例中获取
- 不同线程可以同时访问这些 API
我们还提供了一个辅助类 KeyValueLib,可以在 Coordinator.java 中访问:
KeyValueLib.PUT(String datastoreDNS, String key, String value)- 把键值对保存到对应的实例中
KeyValueLib.GET(String datastoreDNS, String key)- 从指定的实例中得到对应 key 的 value
在设计 Coordinator 时,可以认为:
- GET 操作的延时是可以忽略的
- 可以认为 datastore 实例不会出现崩溃的状况,一旦
KeyValueLib.PUT方法执行完成,那么对应的实例上的操作也完成,所以需要的同步机制不会太复杂。提示:不需要实现 Two-Phase Commit (2PC) 机制
线程同步策略
整个项目中最重要的是两个事情:数据一致性与严格顺序。严格顺序比较好完成,利用时间戳做评测标准使用优先队列来处理即可,因为需要保证非阻塞,所以针对复制机制,大概的流程如下(这个思路是不对的,或者说增加了无谓的复杂度,具体会另开一个反思课说明):
- 每个 key 都应该有自己的优先队列,来缓存可能需要等待的请求,并借此保证顺序(队列的操作应该是线程安全的,需要上锁)
- 每来一个请求,就会根据请求类型的不同在不同的
handle方法中处理 - 每个 key 都应该有自己的锁,这样不会影响到其他 key 的访问,这里使用
HashMap来存储 - 每次来一个请求,都需要先加入对应 key 的队列
- 在新开的线程,如果写操作正在进行,从队列中取出第一个请求进行操作,读取的话就上读锁,写入的话就上写锁
- 如果是写入的话,需要同步到其他两台机器
- 如果是读取的话,因为读锁是允许并发的,所以不需要为三个不同的数据库设计保存不同的锁,没有指定那个数据库的话,就随便访问一个即可
- 如果获取的时候没有对应的 key,返回 0
针对分区机制,大概的流程如下(这个思路是不对的,或者说增加了无谓的复杂度,具体会另开一个反思课说明):
- 每个请求需要根据 key 来进行哈希,确定所在的数据库编号
- 每来一个请求,就会根据请求类型的不同在不同的
handle方法中处理 - 每次来一个请求,都需要先加入对应 key 的队列
- 每个 key 都应该有自己的锁,这样不会影响到其他 key 的访问,这里使用
HashMap来存储 - 在新开的线程,如果写操作正在进行,从队列中取出第一个请求进行操作,读取的话就上读锁,写入的话就上写锁
- 每个 key 都应该有自己的优先队列,来缓存可能需要等待的请求,并借此保证顺序(队列的操作应该是线程安全的,需要上锁)
- 获取的时候,如果指定的实例没有对应的 value(也就是和哈希出来的数据库编号不一致),那么返回 0
- 如果获取的时候没有对应的 key,返回 0
PriorityBlockingQueue
PriorityBlockingQueue里面存储的对象必须是实现Comparable接口。队列通过这个接口的compare方法确定对象的priority。
规则是:当前和其他对象比较,如果compare方法返回负数,那么在队列里面的优先级就比较高。
PriorityBlockingQueue队列添加新元素时候不是将全部元素进行顺序排列,而是从某个指定位置开始将新元素与之比较,一直比到队列头,这样既能保证队列头一定是优先级最高的元素,又能减少排序带来的性能消耗。每取一个头元素时候,都会对剩余的元素做一次调整,这样就能保证每次队列头的元素都是优先级最高的元素。
下面是 Thinking in Java 中的一个例子 - 使用PriorityBlockingQueue进行任务按优先级同步执行:
import java.util.ArrayList;
import java.util.List;
import java.util.Queue;
import java.util.Random;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.PriorityBlockingQueue;
import java.util.concurrent.TimeUnit;


class PrioritizedTask implements Runnable, Comparable<PrioritizedTask>
{
    private Random rand = new Random(47);
    private static int counter = 0;
    private final int id = counter++;
    private final int priority;

    protected static List<PrioritizedTask> sequence = new ArrayList<PrioritizedTask>();

    public PrioritizedTask(int priority)
    {
        this.priority = priority;
        sequence.add(this);
    }

    @Override
    public int compareTo(PrioritizedTask o) {
        //复写此方法进行任务执行优先级排序
//      return priority < o.priority ? 1 :
//          (priority > o.priority ? -1 : 0);
        if(priority < o.priority)
        {
            return -1;
        }else
        {
            if(priority > o.priority)
            {
                return 1;
            }else
            {
                return 0;
            }
        }
    }

    @Override
    public void run() {
        //执行任务代码..
        try {
            TimeUnit.MILLISECONDS.sleep(rand.nextInt(250));
        } catch (InterruptedException e) {

        }
        System.out.println(this);
    }

    @Override
    public String toString() {
        return String.format("[%1$-3d]", priority) + " Task id : " + id;
    }

    public String summary()
    {
        return "( Task id : " + id + " _priority : " + priority + ")";
    }

    /**
     * 结束所有任务
     */
    public static class EndSentinel extends PrioritizedTask
    {
        private ExecutorService exec;
        public EndSentinel(ExecutorService e) {
            super(Integer.MAX_VALUE);
            exec = e;
        }

        public void run()
        {
            int count = 0;
            for(PrioritizedTask pt : sequence)
            {
                System.out.print(pt.summary());
                if(++count % 5 == 0)
                {
                    System.out.println();
                }
            }
            System.out.println();
            System.out.println(this + "Calling shutdownNow()");
            exec.shutdownNow();
        }
    }
}

/**
 * 制造一系列任务,分配任务优先级
 */
class PrioritizedTaskProducer implements Runnable
{
    private Random rand = new Random(47);
    private Queue<Runnable> queue;
    private ExecutorService exec;

    public PrioritizedTaskProducer(Queue<Runnable> q, ExecutorService e)
    {
        queue = q;
        exec = e;
    }

    @Override
    public void run() {

        for(int i = 0; i < 20; i++)
        {
            queue.add(new PrioritizedTask(rand.nextInt(10)));
            Thread.yield();
        }

        try {
            for (int i = 0; i < 10; i++) {
                TimeUnit.MILLISECONDS.sleep(250);
                queue.add(new PrioritizedTask(10));
            }

            for(int i = 0; i < 10; i++)
            {
                queue.add(new PrioritizedTask(i));
            }

            queue.add(new PrioritizedTask.EndSentinel(exec));

        } catch (InterruptedException e) {

        }

        System.out.println("Finished PrioritizedTaskProducer");
    }
}


/**
 * 使用PriorityBlockingQueue进行任务按优先级同步执行
 */
class PrioritizedTaskConsumer implements Runnable
{
    private PriorityBlockingQueue<Runnable> q;
    public PrioritizedTaskConsumer(PriorityBlockingQueue<Runnable> q)
    {
        this.q = q;
    }

    @Override
    public void run() {
        try
        {
            while (!Thread.interrupted())
            {
                q.take().run();
            }
        } catch (InterruptedException e)
        {
        }
        System.out.println("Finished PrioritizedTaskConsumer");
    }

}
public class PriorityBlockingQueueDemo {

    public static void main(String args[])
    {
        ExecutorService exec = Executors.newCachedThreadPool();
        PriorityBlockingQueue<Runnable> queue = new PriorityBlockingQueue<Runnable>();

        exec.execute(new PrioritizedTaskProducer(queue, exec));
        try {
            TimeUnit.MILLISECONDS.sleep(250);
        } catch (InterruptedException e) {
        }
        exec.execute(new PrioritizedTaskConsumer(queue));
    }
}
读写锁 ReadWriteLock
读写锁分为读锁和写锁,多个读锁之间是不需要互斥的(读操作不会改变数据,如果上了锁,反而会影响效率),写锁和写锁之间需要互斥,也就是说,如果只是读数据,就可以多个线程同时读,但是如果你要写数据,就必须互斥,使得同一时刻只有一个线程在操作。在同一线程中,持有读锁后,不能直接调用写锁的lock方法 ,否则会造成死锁。
一个简单的例子
class ReadWrite {
	/* 共享数据,只能一个线程写数据,可以多个线程读数据 */
	private Object data = null;
	/* 创建一个读写锁 */
	ReadWriteLock rwlock = new ReentrantReadWriteLock();

	/**
	 * 读数据,可以多个线程同时读, 所以上读锁即可
	 */
	public void get() {
		/* 上读锁 */
		rwlock.readLock().lock();

		try {
			System.out.println(Thread.currentThread().getName() + " 准备读数据!");
			/* 休眠 */
			Thread.sleep((long) (Math.random() * 1000));
			System.out.println(Thread.currentThread().getName() + "读出的数据为 :" + data);
		} catch (InterruptedException e) {
			e.printStackTrace();
		} finally {
			rwlock.readLock().unlock();
		}

	}

	/**
	 * 写数据,多个线程不能同时写 所以必须上写锁
	 */
	public void put(Object data) {

		/* 上写锁 */
		rwlock.writeLock().lock();

		try {
			System.out.println(Thread.currentThread().getName() + " 准备写数据!");
			/* 休眠 */
			Thread.sleep((long) (Math.random() * 1000));
			this.data = data;
			System.out.println(Thread.currentThread().getName() + " 写入的数据: " + data);

		} catch (Exception e) {
			e.printStackTrace();
		} finally {
			rwlock.writeLock().unlock();
		}
	}
}

public class ReadWriteLockTest {

	public static void main(String[] args) {
		/* 创建ReadWrite对象 */
		final ReadWrite readWrite = new ReadWrite();

		/* 创建并启动3个读线程 */
		for (int i = 0; i < 3; i++) {
			new Thread(new Runnable() {
				@Override
				public void run() {
					readWrite.get();

				}
			}).start();

			/*创建3个写线程*/
			new Thread(new Runnable() {
				@Override
				public void run() {
					/*随机写入一个数*/
					readWrite.put(new Random().nextInt(8));
				}
			}).start();
		}
	}
}
强一致复制机制
在分布式应用中,一致性是非常重要的,这里我们简要介绍一下
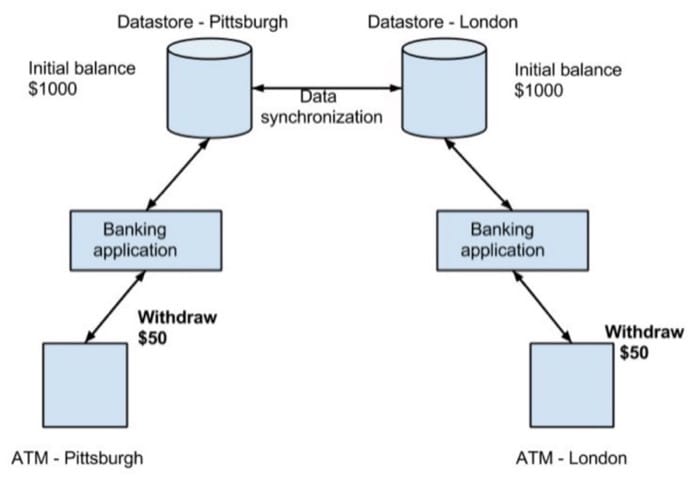
如果没有保证强一致性,那么上图中所示的场景可能就会出问题,如果同时取出 $50,那么可能最后的结果是两边都变成 $950,而不是正确的 $900,所以正确的做法是只能让一边完成操作,然后当数据库同步完成后,另一个操作才可以执行。
根据这个要求,我们的 Coordinator 还需要满足如下的强一致性需求:
| 属性 | 解释 |
|---|---|
| 强一致性 | 任何时候从任何复制节点中相同的 key 对应相同的 value |
| 严格排序 | 对应 key 相同的操作,按时间顺序处理请求 |
| 原子操作 | 所有的操作都应该是原子的,不能同时更新 |
| 访问控制 | 一个 key 在被更新时其他节点中的对应 key 不能访问 |
提示
- 如果对并行编程不熟悉,需要复习多线程,线程安全和保证执行顺序的策略等相关内容
- 需要在给 PUT 排序的时候执行显式同步。注意可能引起的竞争条件
- 有若干种方法来处理锁与竞争条件,可以参考这里以及同步的详细信息
- 使用时间戳来进行排序,优先队列会很有用
- 需要重设 datastore 时,可以访问
http://[Datastore-DNS]:8080/flush - 刚连上远程实例的时候会有比较大的延迟,请耐心等待,不要
ctrl+c,不然会出问题 - 早点开始,并行编程可能会比想象中要麻烦得多
提交方式
- 启动一个
m1.small(ami-a05d60ca) 客户端实例 - 进入
/home/ubuntu/Project3_2/,包含storage_checker,config.prop,submitter和references - 可以用
storage_checker来检测正确性,但是使用之前需要先填写config.prop(注意里面 datastore 的顺序要和Coordinator.java中的保持一致) - 填写完成后可以使用
./storage_checker.sh replication来进行测试。
平均分配分区机制
在分区机制中最重要的就是哈希函数,使用哈希的话,不可避免会出现冲突的情况,所以评价一个哈希函数好不好,主要看能否使用这个哈希函数把输入尽可能平均分摊到不同的 key 中。
举个例子,假设我们的输入是 1-6 六个数字,有如下两个哈希函数
- 函数 A
- 1,2,3: -> 0
- 4,5,6: -> 1
- 函数 B
- 1,2,3,4,5: -> 0
- 6 : -> 1
因为函数 A 使得分布更平均,于是在这个场景中,函数 A 更好。在这个项目中,哈希函数用来决定数据应该存放在哪个数据库实例中,所以我们的目标是设计一个尽可能平均分配请求的哈希函数
具体的需求如下:
- 一致性分区
- 对于给定的 key,只会被分配到同一个实例上,同一个 key 只能存在与一个实例中
- 一致性哈希
- 对于给定的输入,每次哈希得到的值是一致的
- 独立数据中心锁
- 对于一个实例的请求不会令其他实例上锁
- 非阻塞 PUT 操作
- 对于一个实例的请求阻塞其他请求
- 严格顺序
- 要保持请求的顺序
其他需要注意的地方
- key "a" 必须放在 datastore 1 中
- key "b" 必须放在 datastore 2 中
- key "c" 必须放在 datastore 3 中
- 其他的 key 应该尽可能平均分配
- 不允许使用
.hashCode()方法
提示
- 上一节的提示也适用于这一节
- 可以通过数学方法来得到哈希函数,也可以记录下 key 的分布对应来设计
- 当一致性模式改变的时候,注意清空你使用的数据结构
- 早点开始
提交方式
- 可以用
storage_checker来检测正确性,使用之前需要先填写config.prop(注意里面 datastore 的顺序要和Coordinator.java中的保持一致),然后使用./storage_checker.sh sharding来测试 - 测试完成之后,需要把
Coordinator.java移动到客户端实例的/home/ubuntu/文件夹中,对应填写references - 用
./submitter.sh进行提交 - TA 会人工给代码打分,尤其是可能的竞争条件,还要注意代码风格
操作日志
- 申请 EC2 实例:
ami-17a4947d(t1.micro),注意打开所有端口。 - 把要修改的文件复制到本地
scp -i demo.pem ubuntu@dns.compute-1.amazonaws.com:~/Project3_2/vertx/bin/Coordinator.java ./ - 修改完成后传回服务器
scp -i demo.pem ./Coordinator.java ubuntu@dns.compute-1.amazonaws.com:~/Project3_2/vertx/bin/ - 使用命令
./vertx run Coordinator.java来启动 coordinator(也可以用来检查语法错误) - 启动三个 datastore:
ami-83ba8ae9(t1.micro),注意打开所有端口 - 启动一个
m1.small(ami-a05d60ca) 客户端实例 - 分别把地址写到
Coordinator.java和config.prop中 - 把
config.prop复制到本地scp -i demo.pem ubuntu@dns.compute-1.amazonaws.com:~/config.prop ./ - 添加完之后复制回去
scp -i demo.pem ./config.prop ubuntu@dns.compute-1.amazonaws.com:~/ - 使用
./storage_checker.sh replication来进行测试 - 完成第一部分后,使用
./storage_checker.sh sharding来测试第二部分 - 填写
references以及把Coordinator.java上传到客户端实例scp -i demo.pem ./Coordinator.java ubuntu@dns.compute-1.amazonaws.com:~/ - 然后就提交
./submitter.sh
参考资料
相关文章
- 云计算 第 16 课 分布式键值对存储中的一致性问题2016-03-14
- 云计算 第 14 课 文件 vs 数据库2016-02-22
- 云计算 阅读材料 22 Message Queues and Stream Processing2016-04-22
- 云计算 第 21 课 Kafka / Samza 动手玩2016-04-18