【AI Talk】05 也谈 OpenClaw:日记即记忆
今天是初八,在这里祝大家开工大吉。缓解假期综合症的最佳办法就是通过深度思考来给自己换换脑子。这里我就想和大家聊聊春节期间爆火的 OpenClaw,不聊安装不聊配置不聊使用场景,只想聊聊 OpenClaw 的记忆系统。作为一个写了八年日记的人,对于给大模型装上记忆系统,我有一个激进的预测:日记即记忆。
注 1:本文前摇较长,心急的朋友可以直接看最后的结论。
记忆本身的原理,我们现在并不完全了解。如果破解了记忆的奥秘,可能就离我心目中脑科学的皇冠——意识——更近了一步。当然,我不是一个生物学家,无法从生理角度给出专业的猜想,但我是一个工程师,擅长用工程的视角来观察和理解。正如人类飞天的梦想,在流体力学等理论的基础上,通过莱特兄弟的工程方法得以实现。而智能和 AGI 的梦想,也在机器学习几十年的探索中,找到了一条"压缩即智能"的路线。也许记忆的原理,同样能够通过工程的方法,另辟蹊径找到新的突破口。
从去年下半年开始,给大模型装上海马体(也就是记忆)的研究就逐渐多了起来。不严谨地总结一下,主要有三个大的流派:1️⃣ 第一派我称之为 RAG 派,核心思想是通过更强的嵌入、更复杂的检索和召回机制来实现更加精准的记忆。这个流派实际上是把记忆当成了联网搜索,只是不联"互联网",而是联"人脑网"。2️⃣ 第二派我称之为 Graph 派,核心思想是通过语义的联结来解决 RAG 派不太好解决的记忆内容的关联问题。这个流派让曾经小众的知识图谱相关技术重见天日,不过也有硬伤。3️⃣ 第三派我称之为 Unix 派,核心思想是通过文件夹和文本文件的组织,以关键词和正则为主要检索逻辑来实现记忆系统,强调记忆对于人类用户的可解释性和可操作性。
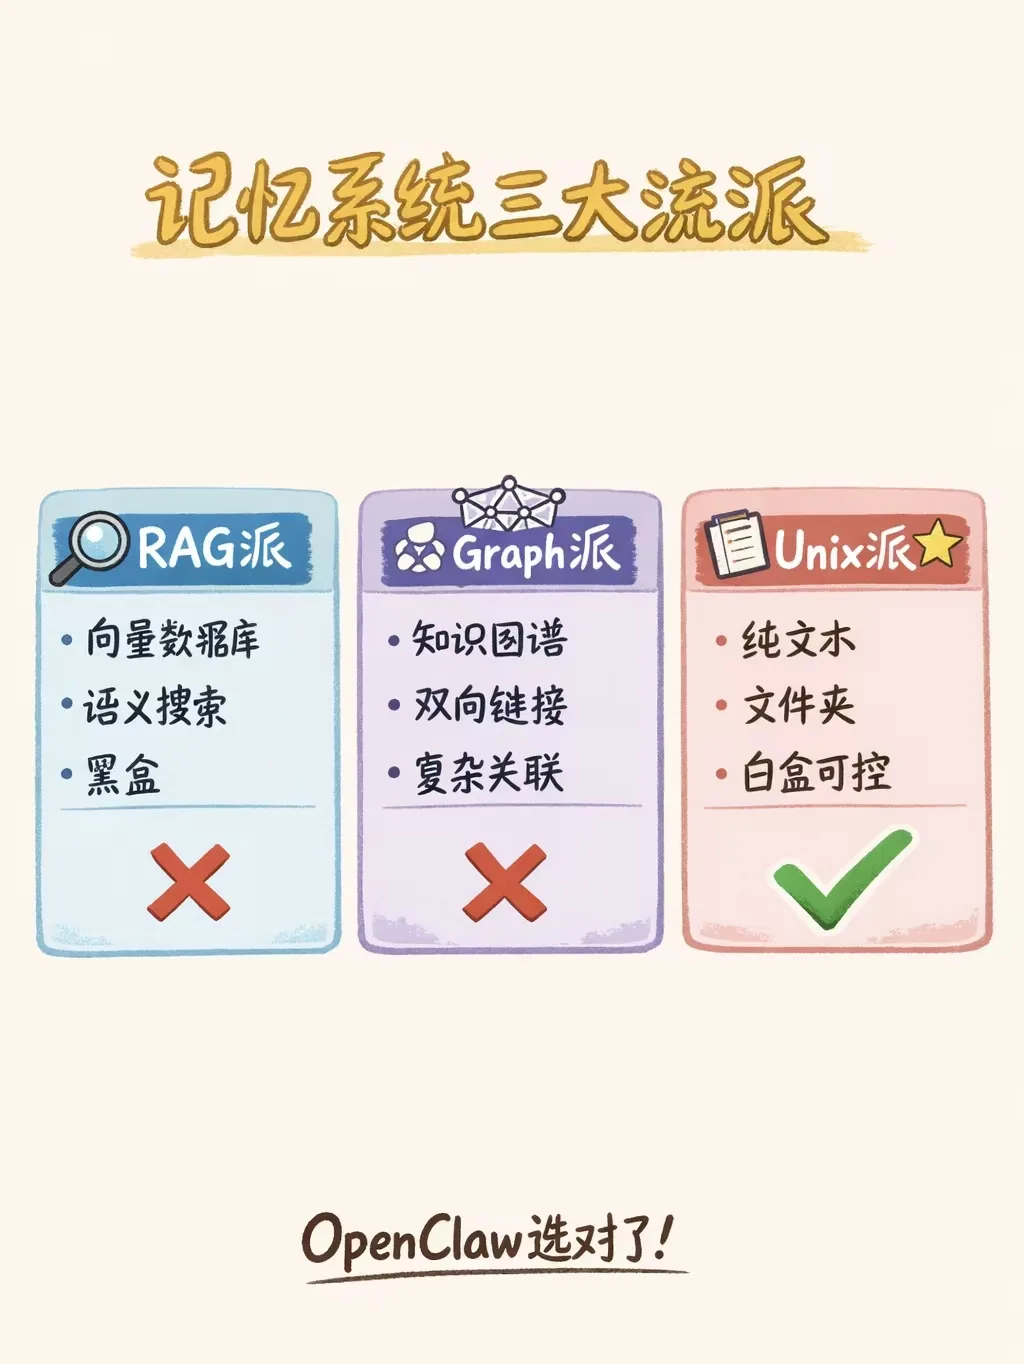
在 OpenClaw 爆火之前,RAG 派是主流,Graph 派一般靠踩 RAG 派博眼球,而 Unix 派则比较清高,基本不参与讨论。关于 Unix 派的"战绩",据我不准确的记忆,最初是 OpenAI 推出"记忆"功能、Manus 使用 Markdown 文件来做上下文工程和流程控制,后面则是 Claude Code 通过迭代式的 Claude.md 文件实现不断进化。OpenClaw 爆火之后,大家对其记忆系统开始深入地解析,发现居然是如此"离经叛道"的设计:纯文本 Markdown + 本地优先。
| 特性 | 业界主流设计 (如 RAG / Vector DB) | OpenClaw 记忆系统 |
|---|---|---|
| 存储形态 | 向量嵌入 (Embeddings),存在向量数据库中。 | 纯文本 Markdown,存在本地文件系统中。 |
| 透明度 | 黑盒。用户很难直接查看或修改 AI 到底“记住了什么”。 | 白盒。用户可以用记事本直接打开、编辑、删除记忆。 |
| 编辑成本 | 高。需要重新计算向量并更新数据库索引。 | 极低。像改文档一样简单,甚至支持 Git 版本管理。 |
| 检索方式 | 主要是语义相似度检索 (Vector Search)。 | 混合检索:关键词触发 + 语义搜索 + 目录索引。 |
| 交互逻辑 | 被动检索。只有用户提问时才去搜记忆。 | 主动维护。Agent 会定期自我复盘并重写记忆文件。 |
从这一点上我就很欣赏 OpenClaw 的技术品味,说实话我是如释重负,爆火的项目如果品味差,是会影响很多人的。我对于架构的理解就是大道至简:复杂的人为设定的机制,很可能是画蛇添足(此处推荐《Unix 编程艺术》一书)。OpenClaw 的记忆系统设计,让我想到了另外一个小众的笔记软件 Obsidian,它的核心思想借鉴了另外一个非常拗口的单词 Zettelkasten(卢曼卡片盒笔记法),我认为是摸到了记忆的工程化精髓。当然,在我看来,目前原教旨的 Zettelkasten 也陷入了误区:过于强调工具属性和"双向链接",想要通过 Graph(图谱)来解决记忆问题,本质上变成了前面所说的 Graph 派。
注 2:心急的朋友你们好,前方开始结论。
为什么说日记即记忆呢?这是从我实际写了八年日记的经历中,结合对 OpenClaw 记忆系统的理解,自然而然得出的结论。让我们用工程师的视角来拆解一下——日记,其实就是一个天然的 Unix 派记忆系统,完美契合了前面表格里 OpenClaw 设计的所有精髓:
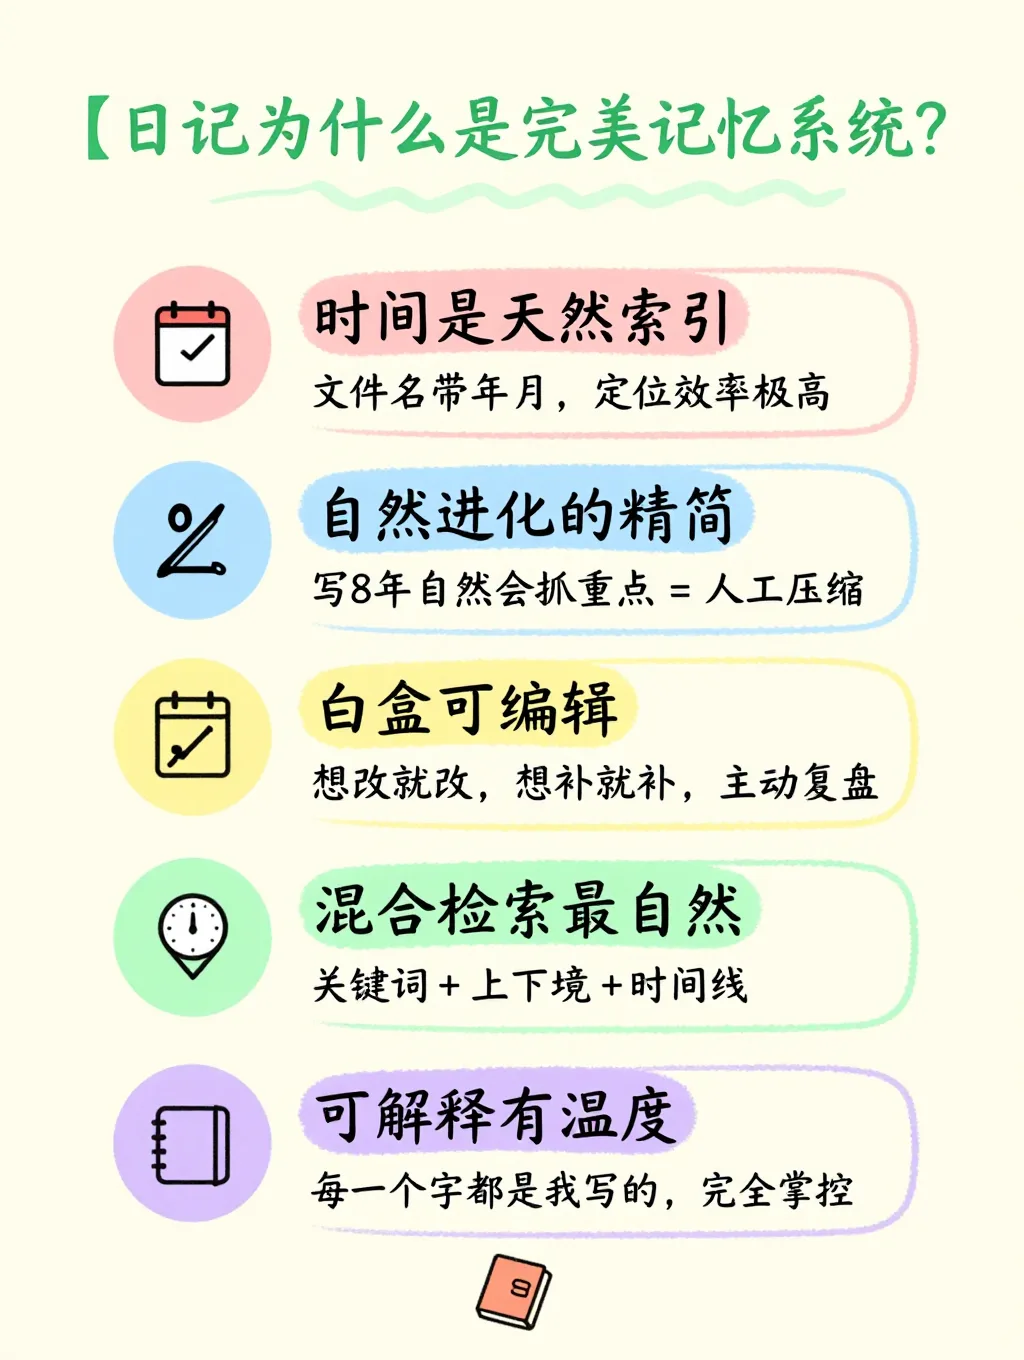
第一,时间维度是天然的索引。 我的日记文件名就是年月(比如 2026年02月流水日记.md),内容本身按日期排列。这就像文件系统的目录树,不需要额外的向量数据库,时间本身就是最高效的索引。当我想找"上一次去巽寮湾是什么时候",不需要语义搜索,先定位到最近几个命中的文件,再扫一遍,效率极高。这正是 OpenClaw"目录索引"的思路。
第二,精简是自然进化的结果。 刚开始写日记时我也事无巨细,但写了十年后,自然就学会了抓重点——只记那些真正重要的、将来可能会用到的信息。这和 RAG 派追求"更大的嵌入、更复杂的召回"完全相反:好的记忆,不在于记住了多少,而在于该记住的都记住了。这其实就是一种人工的"压缩",巧了,"压缩即智能"又出现了。
第三,白盒、可编辑、可迭代。 日记是纯文本,我可以用任何编辑器打开,想改就改——忘了记的可以补,记错了的可以修正,事后有新的感悟还可以在旁边批注。更重要的是,我可以主动复盘:年底翻翻年初的日记,把重要的经历提炼、整合,形成新的认知。这就是 OpenClaw"主动维护"机制的雏形——记忆不是静态的存档,而是动态生长的文档。
第四,混合检索最自然。 找"去年包了多少钱红包"这种精确信息,直接用关键词搜索("红包");想不起来具体细节,但记得是"和张三一起吃饭时聊的",就看上下文语境;想回顾"这一年的成长",直接按时间线扫一遍。关键词 + 语义 + 时间线,这不就是 OpenClaw 的"混合检索"吗?
最后,可解释、可控制、有温度。 日记是我的,每一个字都是我写的,我完全知道里面有什么、没有什么。不像 RAG 派的黑盒,我根本不知道 AI"记住"了什么、为什么会检索出这段而不是那段。也不像 Graph 派的复杂关联,这种关联人类根本无力维护。活人的掌控感,对于记忆系统来说太重要了。
如果你问我关于大模型的记忆,哪一派会最终胜出,我相信 Unix 派最有可能。如果你问我作为个人现在能做点什么,我会说,开始写日记,写啥都行,因为 日记即记忆。
相关文章
- 【AI Talk】07 OpenClaw 和 Claude Code 怎么选2026-03-15
- 【AI Talk】22 痛苦才是壁垒2026-08-23
- 【AI Talk】21 绕开 Loop 和知识图谱2026-08-20
- 【AI Talk】20 好的研发需要什么样的 Coding Agent2026-08-18