How to Write Fast Code 第 3 课 Manycore 编程
本页目录
这节课我们主要来了解一下基于 CUDA 平台的 GPU 编程。
首先需要理解的概念就是,CPU 中的每个核都很强大,但是 GPU 中的每个核都比较弱。下面是一个很好的类比:
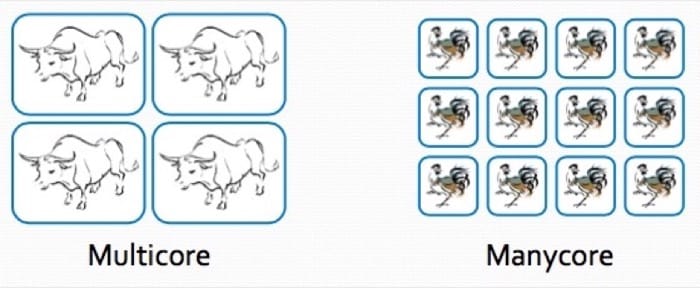
换成更清晰的设计图,更能体现两者的不同:
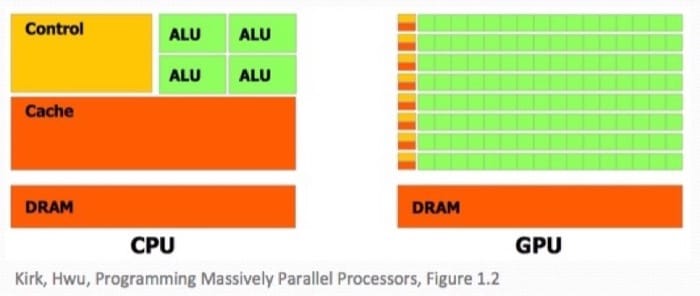
对于 CPU 来说,具体的优化是针对于减小若干线程的执行延迟的,包含复杂的指令控制和较大的缓存,每个核心能够以极高的速度执行单一线程。
对于 GPU 来说,目的是提高并行数量,主要目标是提高总体的吞吐量,而不是某个具体核心的性能。下面是一个简单的比较:
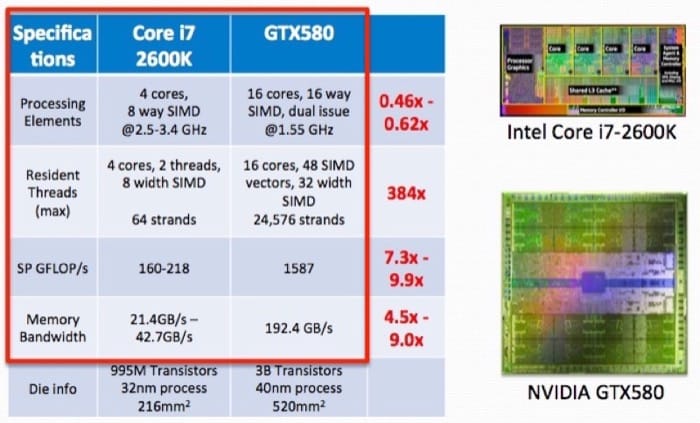
什么时候适合使用 GPU 呢?
- 极高的并行计算数量,比方说需要同时计算几千个节点的状态
- 计算时对内存带宽有极高的要求,因为 GPU 的内存更大更快,所以往往会有更好的性能
CUDA
CUDA 的全程是 Compute Unified Device Architecture,是一个由 NVIDIA 开发的并行计算框架。整个计算的流程大概是:
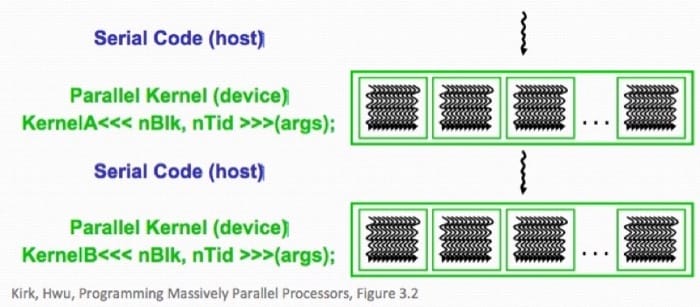
串行和简单的并行部分在 host 中完成,高度并行的代码在 GPU 的 kernel 中执行。
这里说一下,我们知道 GPU 本质工作还是计算图形相关的东西,所以其架构决定了每个内核只能执行非常有限的工作(例如着色器渲染器这类计算量大但是不复杂的工作),我们在利用 CUDA 编程的时候,实际上最终也还是类似于渲染画面之类的感觉,只是结果不是图像,而是具体的数据了。
Architecture
关于 GPU 的架构,有一个很有趣的地方,就是对应的 memory hierarchy 和 CPU 是相反的,如:
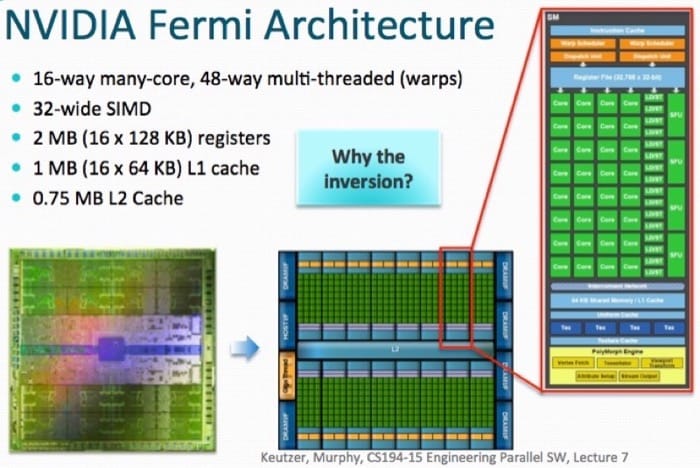
寄存器 > L1 缓存 > L2 缓存,这是为什么呢?是为了解决现在处理器的速度和内存的速度相差越来越大的问题:
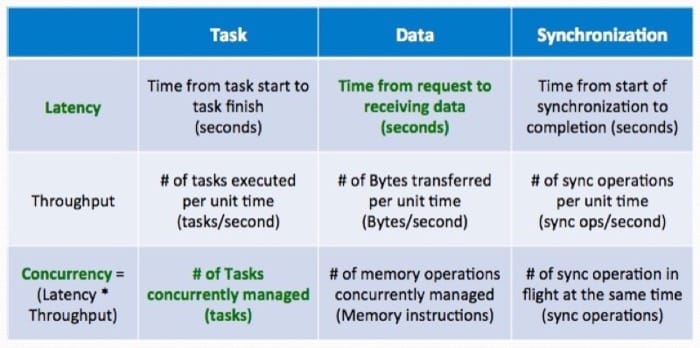
为了利用好这些缓存,Fermi 内核会维护 48 个 warp,每个 warp 是一个用于计算的 32 位 SIMD 向量。每个线程大约有 20 个寄存器,我们来算一下:
4(Bytes/register) x 20(Registers) x 32 (SIMD lanes) x 48 (Warps) = 128KB/core x 16 (core) = 2MB register files
这也就是为什么有 2MB 的寄存器大小了。
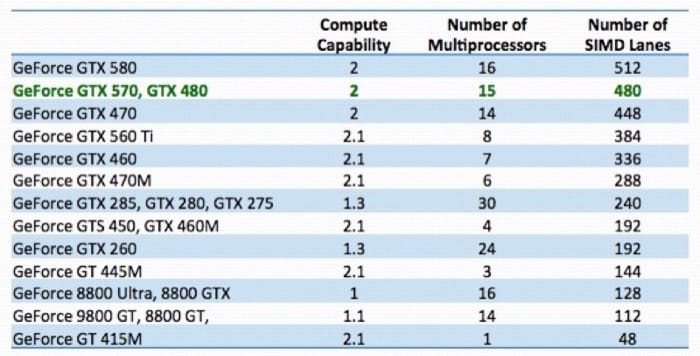
使用 warp 作为计算单位可以认为是为了简化 GPU 编程模型所做的设计(毕竟和 CPU 会有很大不同),前面我们也看到,不同的核心数目其实跟寄存器大小都是有关的,也就是说,GPU 编程仍然是一个非常硬件相关的工作:
Thread Block
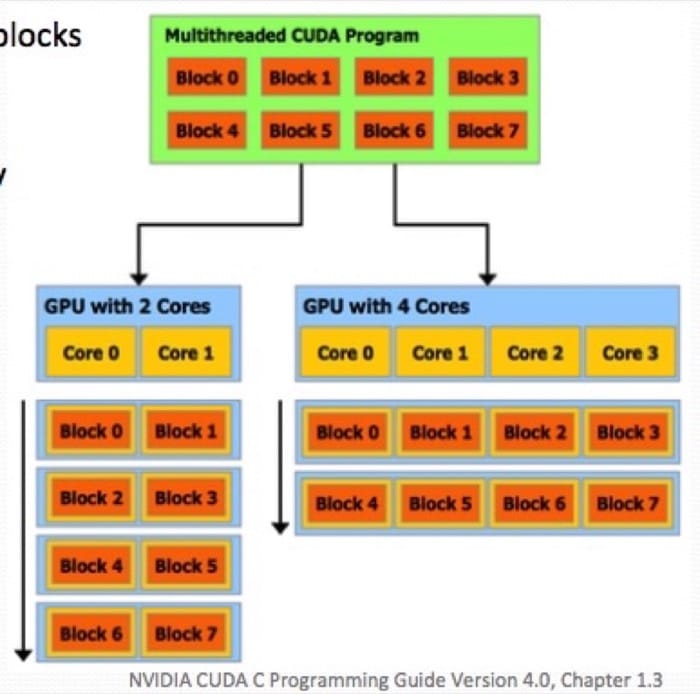
为了配合不同的硬件,并行的工作实际上是以线程块的形式来组织的,下面的例子中,对于 2 个核心的 GPU,每次执行倆;对于 4 个核心的,每次执行四个:
然后我们来看看具体的数据是如何存储的。首先每个核心都有自己的存储,在同一个 SIMD lane 进行计算的核心可以通过内存读写来进行交流。
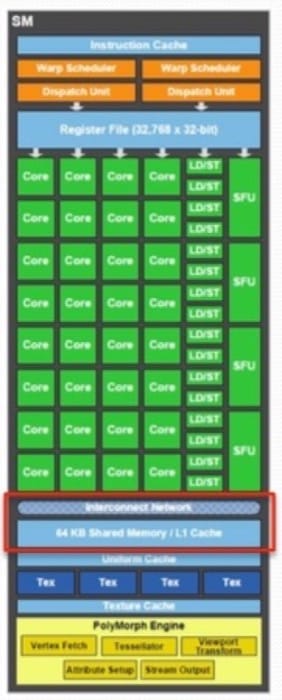
对于 Fermi 架构的 GPU 来说,有两种不同的配置:
- 48KB scratch pad (Shared Memory), 16KB L1 cache
- 16KB scratch pad (Shared Memory), 48KB L1 cache
具体编程的部分这里不再一一赘述,只列出一些关键的要点,提醒大家注意:
- 什么工作在 CPU 里做,什么工作在 GPU 里做?
- 如何高效使用共享内存?
- 如何给 GPU 指定具体的工作?
- 如何保证线程同步?
- 如何保证操作的原子性?
具体的执行模型是:
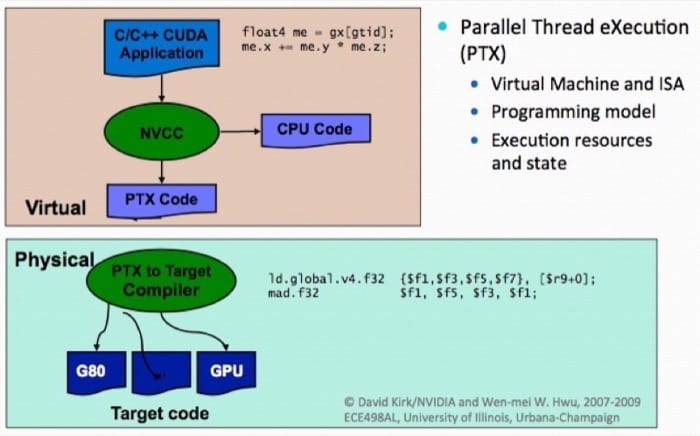
其中:
- NVCC 是编译器,会调用需要调用的各种程序
- NVCC 会输出给 CPU 执行的 C 代码,还需要进一步编译
- 还会输出 PTX,是对象代码,直接在 GPU 上进行执行
更多的内容可以参考官网的指引(比较有时效性)
性能考虑
有三个考量,这里大概列出具体的思路,细节请大家自己探究:
- Maximizing Memory Throughput
- SoA vs AoS
- Memory coalescing
- Use of Shared memory
- Memory bank conflict
- Padding
- Maximizing Instruction Throughput
- 尽量减少分支部分的代码
- Loop unrolling
- Maximizing Scheduling Throughput
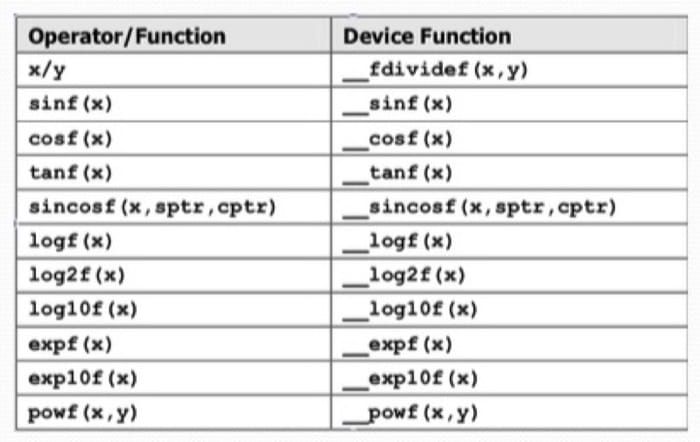
- 对于数学运算,可以使用 GPU 相关的函数,如下图所示
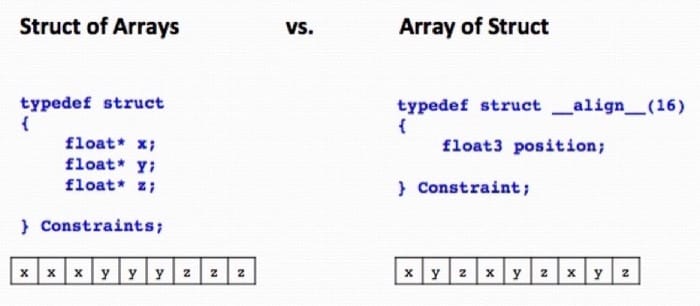
根据应用的不同设计,看看这两种结构到底哪种更加适合
这一部分的内容最重要的是实践,一定要通过不断尝试理解具体的概念,不然真的会发现自己完完全全是纸上谈兵!
相关文章
- How to Write Fast Code 第 4 课 并行架构2016-03-20
- How to Write Fast Code 第 0 课 往年笔记与问题集2016-02-01
- How to Write Fast Code 第 1 课 背景知识2016-02-01
- How to Write Fast Code 第 2 课 Multicore 编程2016-02-01