深入理解计算机系统 期中考试复习
本页目录
这一次我们主要来回顾一下重要的知识点,以及讲解一些往年试题中容易混淆的概念。
知识点梳理
范围是第 1-3 章和第 6 章,下面是部分知识点(每个其实都包含不少内容,建议再看一次我前面写过的系列,这里还是会挑一些重点来写以下)
- 十六进制表示
- 数据类型的字节表示
- C 语言中的位操作、逻辑操作、左移右移操作
- 整型的表示方法及运算方式
- 浮点数的表示方法及运算方式
- 理解汇编:访问数据,算术和逻辑运算,控制,过程调用,数组的内存空间分配和访问,结构体/联合体的表示,数据对齐
- 理解指针,栈帧以及常见的攻击方式
- 内存相关话题:Locality, Memory Hierarchy, Cache Memories
布尔运算
集合 A
01101001 {0, 3, 5, 6}
76543210
集合 B
01010101 {0, 2, 4, 6}
76543210
那么不同的布尔运算就代表:
&交集 Intersection01000001{0, 6}|并集 Union01111101{0, 2, 3, 4, 5, 6}^差集 Symmetric difference00111100{2, 3, 4, 5}~补集 Complement10101010{1, 3, 5, 7}
以上这四种运算 C 语言都支持,只要是『数值型』即可:long, int, short, char, unsigned。每个参数都会被看做是位向量。
整型的表示
针对有符号数和无符号数,有两种不同的形式,这里的 w 表示 word size:
- 无符号数:
- 有符号数:
为了方便讲解,下面定义几个常量,这里 w 是 word size:
- UMin = 0 即 000...0
- UMax = 即 111...1
Two's Complement 值
- TMin = 即 100...0
- TMax = 即 011...1
其他值
- Minus 1 即 111...1
观察可以得知两个很重要的特性
- |TMin| = TMax + 1 (范围并不是对称的)
- UMax = 2*TMax + 1
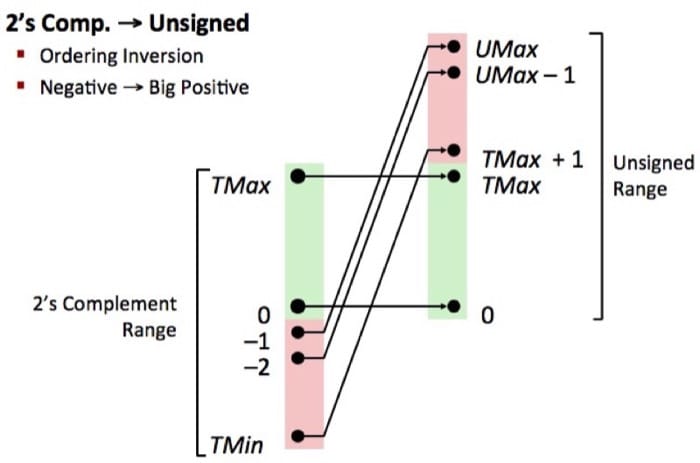
有符号数和无符号数在非负数的编码是一样的,每一个数字的编码是唯一的,这两者可以互换:
拓展和裁剪
有的时候我们需要扩展一个变量的位数,比如说从 32 位扩展到 64 位。更通用一点的话,给定一个 w 位的有符号整数 x,要把它转换成 w+k 位的整数(保持值不变),只需要在左边添加 k 个与符号位相同的数值即可,如下图:
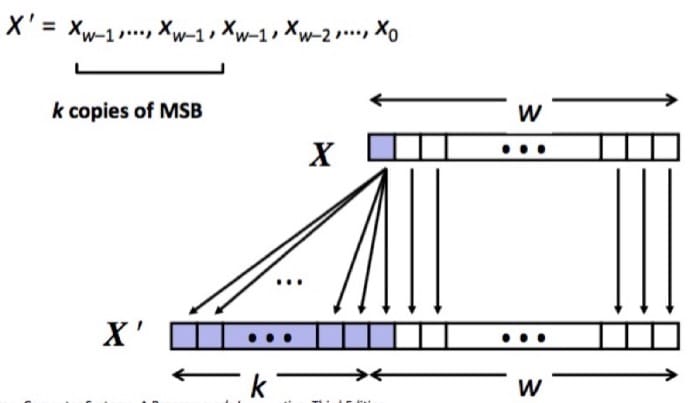
- 扩展(例如从
short int到int)- 无符号数:加 0
- 有符号数:加符号位
- 都可以得到预期的结果
- 缩短(例如
unsigned到unsigned short)- 均会截取
- 无符号数:mod 操作
- 有符号数:近似 mod 操作
- 对于小的数字可以得到预期的结果
溢出问题
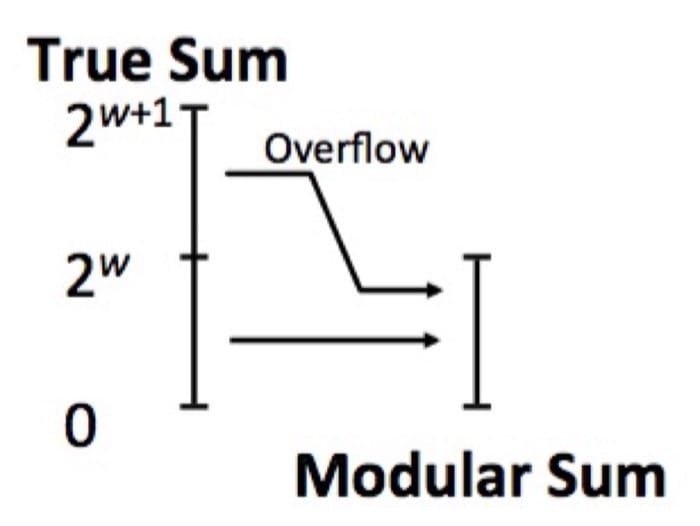
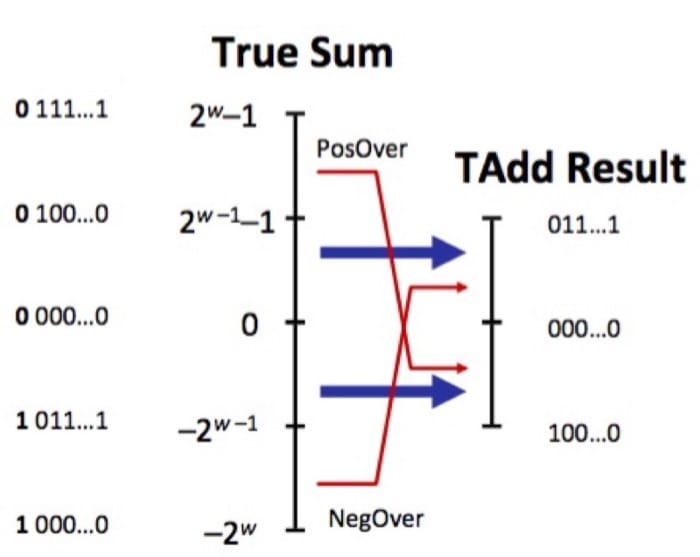
无符号加法和有符号加法有不同的溢出方式:
浮点数
二进制浮点数的表示,其实和我们日常生活中常见的十进制的方式是一致的,都是相当于每一位的系数,乘以每一位的数值,然后把结果加起来,如下图所示:
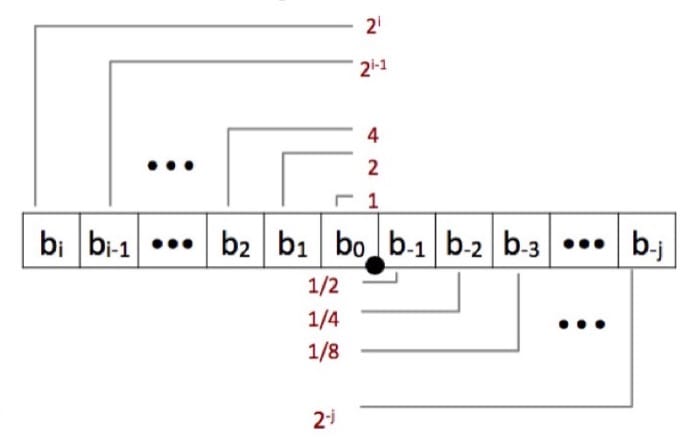
所以我们其实可以用一个统一的公式来表达:
例如
细心的同学就会发现,这种表达方式其实是比较明显的限制的,比如说,只有形为 的小数部分可以被精确表示,其他的数字会变成循环的小数,例如:。
除此之外,另一个问题在于,如果给定了 w 个比特,能够表达的数字其实是有限的。
IEEE 浮点数
我们用下面的公式来表达浮点数:
其中 s 是符号位,决定正负;M 通常是一个值在 [1.0, 2.0) 的小数;E 是次方数。具体编码的时候是这样的:
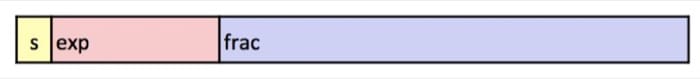
其中 s 对应着符号位,exp 对应着 E(注意,不一定等于 E,因为位数限制表达能力有限),frac 对应着 M(注意,不一定等于 M,因为位数限制表达能力有限)。
不同的位数就代表了不同的表示能力,也就是单精度,双精度,扩展精度的来源,具体的位数表示如下:
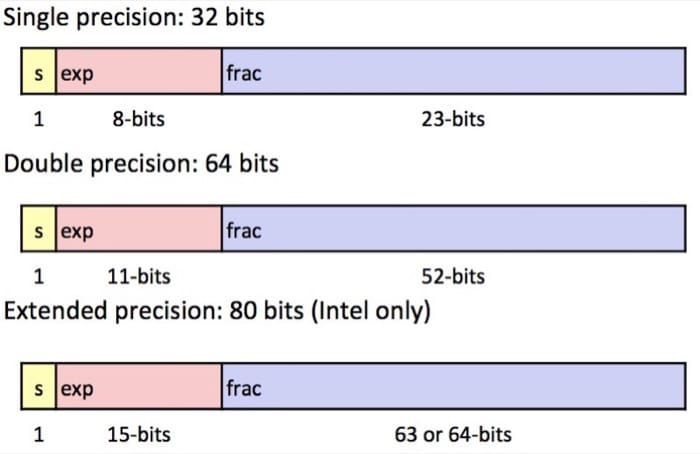
注意区别 normalized 和 denormalized 的区别
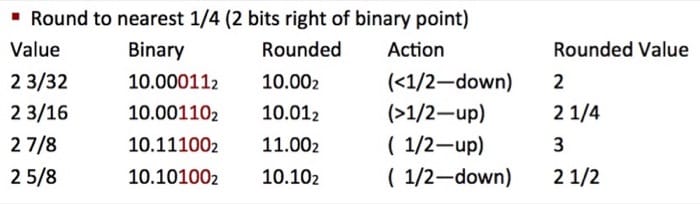
舍入到最近的偶数比较特别,中心思想是:舍入之后最右边的值要是偶数,从下面一个例子就可以明白:
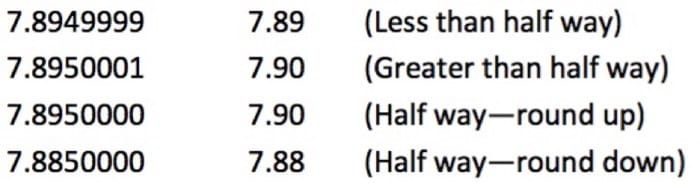
对于二进制数也是类似的
浮点数乘法
结果是 ,其中 s= s1 ^ s2, M = M1 * M2, E = E1 + E2
- 如果 M 大于等于 2,那么把 M 右移,并增加 E 的值。
- 如果 E 超出了可以表示的范围,溢出
- 把 M 舍入到 frac 的精度
基本性质
- 相乘可能产生 infinity 或者 NaN
- 满足交换率
- 不满足结合律(因为舍入会造成精度损失)
- 乘以 1 等于原来的数
- 不满足分配率
1e20*(1e20-1e20)=0.0但1e20*1e20-1e20*1e20=NaN - 除了 infinity 和 NaN,满足单调性,即
浮点数加法
,这里假设 E1 > E2
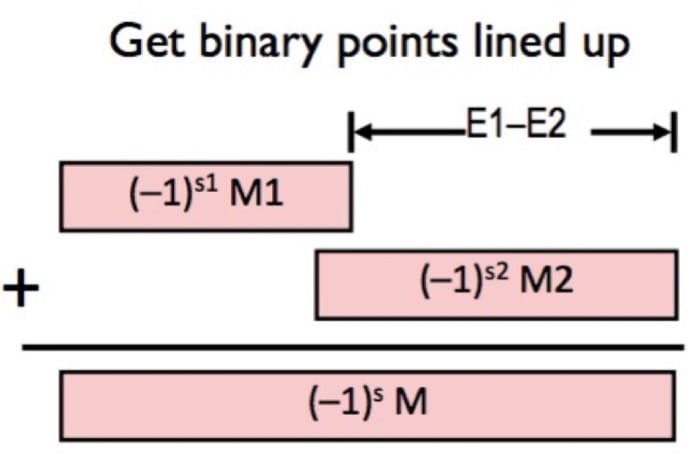
结果是 ,其中 s= s1 ^ s2, M = M1 + M2, E = E1
- 如果 M 大于等于 2,那么把 M 右移,并增加 E 的值
- 如果 M 小于 1,把 M 左移 k 位,E 减少 k
- 如果 E 超出了可以表示的范围,溢出
- 把 M 舍入到 frac 的精度
基本性质
- 相加可能产生 infinity 或者 NaN
- 满足交换率
- 不满足结合律(因为舍入会造成精度损失,如
3.14+1e10)-1e10=0,但3.14+(1e10-1e10)=3.14) - 加上 0 等于原来的数
- 除了 infinity 和 NaN,每个元素都有对应的倒数
- 除了 infinity 和 NaN,满足单调性,即
移动数据与寻址
操作数主要有三种类型,一种是立即数,也就是直接给的一个数字,第二种是寄存器,第三种是内存
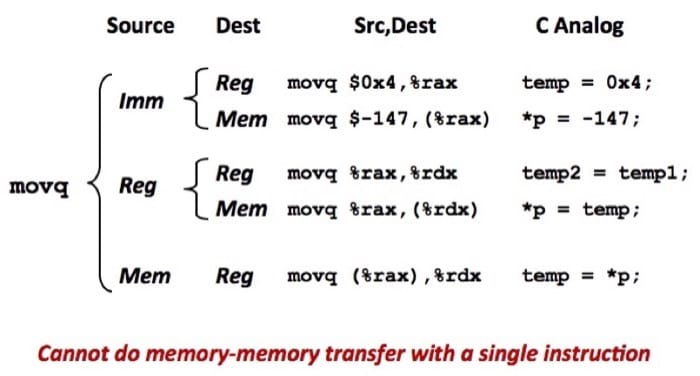
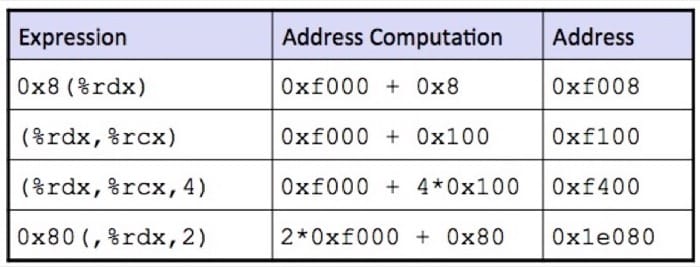
普通模式,(R),相当于 Mem[Reg[R]],也就是说寄存器 R 指定内存地址,类似于 C 语言中的指针,语法为:movq (%rcx), %rax 也就是说以 %rcx 寄存器中存储的地址去内存里找对应的数据,存到寄存器 %rax 中
移位模式,D(R),相当于 Mem[Reg[R]+D],寄存器 R 给出起始的内存地址,然后 D 是偏移量,语法为:movq 8(%rbp),%rdx 也就是说以 %rbp 寄存器中存储的地址再加上 8 个偏移量去内存里找对应的数据,存到寄存器 %rdx 中
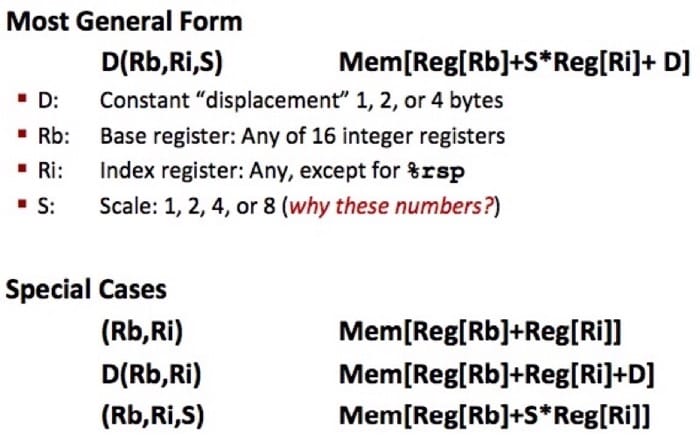
举个例子:%rdx 的存着的地址是 0xf000;%rcx 的存着的地址是 0x0100,那么有:
条件码与代码控制
最后的四个寄存器(CF, ZF, SF, OF)就是用来辅助程序的流程控制的,意思是:
- CF: Carry Flag (for unsigned)
- ZF: Zero Flag
- SF: Sign Flag (for signed)
- OF: Overflow Flag (for signed)
可以看到以上这四个寄存器,表示四种不同的状态,举个例子,假如我们有一条诸如 t = a + b 的语句,汇编之后假设用的是 addq Src, Dest,那么根据这个操作结果的不同,会相应设置上面提到的四个寄存器,而因为这个是执行类似操作时顺带尽心设置的,称为隐式设置,例如:
- 如果两个数相加,在最高位还需要进位(也就是溢出了),那么 CF 寄存器就会被设置
- 如果 t 等于 0,那么 ZF 寄存器会被设置
- 如果 t 小于 0,那么 SF 寄存器会被设置
- 如果 2's complement 溢出,那么 OF 寄存器会被设置为 1(溢出的情况是
(a>0 && b > 0 && t <0) || (a<0 && b<0 && t>=0))
这就发现了,其实这四个条件代码,是用来标记上一条命令的结果的各种可能的,是自动会进行设置的。注意,使用 leaq 指令的话不会进行设置。
栈帧
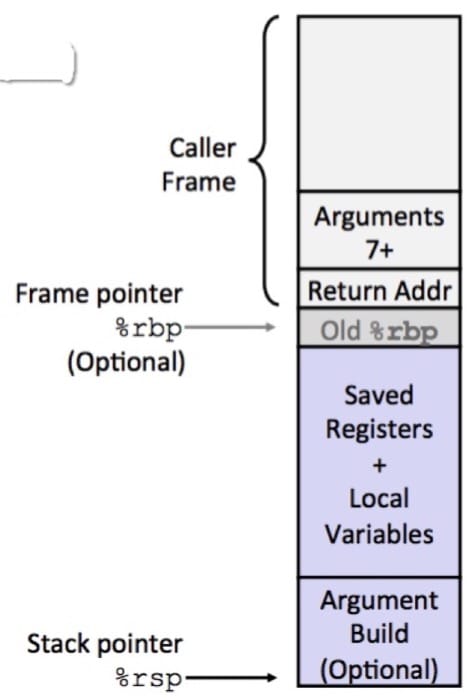
在 x86-64/Linux 中,栈帧的结构是固定的,当前的要执行的栈中包括:
- Argument Build: 需要使用的参数
- 如果不能保存在寄存器中,会把一些本地变量放在这里
- 已保存的寄存器上下文
- 老的栈帧的指针(可选)
而调用者的栈帧则包括:
- 返回地址(因为
call指令被压入栈的) - 调用所需的参数
具体如下图所示:
存储相关
总的访问时间 Taccess = 寻址时间 Tavg seek + 旋转时间 Tavg rotation + 传输时间 Tavg transfer
- 寻址时间 Tavg seek 因为物理规律的限制,一般是 3-9 ms
- 旋转延迟 Tavg rotation 取决于硬盘具体的转速,一般来说是 7200 RPM
- 传输时间 Tavg tranfer 就是需要读取的 sector 数目
举个例子,假设转速是 7200 RPM,平均寻址时间 9ms,平均每个 track 的 sector 数目是 400,那么我们有:
- Tavg rotation = 1/2 x (60 secs / 7200 RPM) x 1000 ms/sec = 4 ms
- Tavg transfer = 60 / 7200 RPM x 1/400 secs/track x 1000 ms/sec = 0.02 ms
- Taccess = 9 ms + 4 ms + 0.02 ms
从这里可以看出,主要决定访问时间的是寻址时间和旋转延迟;读取一个 sector 的第一个 bit 是非常耗时的,之后的都几乎可以忽略不计;硬盘比 SRAM 慢 40,000 倍,比 DRAM 慢 2500 倍。
Locality 与 Memory Heirarchy
Locality 的思路很简单,就是如果一个数据最近被访问过,很可能还会被再次访问:
- Temporal locality: Recently referenced items are likely to be referenced again in the near future
- Spatial locality: Items with nearby addresses tend to be referenced close together in time
一种介质的速度越快,就会越贵,同时也消耗更多的电量,所以一般容量比较小。而 CPU 和内存之间的速度差距越来越大,所以好的程序都会尽可能利用 locality。根据这些特性,也就引申出了一个安排存储的方式,称为 memory hierarchy。
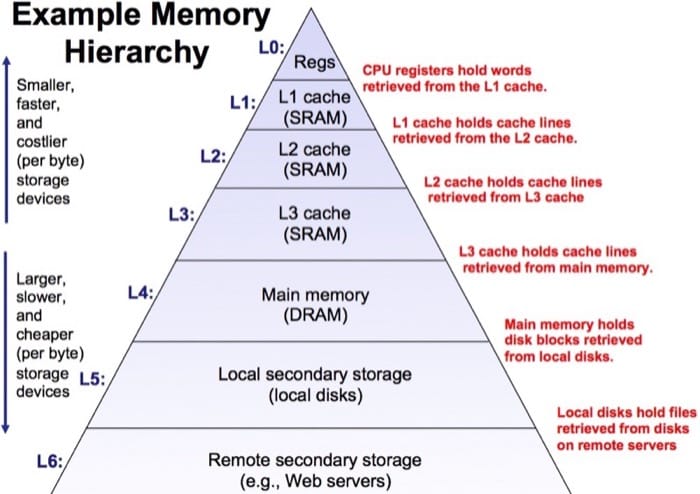
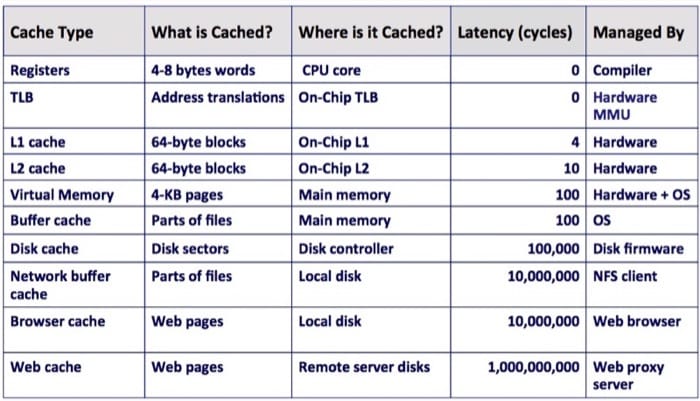
这里就涉及到一个技术:缓存。缓存可以看作是把大且缓慢的设备中的数据的一部分拿出来存储到其中的更快的存储设备。在 memory hierarchy 金字塔中,每一层都可以看作是下一层的缓存。利用 locality,程序会更倾向于访问第 k 层的数据,而非第 k+1 层,这样就减少了访问时间。
Cache Miss
Cache miss 有三种:
- Cold(compulsory) Miss: CPU 第一次访问相应 cache 块,cache 中肯定没有该 cache 块,这是不可避免的
- Confilict Miss: 在直接相联或组相联的 cache 中,不同的 cache 块由于 index 相同相互替换,引起的失效叫做冲突失效
- 假设这里有 32KB 直接相联的 cache
- 如果有两个 8KB 的数据需要来回访问,但是这两个数组都映射到相同的地址,cache 大小足够存储全部的数据,但是因为相同地址发生了冲突需要来回替换,发生的失效则全都是冲突失效(第一次访问失效依旧是强制性失效),这时 cache 并没有存满
- Capacity Miss: 有限的 cache 容量导致 cache 放不下而被替换出 cache 块,被替换出去的 cache 块再被访问,引起的失效叫做容量失效
- 假设这里有 32KB 直接相联的 cache
- 如果有一个 64KB 的数组需要重复访问,数组的大小远远大于 cache 大小,没办法全部放入 cache。第一次访问数组发生的失效全都是强制性失效。之后再访问数组,再发生的失效则全都是容量失效,这时 cache 已经存满,容量不足以存储全部数据
Cache Memories
通常来说,是按照如下图所示的方式来组织的,一定要注意 S/E/B 具体在说什么:
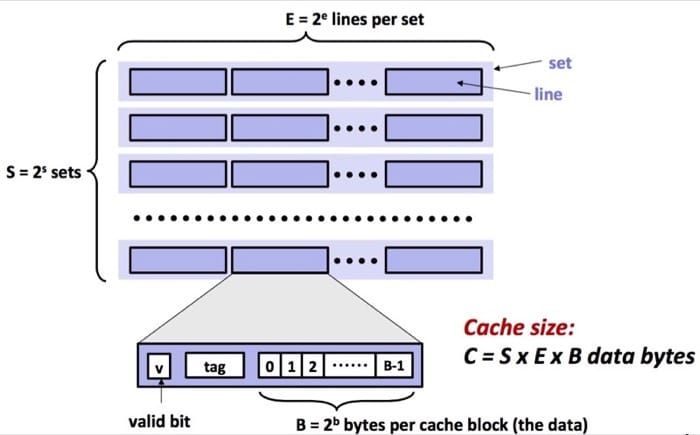
实际上可以理解为三种层级关系,对应不同的索引,这样分层的好处在于,通过层级关系简化搜索需要的时间,并且和字节的排布也是一一对应的(之后介绍缓存的时候就体现得更加明显)。
具体的例子请参考深入理解计算机系统 第 12 课 Cache Memories
Memory Mountain
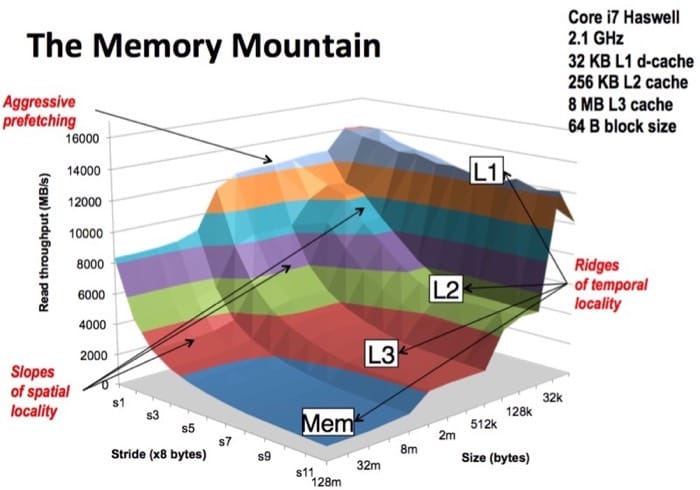
注意,这是根据 Core i7 得出来的图,不同的处理器可能因为不同的设计和架构而有所区别,但是可以通过不同的颜色和层次,看出不同 size 和 stride 对性能的影响。山脚是我们应该尽量避免的,山顶是我们力求达到的,也就是说,尽量一次访问一个 stride,一次读入的数据大小也不宜太大,最好和 L1 缓存数值上吻合。
往年试题讲解
选择题知识点
test指令和and指令一样,只设置 flag 不改变结果- 在一个 32 位的 Linux 系统中,
long的大小为4 bytes - 在一个 64 位的 Linux 系统中,并不是所有的参数都在栈上传递
mov和lea指令的不同在于mov会 dereferences an address,也就是说mov是取值,lea是地址- 先调用函数,然后压入
%ebp - 一个 8 位浮点数(1 sign, 3 exp, 4 frac),则 0 111 1111 表示 NaN
- 每次执行完一条语句,
%rsp的值减 8 - 二维数组在内存中以 row-major 方式存储
%rdi保存着函数调用的第一个参数
浮点数编码
这里我们考虑两种 6 位数的 IEEE 浮点数格式
- 格式 A
- 1 个符号位 s
- k = 3 个 exponent bits,bias 为
- n = 2 个 fraction bits
- 格式 B
- 1 个符号位 s
- k = 2 个 exponent bits,bias 为
- n = 3 个 fraction bits
注意
- 对应于 denormalized 的情况,E = 1 - bias
- 对应于 normalized 的情况,E = exp - bias
需要填写下表
| Value | Format A Bits | Format B Bits |
|---|---|---|
| Zero | 0 000 00 | 0 00 000 |
| One | 0 011 00 | 0 01 000 |
| 0 010 00 | 0 00 100 | |
| 0 011 10 | 0 01 011 |
我们来对应看一下具体要怎么填。
首先需要知道的是 IEEE 浮点数的具体格式,是 s | exp | frac。接下来要知道什么时候是 denormalized,什么时候是 normalized,简单来说就是如果 exp 全为 0 或全为 1 时,属于 denormalized,其他时候属于 normalized。
对应浮点数的公式
我们知道如果要表示 1,那么 E 应该等于 0,M 部分应该为 1(M 的形式应该是是 1.xxxxx,其中 xxx 是 frac 的部分,于是 frac 应该为 0)。这里 E 因为属于 normalized 的情况,所以 E = exp - bias,而 E 需要等于 0,所以 exp = bias,针对不同的格式,就可以找到对应的答案(格式 A 中 bias = 3,所以 exp 部分是 011;格式 B 中 bias = 1,所以 exp 部分是 01;frac 部分均为 0)
然后我们来看看如何表示 0.5,根据公式,E 应该等于 -1,那么对于格式 A,E = exp - bias,所以 exp = -1 + 3 = 2,exp 部分就是 010。但是对于格式 B 就有点不同,因为这时候是属于 denormalized 的,这时 E = 1 - bias = 0,我们需要对 frac 部分做出处理,在这种情况下(M 的形式是 0.xxx),frac 的第一位就表示 0.5,所以最终的结果如上表所示。
最后我们来看看 要如何表示,实际上就是 1 加上 ,因为前面已经表示过 1,所以只要在 frac 部分做做文章即可,这次我们先来看格式 B,根据浮点数的定义,我们很快就可以知道 frac 应该为 011,完成!对于格式 A,因为 frac 只有 2 位,那么就需要进行舍入(到最近的偶数),也就是 011 -> 01 + 01 -> 10,所以最终的结果如上表所示。
汇编程序阅读
假设有这么一段汇编程序
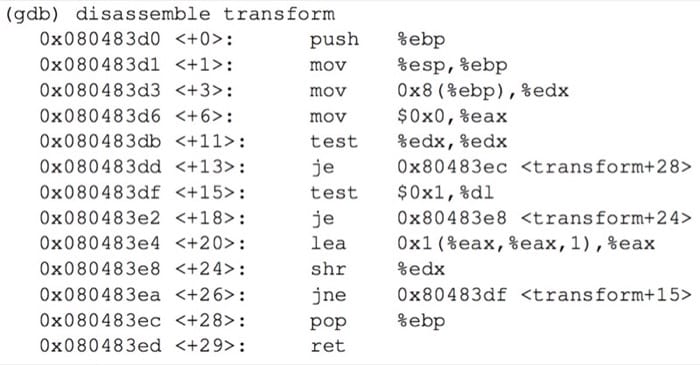
根据上面的信息,补充完整下面对应的程序代码:
unsigned transform(unsigned n){
    int b, m;
    for (m = __; _____; _____){
        b = ____;
        if (b == 0) {
            ______;
        }
        ______;
    }
    return m;
}
首先我们应该熟悉,这里 %eax 中存放的变量是 m,%edx 中存放的变量是 n。在 <+6> 这一行把 0x0 放到了 %eax 中,所以循环的初始条件是 m=0,然后 <+11> 这一句实际是判断 %edx 是否为 0,如果为 0,则跳转到 <+28>,所以终止条件是 n != 0。接着就是循环体里的内容,<+15> 用 %dl 和 0x1 做 & 操作,在汇编中结果会保存到对应的 flag 中,在代码中我们就保存到了 b 中,如果 b == 0,那么就跳转到 <+24>,进行移位操作,也就是循环操作为 n >>= 1,否则先要执行 <+20>,这一句实际上就是 m = m + m + 1,综上所述,就可以得到最终答案:
unsigned transform(unsigned n){
    int b, m;
    for (m = 0; n != 0; m >>= 1){
        b = n & 1;
        if (b == 0) {
            continue;
        }
        m = m + m + 1;
    }
    return m;
}
结构体的内存排列
假设我们有下面这个结构体
typedef struct {
    char a;
    long b;
    float c;
    char d[3];
    int *e;
    short *f;
} foo;
请给出具体的内存排列顺序。
首先我们需要知道每个数据类型所占据的字节数目,如下:
typedef struct {
    // 2 字节:short
    // 16 字节:long double
    char a;    // 1 字节
    long b;    // 8 字节(其他 8 字节的有 double, 指针)
    float c;   // 4 字节(其他 4 字节的有 int)
    char d[3]; // 1 x 3 字节
    int *e;    // 8 字节
    short *f;  // 8 字节
} foo;
所以具体的排列为(用 x 表示 padding 的字节)
a x x x x x x x b b b b b b b b
c c c c d d d x e e e e e e e e
f f f f f f f f
如果想要紧凑一点,其实可以进行对其,把 a, c, d 组合一下,如
a d d d c c c c b b b b b b b b
e e e e e e e e f f f f f f f f
这样就省了 8 个字节出来
结构体的访问
给出下面的结构体
struct confuse {
    char systems;
    long theory;
    struct applications {
        char web[3];
    } database;
    int *languages;
    struct confuse *math;
}
问题是,右边的汇编程序分别对应哪个函数:
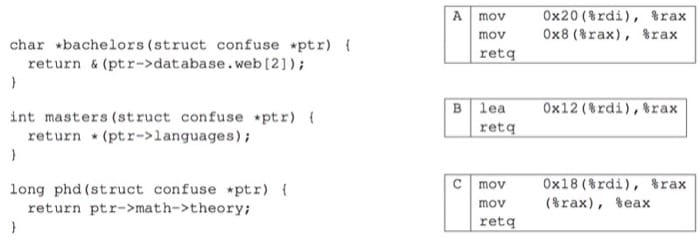
根据上一题,我们可以先画出具体的内存排列,用变量的首字母作为缩写,用 x 表示 padding:
s x x x x x x x t t t t t t t t
w w w x x x x x l l l l l l l l
m m m m m m m m
然后根据偏移量来数对应的变量即可,其中要注意的是十六进制转十进制的运算。比较简单,最后的对应为:
- A - phd
- B - bachelors
- C = masters
Switch 语句
我们先来看跳转表:
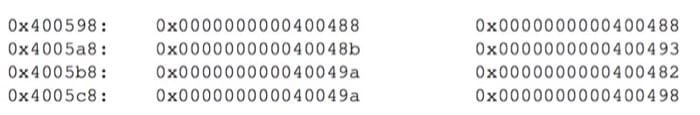
接着是汇编程序
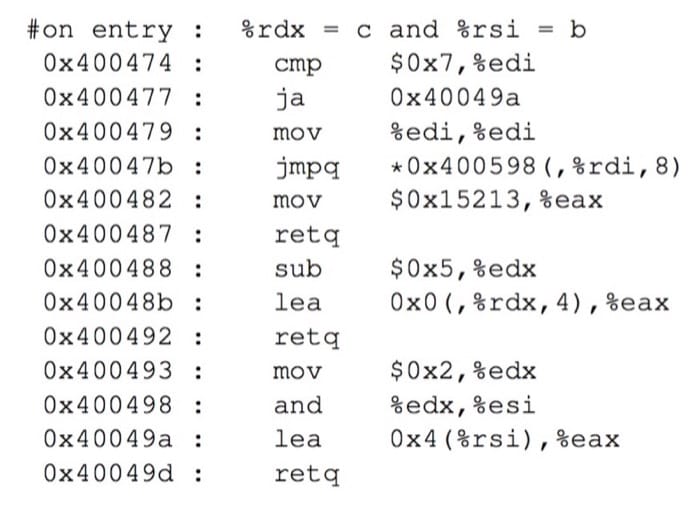
我们要做的是补充完整下面的程序:
int main(int a, int b, int c){
    int result = 4;
    switch(a) {
        case 0:
        case 1:
            _____;
        case 2:
            _____;
            break;
        case 5:
            result = ____;
            break;
        case 3:
            _____;
        case 7:
            _____;
        default:
            _____;
    }
    return result;
}
汇编程序中负责跳转的是 0x40047b jmpq *0x400598(, %rdi, 8),其中 %rdi 就是变量 a 的值,仔细观察跳转表和程序,可以发现一些规律:
- a 等于 0 或 1 的时候,做的事情是一样的,并且直到执行完 a 等于 2 的语句才会返回
- a 等于 5 时是一套独立的指令
- a 等于 3 和 7 时,做的事情类似,并且最后都会执行默认的命令
- switch 语句中有些有 break,有些没有
有了这些线索,就可以『翻译』对应的汇编代码了,答案如下:
int main(int a, int b, int c){
    int result = 4;
    switch(a) {
        case 0:
        case 1:
            result = c - 5;
        case 2:
            result = c * 4;
            break;
        case 5:
            result = 0x15213;
            break;
        case 3:
            c = 2;
        case 7:
            b = b & c;
        default:
            result = b + 4;
    }
    return result;
}
栈的应用
这一题主要考察函数调用时候压栈出栈以及栈指针和返回地址的理解,C 代码和对应的汇编代码为:
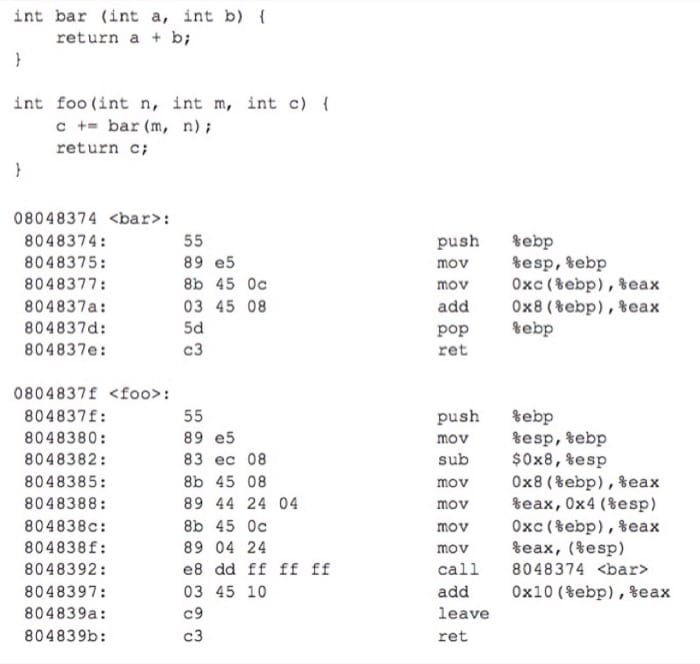
我们需要画出栈中的数据存放表示,具体的函数是 foo(3, 4, 5),注意要标志出 %ebp 的值
在调用 foo 函数时 %ebp 的值为 0xffffd858,调用 foo 的函数的返回地址是 0x080483c9
Stack      The diagram starts with the
addresss   arguments for foo()
           +-----------------------------------+
0xffffd850 |                5                  |
           +-----------------------------------+
0xffffd84c |                4                  |
           +-----------------------------------+
0xffffd848 |                3                  |
           +-----------------------------------+
0xffffd844 |      return addr 0x080483c9       |
           +-----------------------------------+
0xffffd840 |        old ebp 0xffffd858         |
           +-----------------------------------+
0xffffd83c |                3                  |
           +-----------------------------------+
0xffffd838 |                4                  |
           +-----------------------------------+
0xffffd834 |      return addr 0x08048397       |
           +-----------------------------------+
0xffffd830 |        old ebp 0xffffd858         |
           +-----------------------------------+
我们来看看这题要怎么做。首先,老师还是很贴心的给出了第一个参数在栈中的位置,不过开始之前还是先要弄明白我们到底需要在栈中放什么东西。首先是函数的参数(倒着放,这样第一个参数才能先弹出来),然后是返回值地址和旧的 %ebp 指针,这俩是为了告诉指令该去哪,以及栈要去哪的。
所以答案就呼之欲出了,前三个简单,543 一路下来即可;接下来是返回地址,也就是题目给出的初始条件;再下来是题目给出的初始 ebp;接着是调用 bar 函数的栈排列,也还是参数,但是这里题目是换了顺序的,所以先 3 后 4;然后是返回值地址,找到汇编代码中 call 的下一句,就是它了;最后一句可有可无,不过为了清晰 ebp 的做用,还是写上,应该指向旧的 ebp 地址,也就是 0xffffd840,至此,题目完成。