深入理解计算机系统 第 15 课 System Level I/O
本页目录
了解完了 Exceptional Control Flow,我们再来看看系统级 IO 的相关内容,完成这一课之后,就可以开始写我们自己的 shell 程序了。
Unix I/O
在 Linux 中,文件实际上可以看做是字节的序列。更有意思的是,所有的 I/O 设备也是用文件来表示的,比如:
./dev/sda2(/usrdisk partition)/dev/tty2(terminal)
甚至连内核也是用文件来表示的:
/boot/vmlinuz-3.13.0-55-generic(kernel image)/proc(kernel data structures)
因为 I/O 设备也是文件,所以内核可以利用称为 Unix I/O 的简单接口来处理输入输出,比如:
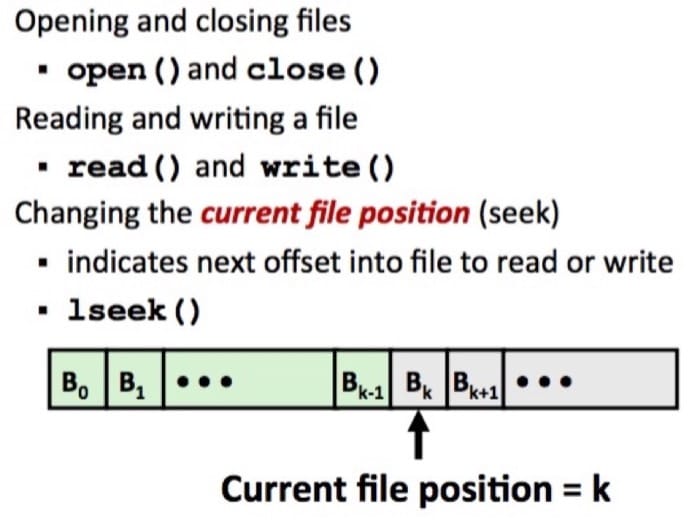
为了区别不同文件的类型,会有一个 type 来进行区别:
- 普通文件:包含任意数据
- 目录:相关一组文件的索引
- Socket:和另一台机器上的进程通信的类型
其实还有一些比较特别的类型,但是这里提一下,不深入了解:
- Named pipes(FIFOs)
- Symbolic links
- Character and block devices
Regular File
普通的文件包含任意数据,应用一般来说需要区分出 text files 和 binary files。文本文件只包含 ASCII 或 Unicode 字符。除此之外的都是 binary files(object files, JPEG images, etc)。对于内核来说其实并不能区分出个中的区别。
文本文件就是一系列的文本行,每行以 \n 结尾,新的一行是 0xa,和 ASCII 码中的 line feed 字符(LF) 一样。不同系统用用判断一行结束的符号不同(End of line, EOL),如:
- Linux & Mac OS:
\n(0xa)- line feed(LF)
- Windows & Internet protocols:
\r\n(0xd 0xa)- Carriage return(CR) followed by line feed(LF)
目录
目录包含一个 link 数组,并且每个目录至少包含两条记录:
.(dot) 当前目录..(dot dot) 上一层目录
用来操作目录的命令主要有 mkdir, ls, rmdir
目录是以树状结构组织的,根目录是 /(slash)
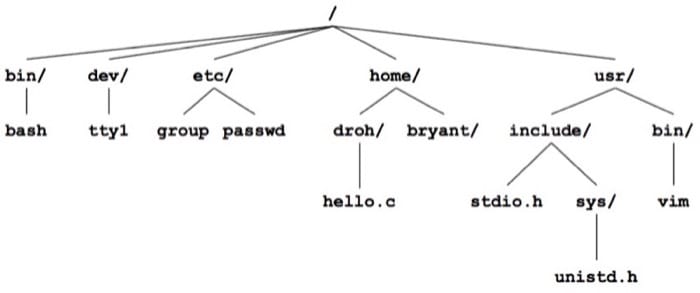
内核会为每个进程保存 current working directory (cwd),可以用 cd 命令来进行更改。
我们通过路径名来确定文件的位置,一般分为绝对路径和相对路径。
操作文件
接下来我们了解一下基本的文件操作。
在使用文件之前需要通知内核打开该文件:
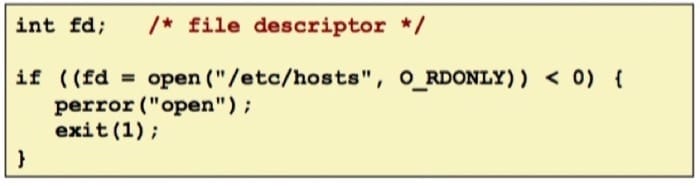
返回值是一个小的整型称为 file descriptor(如果这个值等于 -1 则说明发生了错误)。每个由 Linux sheel 创建的进程都会默认打开三个文件:
- 0: standard input(stdin)
- 1: standard output(stdout)
- 2: standar error(stderr)
使用完毕之后同样需要通知内核关闭文件:
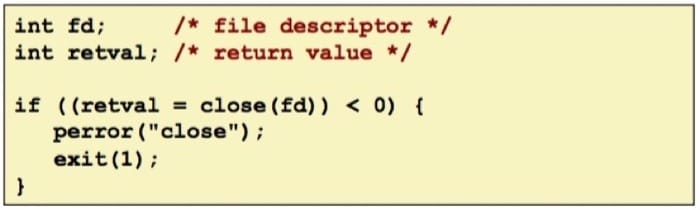
如果在此关闭已经关闭了的文件,会出大问题。所以一定要检查返回值,哪怕是 close() 函数(如上面的例子所示)
在打开和关闭之间就是读取文件,实际上就是把文件中对应的字节复制到内存中,并更新文件指针:
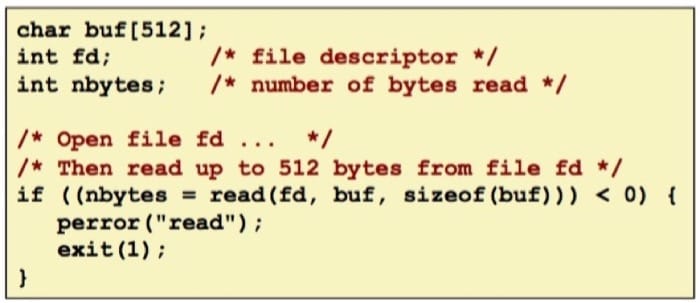
返回值是读取的字节数量,是一个 ssize_t 类型(其实就是一个 signed integer),如果 nbytes < 0 那么表示出错。nbytes < sizeof(buf) 这种情况(short counts) 是可能发生的,而且并不是错误。
写入文件是把内存中的数据复制到文件中,并更新文件指针:
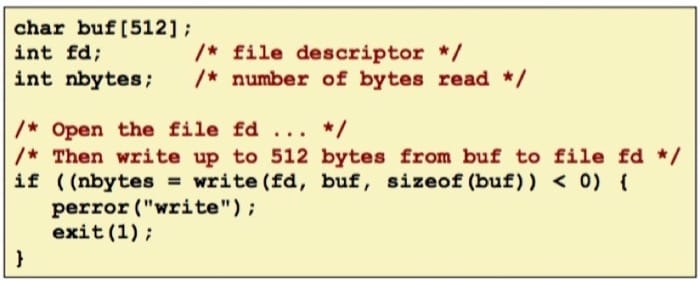
返回值是写入的字节数量,如果 nbytes < 0 那么表示出错。nbytes < sizeof(buf) 这种情况(short counts) 是可能发生的,而且并不是错误。
综合上面的操作,我们可以来看看 Unix I/O 的例子:
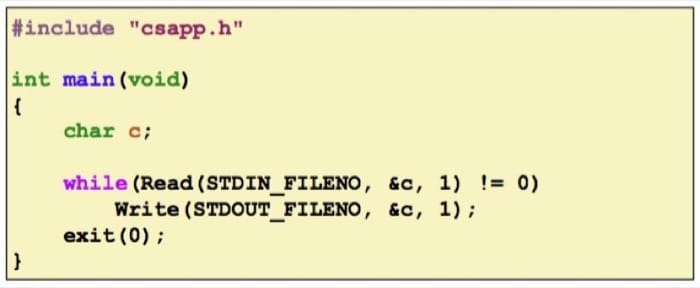
前面提到的 short count 会在下面的情形下发生:
- 在读取的时候遇到 EOF(end-of-file)
- 从终端中读取文本行
- 读取和写入网络 sockets
但是在下面的情况下不会发生
- 从磁盘文件中读取(除 EOF 外)
- 写入到磁盘文件中
最好总是允许 short count,这样就可以避免处理这么多不同的情况。
Robust I/O
RIO 实际上就是一个包装,用来在不同的应用中提供强壮的 IO 接口,主要有一下两类:
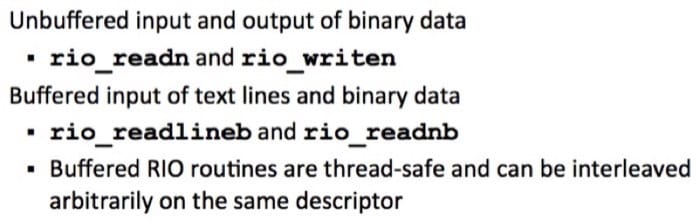
可以从这里 中下载(src/csapp.c 和 include/csapp.h)
无缓存的输入输出和 Unix 的 read 和 write 接口一致,如果要通过 network sockets 来传输数据,就非常拥有了:
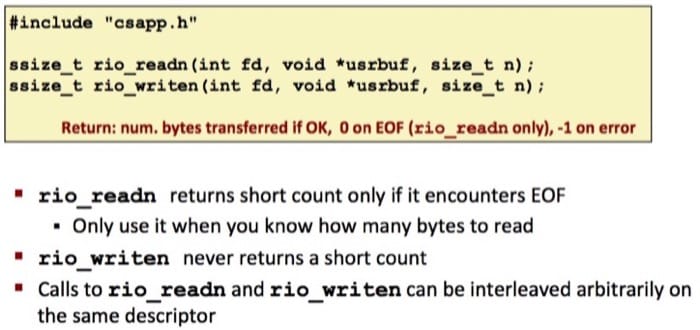
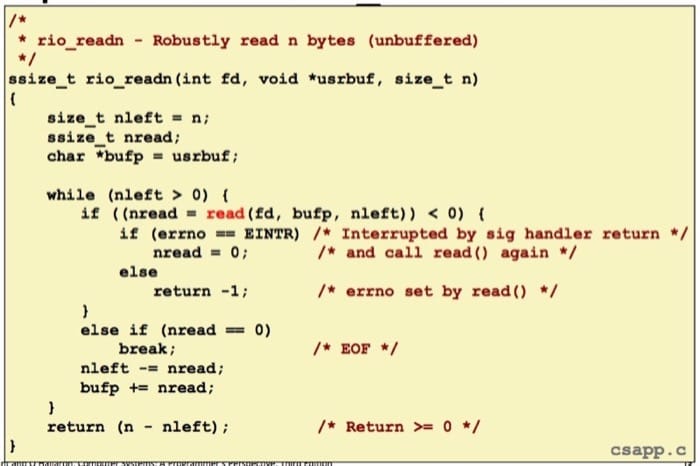
具体的实现是:
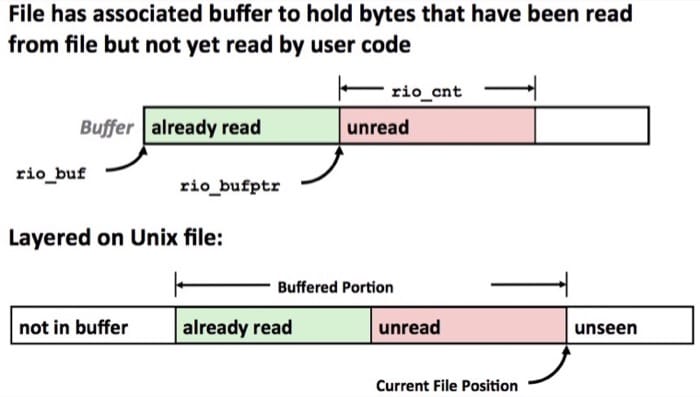
有缓存的输入在从文件中读取数据的时候通过内置的内存缓冲区提高效率:
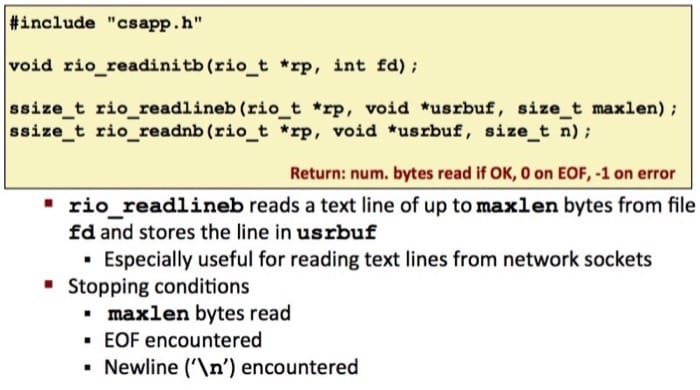
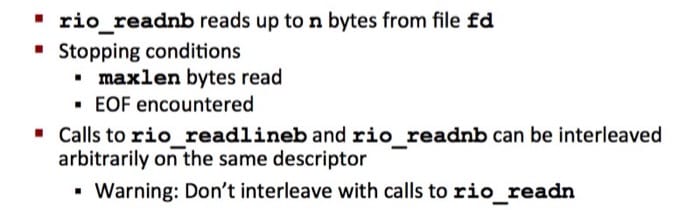
具体的实现如下:
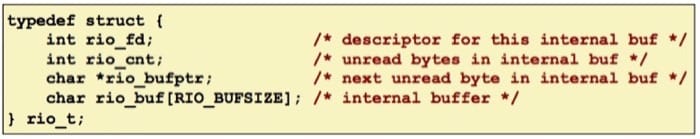
对应的结构体是:
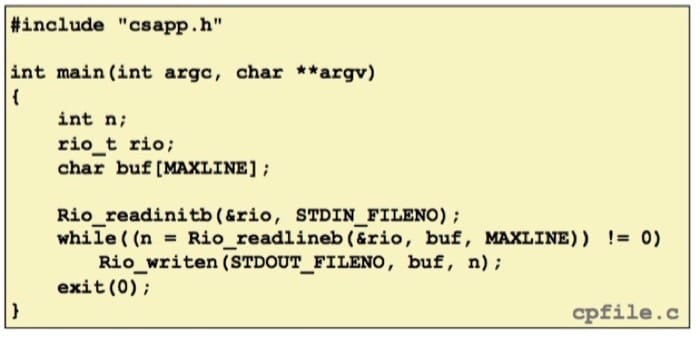
这是一个对应的例子:
Metadata, Sharing & Redirection
元数据是用来描述数据的数据,由内核维护,可以通过 stat 和 fstat 函数来访问,其结构是:
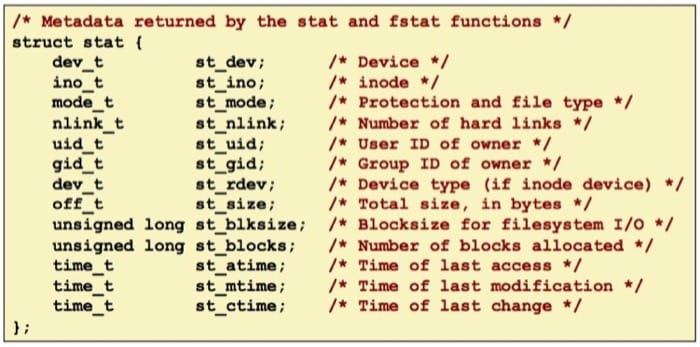
对应的访问例子:
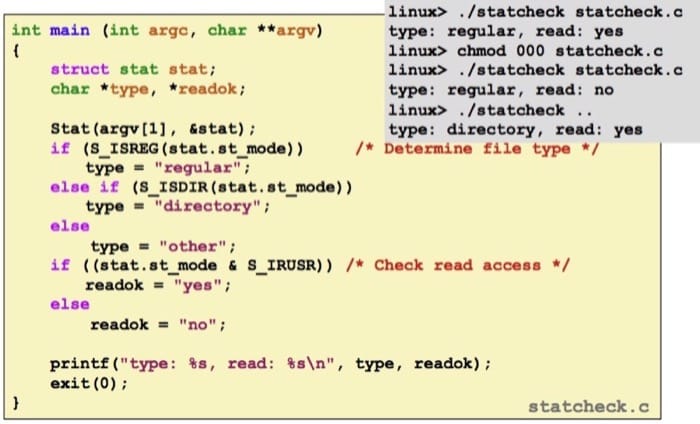
了解了具体的结构之后,我们来看看内核是如何表示打开的文件的。其实过程很简单,每个进程都有自己的 Descriptor table,然后 Descriptor 1 指向终端,Descriptor 4 指向磁盘文件,如下图所示:
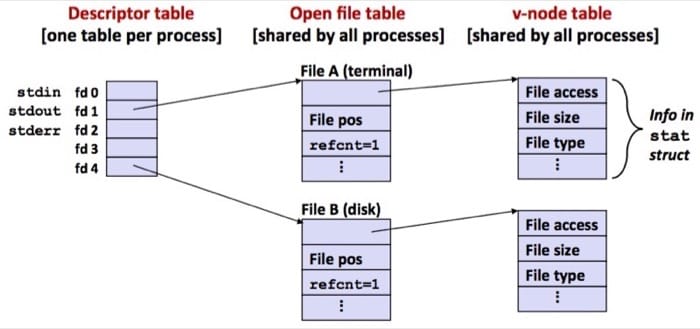
两个不同的 descriptors 通过两个不同的 open file 记录来共享同一个磁盘文件(对应指向同一个 v-noe table)。
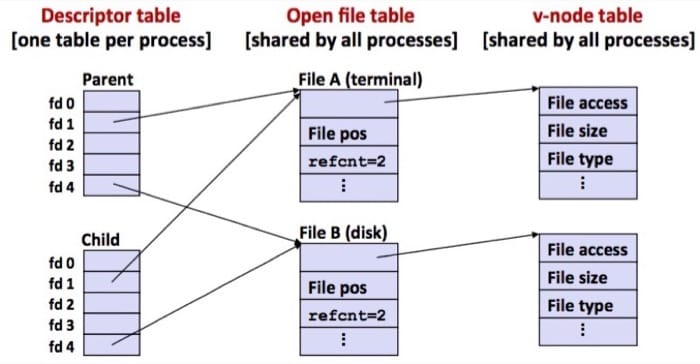
这里有一个需要说明的情况,就是使用 fork。子进程实际上是会继承父进程打开的文件,在调用 fork 之前,我们假设情况是这样的:
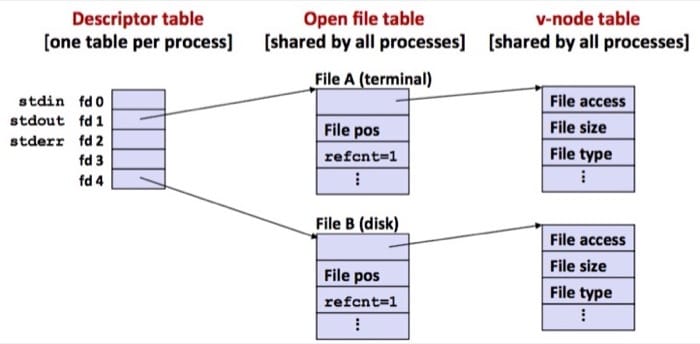
在 fork 之后,子进程实际上和父进程的指向是一样的,这里需要注意的是会把 refcnt 加上 1(也就是引用计数加 1)
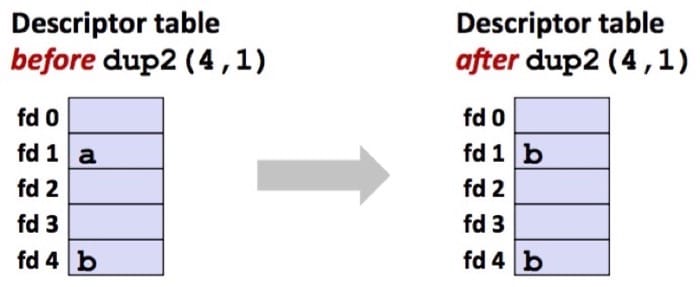
了解了这个,我们我们就可以知道所谓的重定向是怎么实现的了。其实很简单,只要调用 dup2(oldfd, newfd) 函数即可。具体如下:
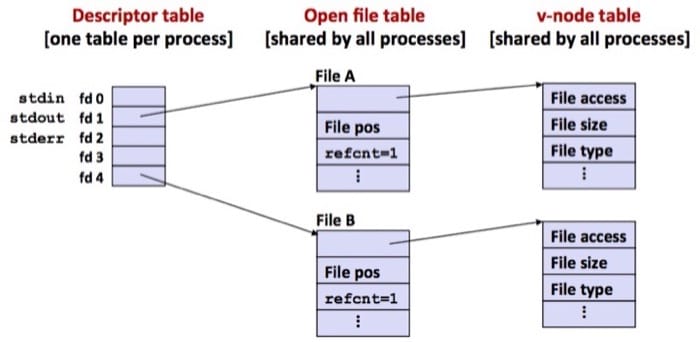
Step #1: open file to which stdout should be redirected(happends in child executing shell code, before exec)
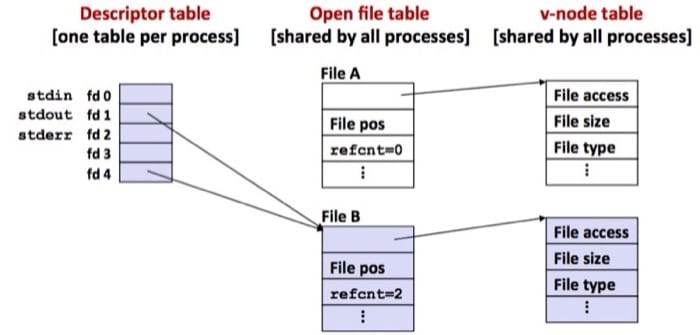
Step #2: call dup2(4,1) -> cause fd=1(stdout) to refer to disk file pointed at fd=4
Standar I/O
C 标准库中包含一系列高层的标准 IO 函数,一些具体的函数:
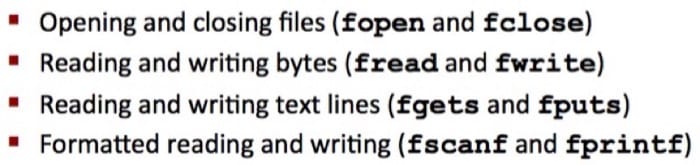
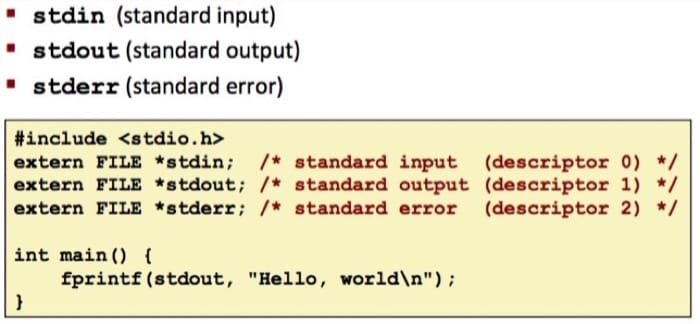
标准 IO 会用流的形式打开文件,所谓流(stream)实际上是 file descriptor 和 buffer 在内存中的抽象。C 程序一般以三个流开始,如下所示:
接下来我们详细了解一下为什么需要使用缓冲区,程序经常会一次读入或者写入一个字符,比如 getc, putc, ungetc,同时也会一次读入或者写入一行,比如 gets, fgets。如果用 Unix I/O 的方式来进行调用,是非常昂贵的,比如说 read 和 write 因为需要内核调用,需要大于 10000 个时钟周期。
解决的办法就是利用 read 函数一次读取一块数据,然后再由高层的接口,一次从缓冲区读取一个字符(当缓冲区用完的时候需要重新填充),例如:
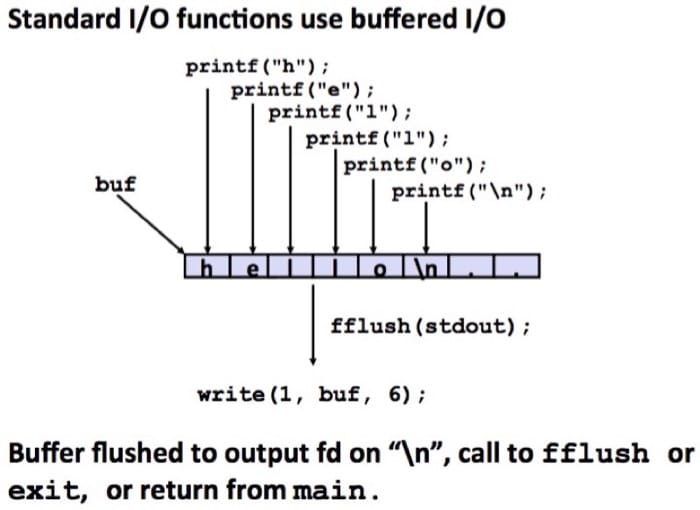
具体来看看这个例子:
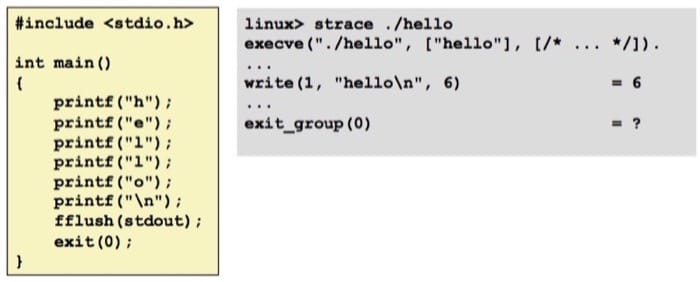
注意右边的输出,实际上只写入了一次,一次六个字符,而不是程序中写的六次(这里好好感受下)
总结
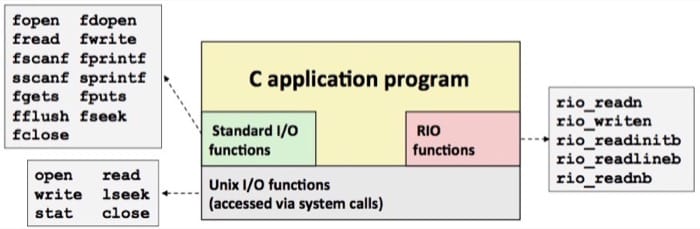
前面介绍了几种不同的 IO,它们的层级如下所示:
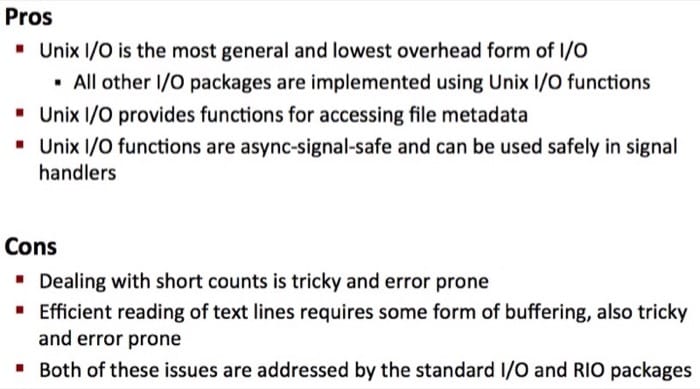
Unix I/O 的优劣:
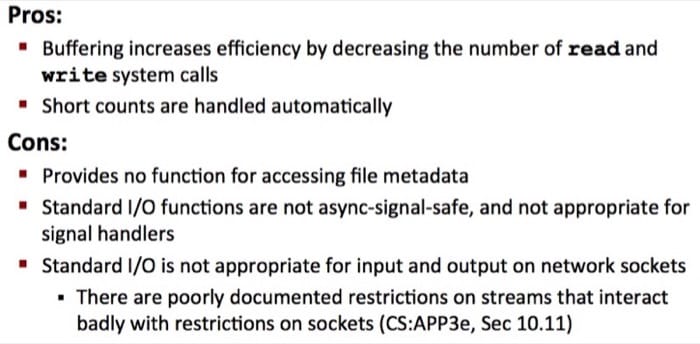
Standard I/O 的优劣:
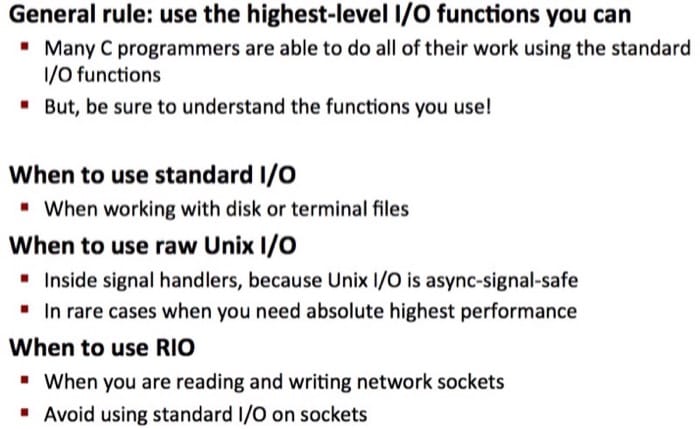
具体的选择建议为:
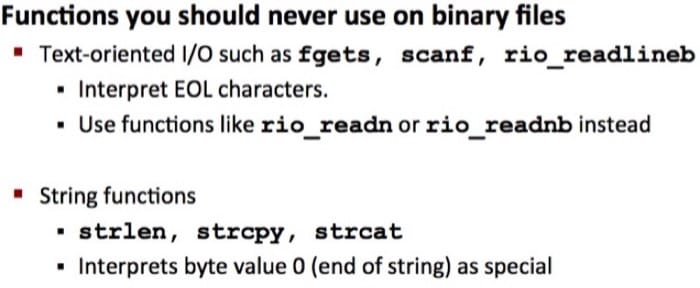
最后是处理 binary files 的守则: