前面我们接触了两层的浅层神经网络,这节课我们来看看深层神经网络。
更新历史
深层神经网络 Deep L-layer neural network
神经网络的层数定义是从左到右,由 0 开始定义,x123 为第 0 层,比如:
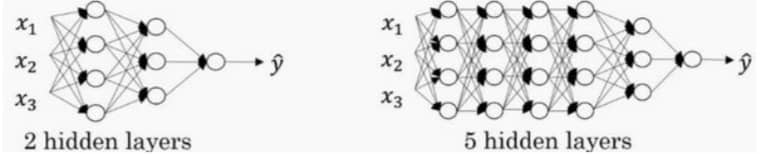
具体的符号表示,参考第 0 节的介绍。
前向/反向传播 Forward and backward propagation
废话不多说,直接上公式
前向传播
- 输入 a[l−1]
- 输出 a[l],同时缓存 z[l],方便后续计算
具体步骤为:
z[l]=W[l]⋅a[l−1]+b[l]a[l]=g[l](z[l])
向量化的实现为
Z[l]=W[l]⋅A[l−1]+b[l]A[l]=g[l](Z[l])
反向传播
- 输入 da[l]
- 输出 da[l−1], dw[l], db[l]
具体步骤为:
dz[l]=da[l]∗g[l]′(z[l])
dw[l]=dz[l]⋅a[l−1]
db[l]=dz[l]
da[l−1]=w[l]T⋅z[l]
dz[l]=w[l+1]Tdz[l+1]⋅g[l]′(z[l])
向量化实现为
dZ[l]=dA[l]∗g[l]′(Z[l])
dW[l]=m1dZ[l]⋅A[l−1]T
db[l]=m1np.sum(dz[l],axis=1,keepdims=True)
dA[l−1]=W[l]T⋅dZ[l]
为什么深层表示好 Why deep representations
因为前几层能学习一些低层次的简单特征,后几层会把简单的特征结合起来,去探测更加复杂的东西。
参数(Parameters) vs 超参数(Hyperparameters)
超参数包括:
- 学习率 learning rate
- 梯度下降法循环次数 iterations
- 隐藏层数目 L
- 隐藏层单元数目 n[l]
- 选择的激活函数
这些超参数实际上决定了神经网络最终训练得到的参数的值
如何寻找最佳的超参
不断尝试 Idea - Code - Experiment - Idea 这个循环,简单来说就是爱迪生实验灯丝。很大程度凭借经验和直觉调整参数,多试试,才能培养这种直觉