数据平台技术指南
本页目录
最近大部分精力花在为公司搭建统一的数据平台上,从技术选型到最终落地像打通隧道一样艰难和痛快,本文主要介绍数据平台的技术相关实践与思考。具体的设计思路可以参考我的另一篇文章 - 数据平台设计指南
更新历史
- 2016.10.2: 完成初稿
数据平台的解决方案有很多,从数据仓库到现在最火的 Hadoop/Spark,随着开源运动的蓬勃发展,几乎各个组件都有足够多的项目供开发者选择。虽然不需要自己做轮子了,但是如何选择合适的轮子拼成最高效的车子,仍然需要技术团队谨慎选择。
尤其是不同的团队不同的风格不同的业务需求,不太存在一劳永逸的做法,无论是架构还是功能,都应该保证螺旋上升的趋势,以应对各种突发情况。
注:本文不涉及数据平台的设计思路,感兴趣请参考 数据平台设计指南
技术选型
为了方便后文的叙述,先简要介绍一下背景。数据平台项目原先只是我们部门内部的一个项目,和我之前接手的日志项目基本处于并行的状态。数据平台项目和日志项目唯一的连接点在于数据的存储,共用一个 Elasticsearch 集群。
日志这边最初的架构是利用 Rsyslog + Logstash 直接把日志汇总到 Elasticsearch(后面用 ES 表示) 中。而数据平台的后端原先是基于 Ruby On Rails(后面用 RoR 表示) 的,功能也比较简单,一方面是利用 ES 的聚合来进行基本的日志数据收集,另一方面是从第三方的统计服务中(比如 Google Analysis)拉取数据,给前端进行展示。
在已有系统的基础上进行改动和完全从头开始搭建是两种完全不同的思路。虽然说从零开始几乎不受任何束缚,但实际情况中基本不太可能立马推倒重来,毕竟已有系统虽然比较简陋,至少还在服役中。于是只能一个模块一个模块进行调整,一是保证服务稳定,二是在人力不够的条件下,防止步子太大出问题。
所以在重构一开始,我给自己的设计定下的目标是:
- 尽量小的改动(影响面越小,可能出的问题就越少)
- 尽量就近服务(因为要提供全球范围内的服务,需要尽量优化线路)
- 减少跨机房数据同步量(尤其是跨海传输,带宽和稳定性所带来的额外成本很令人头疼)
在经历了一系列技术测试之后(详情见最后的链接),由我确定了日志部分的架构,而数据平台部分的架构由我的同事确定,后台部分最终选择的技术是:
ELK Stack + Kafka + Spring MVC
细节与原因如下:
- ELK Stack 在业界的实践中已被证明是比较靠谱的日志解决方案,加上原来的日志系统就已经采用了 ELK 方案,改动的成本较低
- 用 Logstash 取代了原先采用的系统级的 Rsyslog 用来传输日志,方便管理和配置(Logstash 的配置还是非常好写的)
- 加入了 Kafka 用作消息队列,把 Logstash 与 Elasticsearch 解耦,所有日志会先经过 Kafka,再由 Kafka 导入 Elasticsearch
- 出于性能考虑和其他一些因素的考虑,用基于 Java 的 Spring MVC 取代 Ruby on Rails,虽然 RoR 的开发效率很高,但是我和另一个核心开发人员都不熟悉 Ruby,所以转为 Java(至少好招人)
总体来说,整个架构的调整需要考虑的因素很多,除了开发团队的技术栈外,更多是投入和产出的权衡。很多时候能争取到的资源非常有限,就需要想办法巧妇做少米之炊了。
架构
虽然前面提到的技术不多,但因为全球部署和全球服务的缘故,架构图还是有一些复杂的。理论上完美的方案,实际落地的时候会出现各种各样的因为物理因素导致的问题。这也是为什么要一个一个地区和市场去推进,不然不断涌现的各种问题,在人力不足的时候会把团队拖入『死亡进军』的状况。架构图做了一定化简(只有中、美两机房),具体如下:
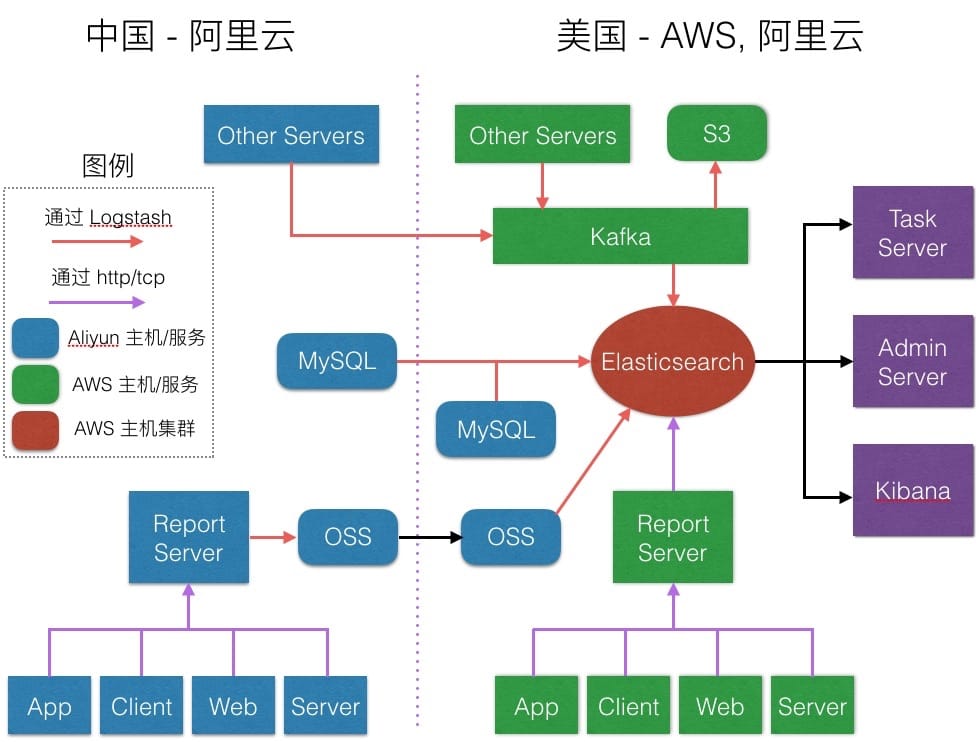
围绕着以 ES 集群为存储核心,整个系统主要分三大块:
- 日志收集与分析
- 埋点上报与数据接入
- 数据与日志统计与分析
因为采用了不同地区的不同服务提供商,还需要兼顾数据同步的问题,整个系统经过不断演化,最终达到了如上图所示的比较稳定的结构。不过由于我手头上的事情实在太多,具体的数据量、用户量、消息量评估只完成了最基本的部分。目前的重心主要还是在系统的完善与功能添加中,很多技术债是在人力不足的情况下不得不背的,对于我和另外一个同事这样的强迫症来说,只能尽量多做一点是一点了。
最后再强调一次,数据是拿来用的,一定要跟各个部门深入沟通好需求,并在不断磨合中找到让大家都最舒服的合作方式。很多技术和架构选择都是非常业务相关的,这里就不多提了。后面主要讨论的会是『如何让整一个系统流畅运行起来』这个问题
流程
这一部分主要是介绍 数据平台设计指南 中提到的四个主要流程的具体实现和相关思路。
采集与预处理
- 日志的收集要跟不同团队的开发人员对接,了解真正有价值的参数,减少带宽与存储的消耗(毕竟日志中会有大量的冗余)
- 提取日志中真正有价值的东西
- 分词问题,string 字段要在 logstash 阶段就要设置为
not_index - 数据上报系统采用 ID 与密钥配对方式进行有效性校验,并且利用另外的数据库做权限控制,具体需要做到的粒度可以根据需求进行控制
- 做多机房同步的时候尽量利用云服务本身提供的服务,自己做数据同步很辛苦,得不偿失
- 不同的服务要有流量和数据量控制,保证不因为单个系统的不稳定而拖挂整个系统
- 不同数据源如何对齐,公共字段需要仔细设置
- 写日志的时候就要考虑未来的处理和应用,尤其是和已有数据源的对齐
- 字段同名但类型不同导致的索引冲突问题
- 设计埋点及统计字段时一定要基于具体的统计需求,不能为了打点而打点,字段是什么,后面要如何使用,不同的字段如何联系与互动,都需要事先想好
- 专注于核心指标,不同指标的优先级是什么
- 界面、事件和事件参数独立,但必须有公共的统计参数(最好两个一上,冗余保证后续数据清洗及验证的准确性)
- 维护埋点,增加上报的信息量(同样大小的前提下),减少上报压力
整个 ETL 过程需要建立固定的流程,为开发者准备好对应的接口、文档及测试系统。对于老数据的导入也需要有自动化可重复的工具链。而对于需要内网才能访问的系统,可以考虑在内网假设服务,然后走数据上报的流程进行数据汇总。
清洗与分类
这一层主要是进行分发与过滤,利用 Logstash 和 Kafka 的诸多特性,不需要写很多代码就可以完成。一些考虑有:
- 根据服务区分 Kafka 中不同的 topic,来进行隔离,虽然是同一管道,但是也要尽量避免相互影响
- 日志中可能有的非法字符以及过长的日志需要进行过滤,不然进入 ES 可能会导致问题
- 需要有定期任务机制,清理不需要的数据,保存到 S3 这种比较便宜的存储中
- 贯彻二八原则,20% 最有价值的数据进行结构化存储,剩下的以文本形式保存在云存储中,除非必要时,一般不需要动
因为不需要跟外部系统交互,这部分其实需要做的东西不算太多,但是作为最重要的中转站,需要保证高可用性,这就需要对各个组件有一定深入了解了。
存储与查询
基于 Luence 的 ES 集群在处理中文的时候可能有坑,不过目前 IK 分词基本可以满足需求。其他需要注意的有
- ES 集群的监控一定要做,要好好做,可以采用业界流行的方案,也需要了解 ES 的基本 API 和相关设置。
- 如果可能的话,尽量多配几台机器,可以由专门的机器做不负责存储只负责调度的主节点以及只负责存储及查询的数据节点,具体需要根据需求进行调整
- 很多暴露出来的问题,回归到最初都是因为存的时候太随意导致的,还是那句话,即使是类似 NoSQL 的存储,好的设计仍然无比重要
- 监控部分需要和运维密切配合,以达到快速反应,保证服务质量的目的
- 安全是非常重要的话题,内部系统的好处在于可以用白名单与二次验证的机制保证数据安全,具体的备份策略也需要仔细斟酌,找到一个平衡
展示与应用
这部分主要是前端展现与后端数据挖掘,这两部分涉及的话题太多,这里就不展开了,简单说一下。
- 数据可视化的核心在于目标明确,而这个目标怎么找到,一定是和相关业务部门沟通出来的,不能是开发人员拍脑袋
- 需要结合不同部门之前的业务实践,走之前提到了『取代-超越』两步战略
- 随着数据量的增大,可以结合 Spark/Hadoop 等分布式计算框架来进行数据挖掘,当然,这是比较后面的工作了,可能需要专门找人来负责
总结
在数据平台的建设中,总是会有各种各样的小问题,我的感受是临时的补丁不是不能打,但是一定要及时找出问题的根源,从系统的层面解决掉,不然补丁好修复,但是补丁的补丁,甚至补丁的补丁的补丁一多,很容易造成几乎无解的局面。
而对于系统中使用的相关技术,也一定要在『会用』的接触上深入理解其工作原理和运行机制,不需要深入到代码级别,但至少要能在出了问题之后第一时间有基本的排查思路,不然依靠 google 和 stackoverflow 编程,只会给同事带来巨大的困扰。
当然,本文只是目前我的一些想法,会随着系统的开发不断更新内容。如果大家有做过相关系统的经验,欢迎共同讨论,如果在深圳的话,可以约出来吃个饭聊一聊嘛。
相关文档
相关文章
- 【大数据架构之旅】5 黄金搭档 Dagster 与 DBT2023-07-04
- 【大数据架构之旅】4 上手实践 dagster2023-07-02
- 【大数据架构之旅】3 从零起步学 dagster2023-06-16
- 【大数据架构之旅】2 从零起步学 dbt2022-11-18